AI这一年:从Vibe Coding到AI全链路工作流
TL;DR
这一年,我从让 AI 写代码,折腾到裁 SDK、查 Oncall、做游戏。忙得最多的,是补它缺的上下文、工具和反馈,让它能自己跑、自己验。
- 让 AI 写好代码:补齐编译和运行反馈,直播裁剪十天裁掉百万行代码,跑通第一个带反馈的 Loop;再泛化成 iLoop,用 VDD 让验收有标准、结论有证据。
- 让 AI 干代码之外的活:接通看板、发布、实验等平台,让 AI 用证据逐轮排查 Oncall;再把需求、设计、实现和验收接起来,做游戏是一次从想法到上线的完整实践。
- AI 的更多可能:改 Harness、重做顺手的软件,试 Voice Coding、玩硬件,再用 me-context 让 AI 更了解自己,把它用到更多工作和生活里。
背景
我本职是一个 iOS 开发。面对日新月异的基模升级,被迫卷进了 AI 转型的浪潮中,经历过迷茫,也踩过不少坑。
今年7 月开始在内部分享业务中遇到的AI问题,得到了不少鼓励。所以这次想把这一年在 AI 上的七七八八做个总结,看看能不能给大家答疑解惑。
这篇也算给我在这里折腾 AI 的这段日子,留个记录。后面的探索还会继续。也谢谢这一年愿意听我分享、给我鼓励的同事。
总体阶段与架构
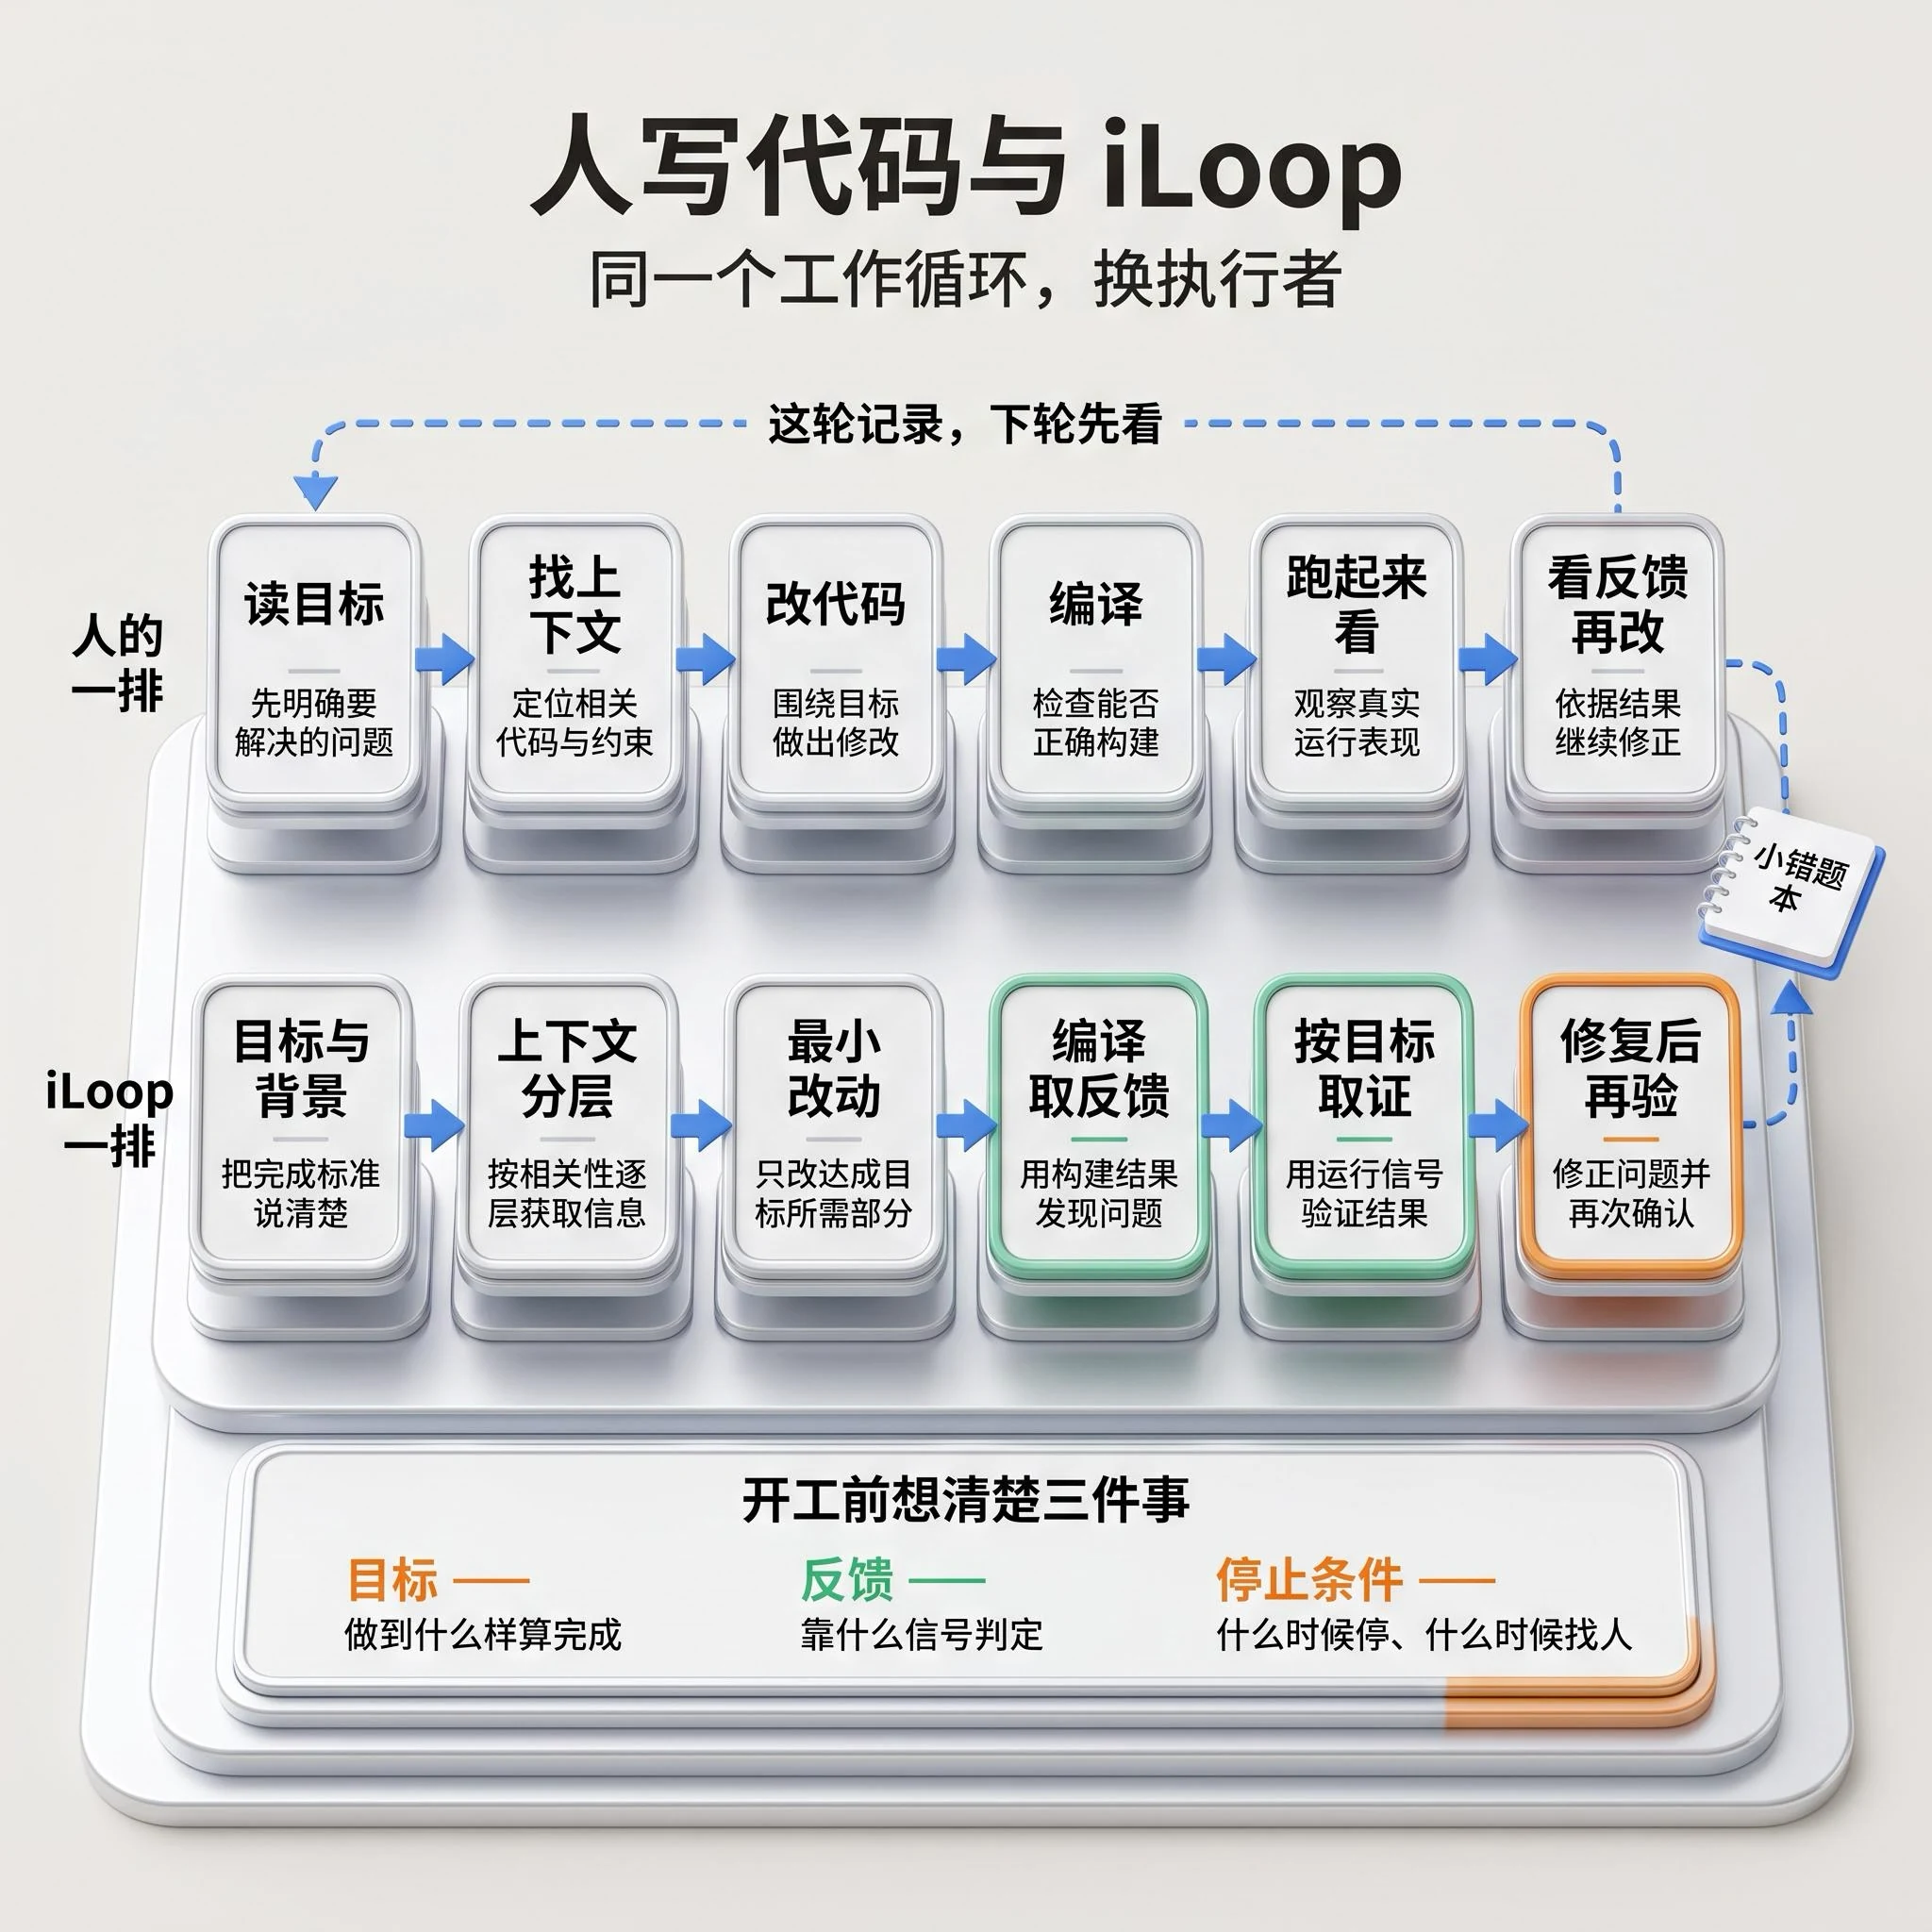
很多时候都是事情推着人走,边改边优化。有时候实在没思路,就套用“仿生学”,学习人类程序员是怎么解决这些问题的,然后再抽象给AI。
一路积累了不少文章和工具。有的技能已经有几千人在用,也收到了不少反馈。
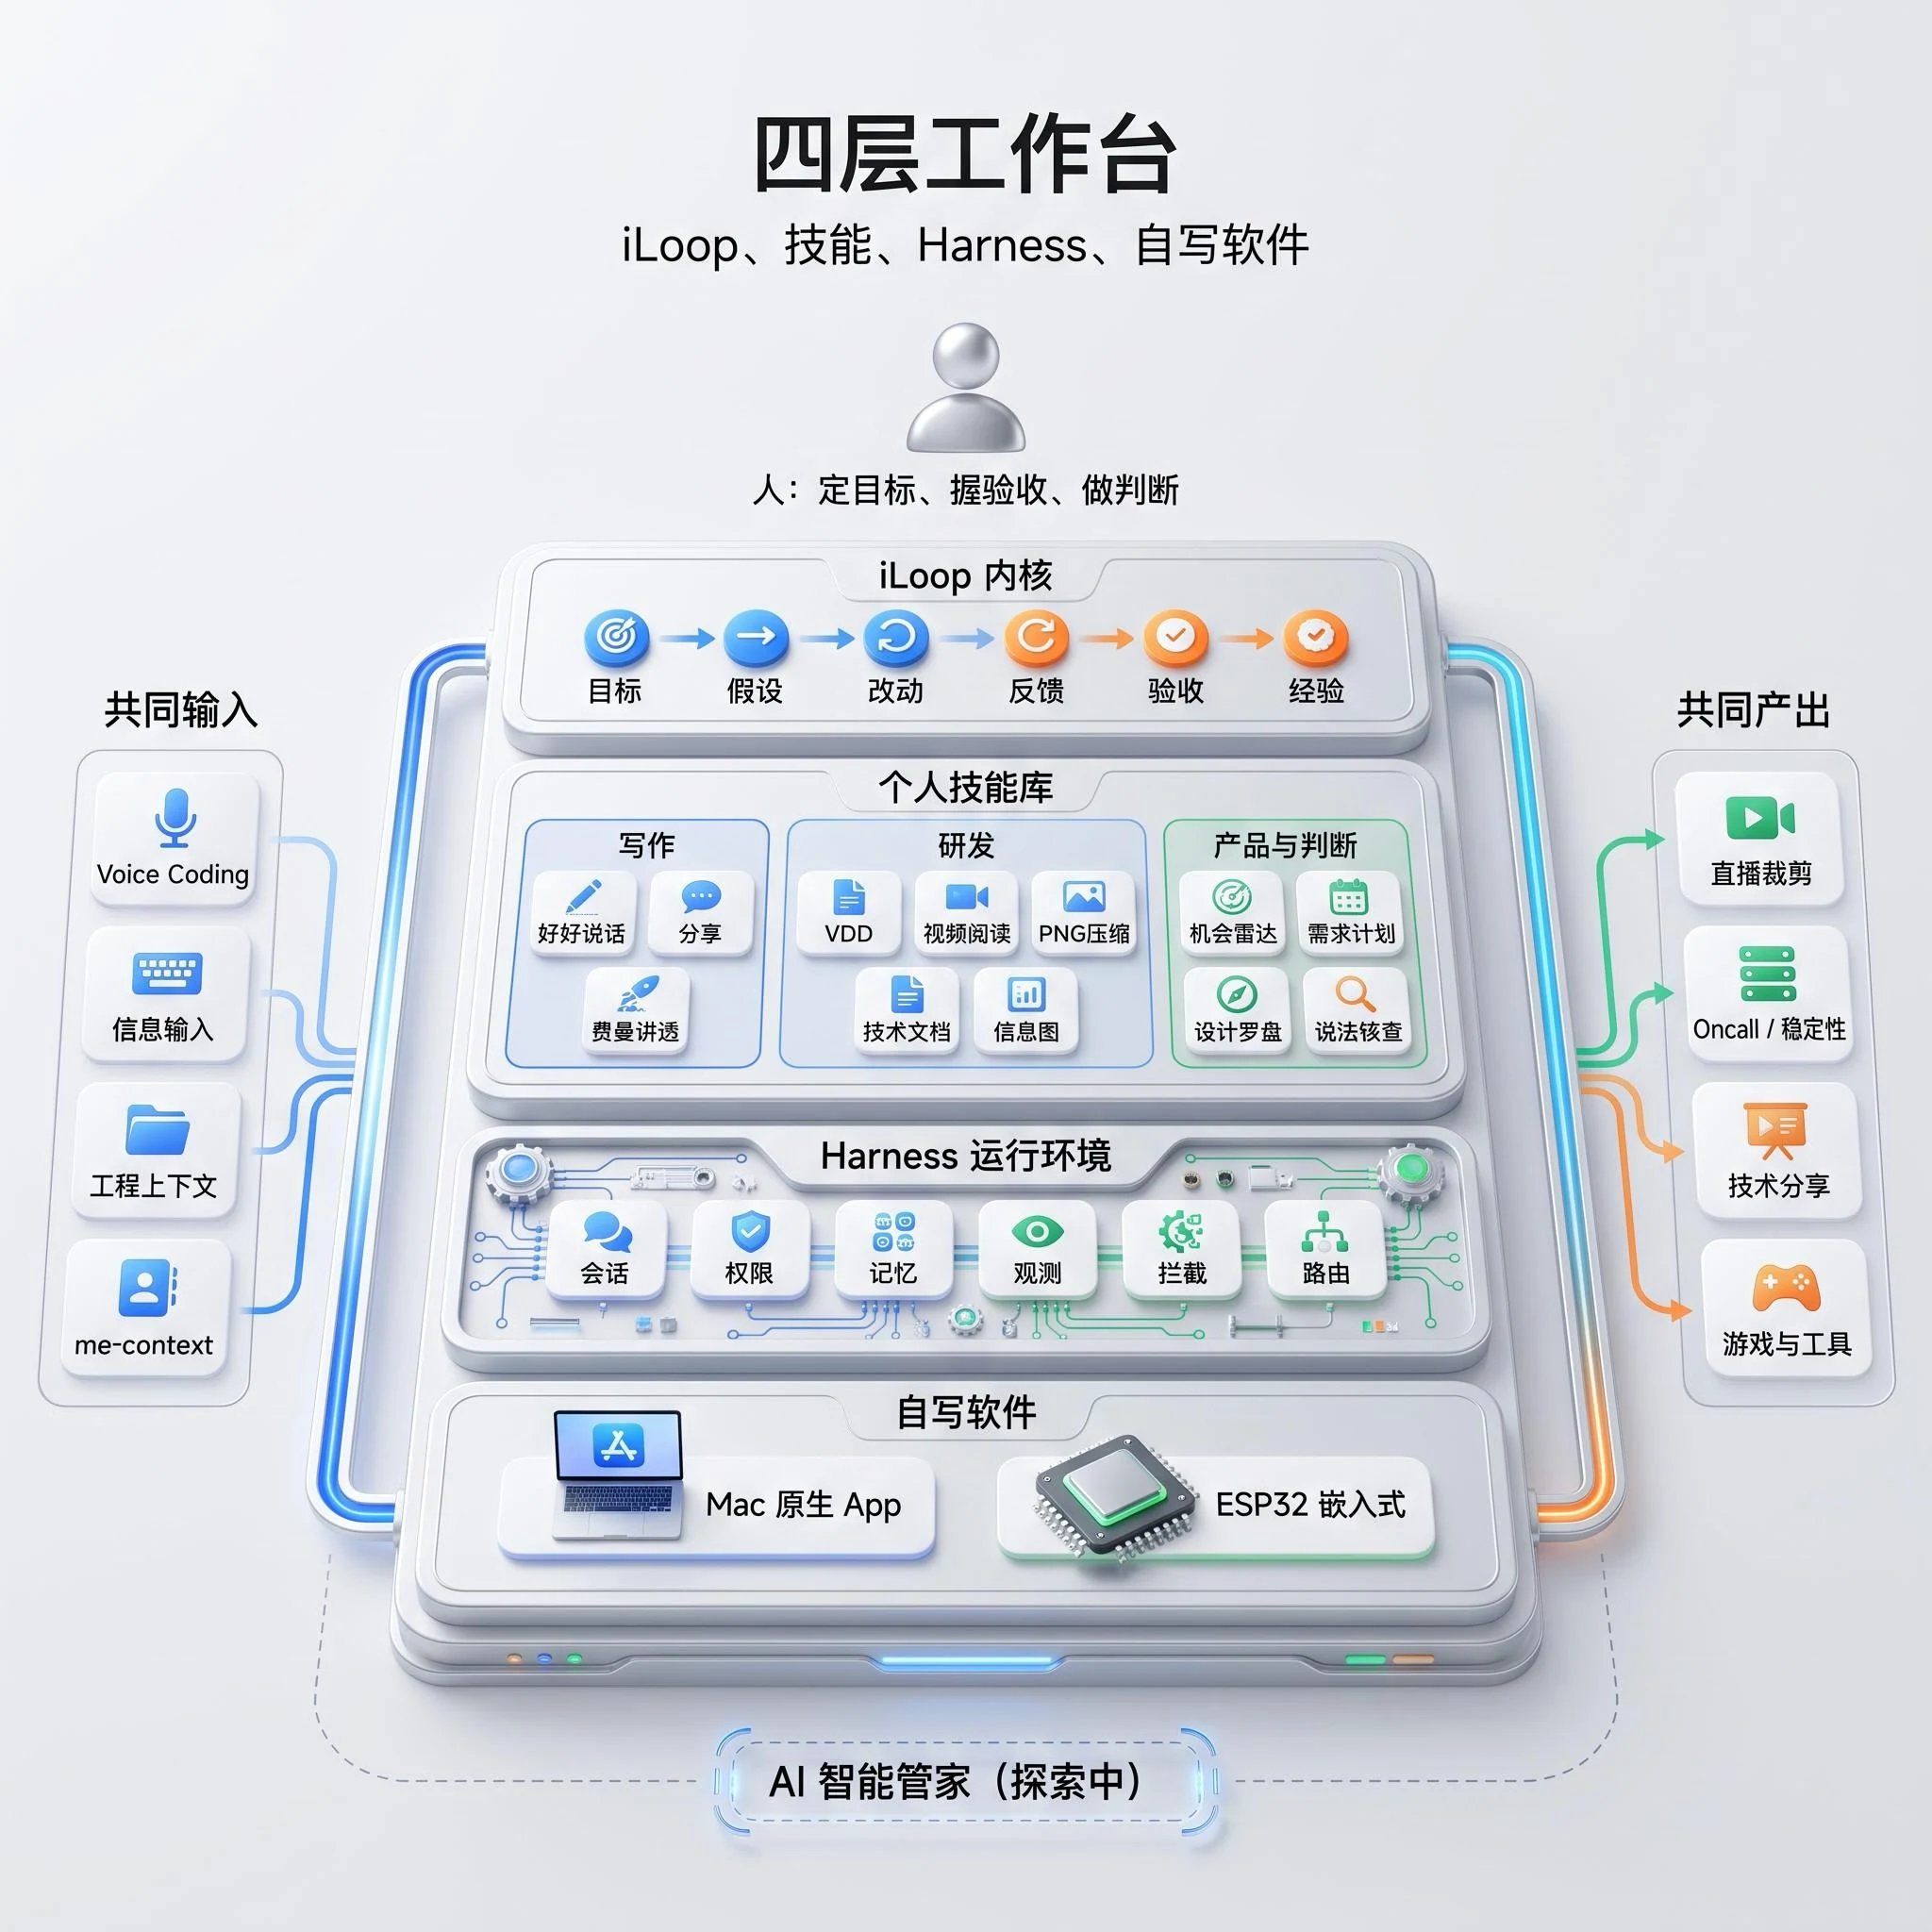
细数自己从去年开始尝试 AI 写代码到现在,过程上大概经历了八个阶段,最终的整体架构如下:
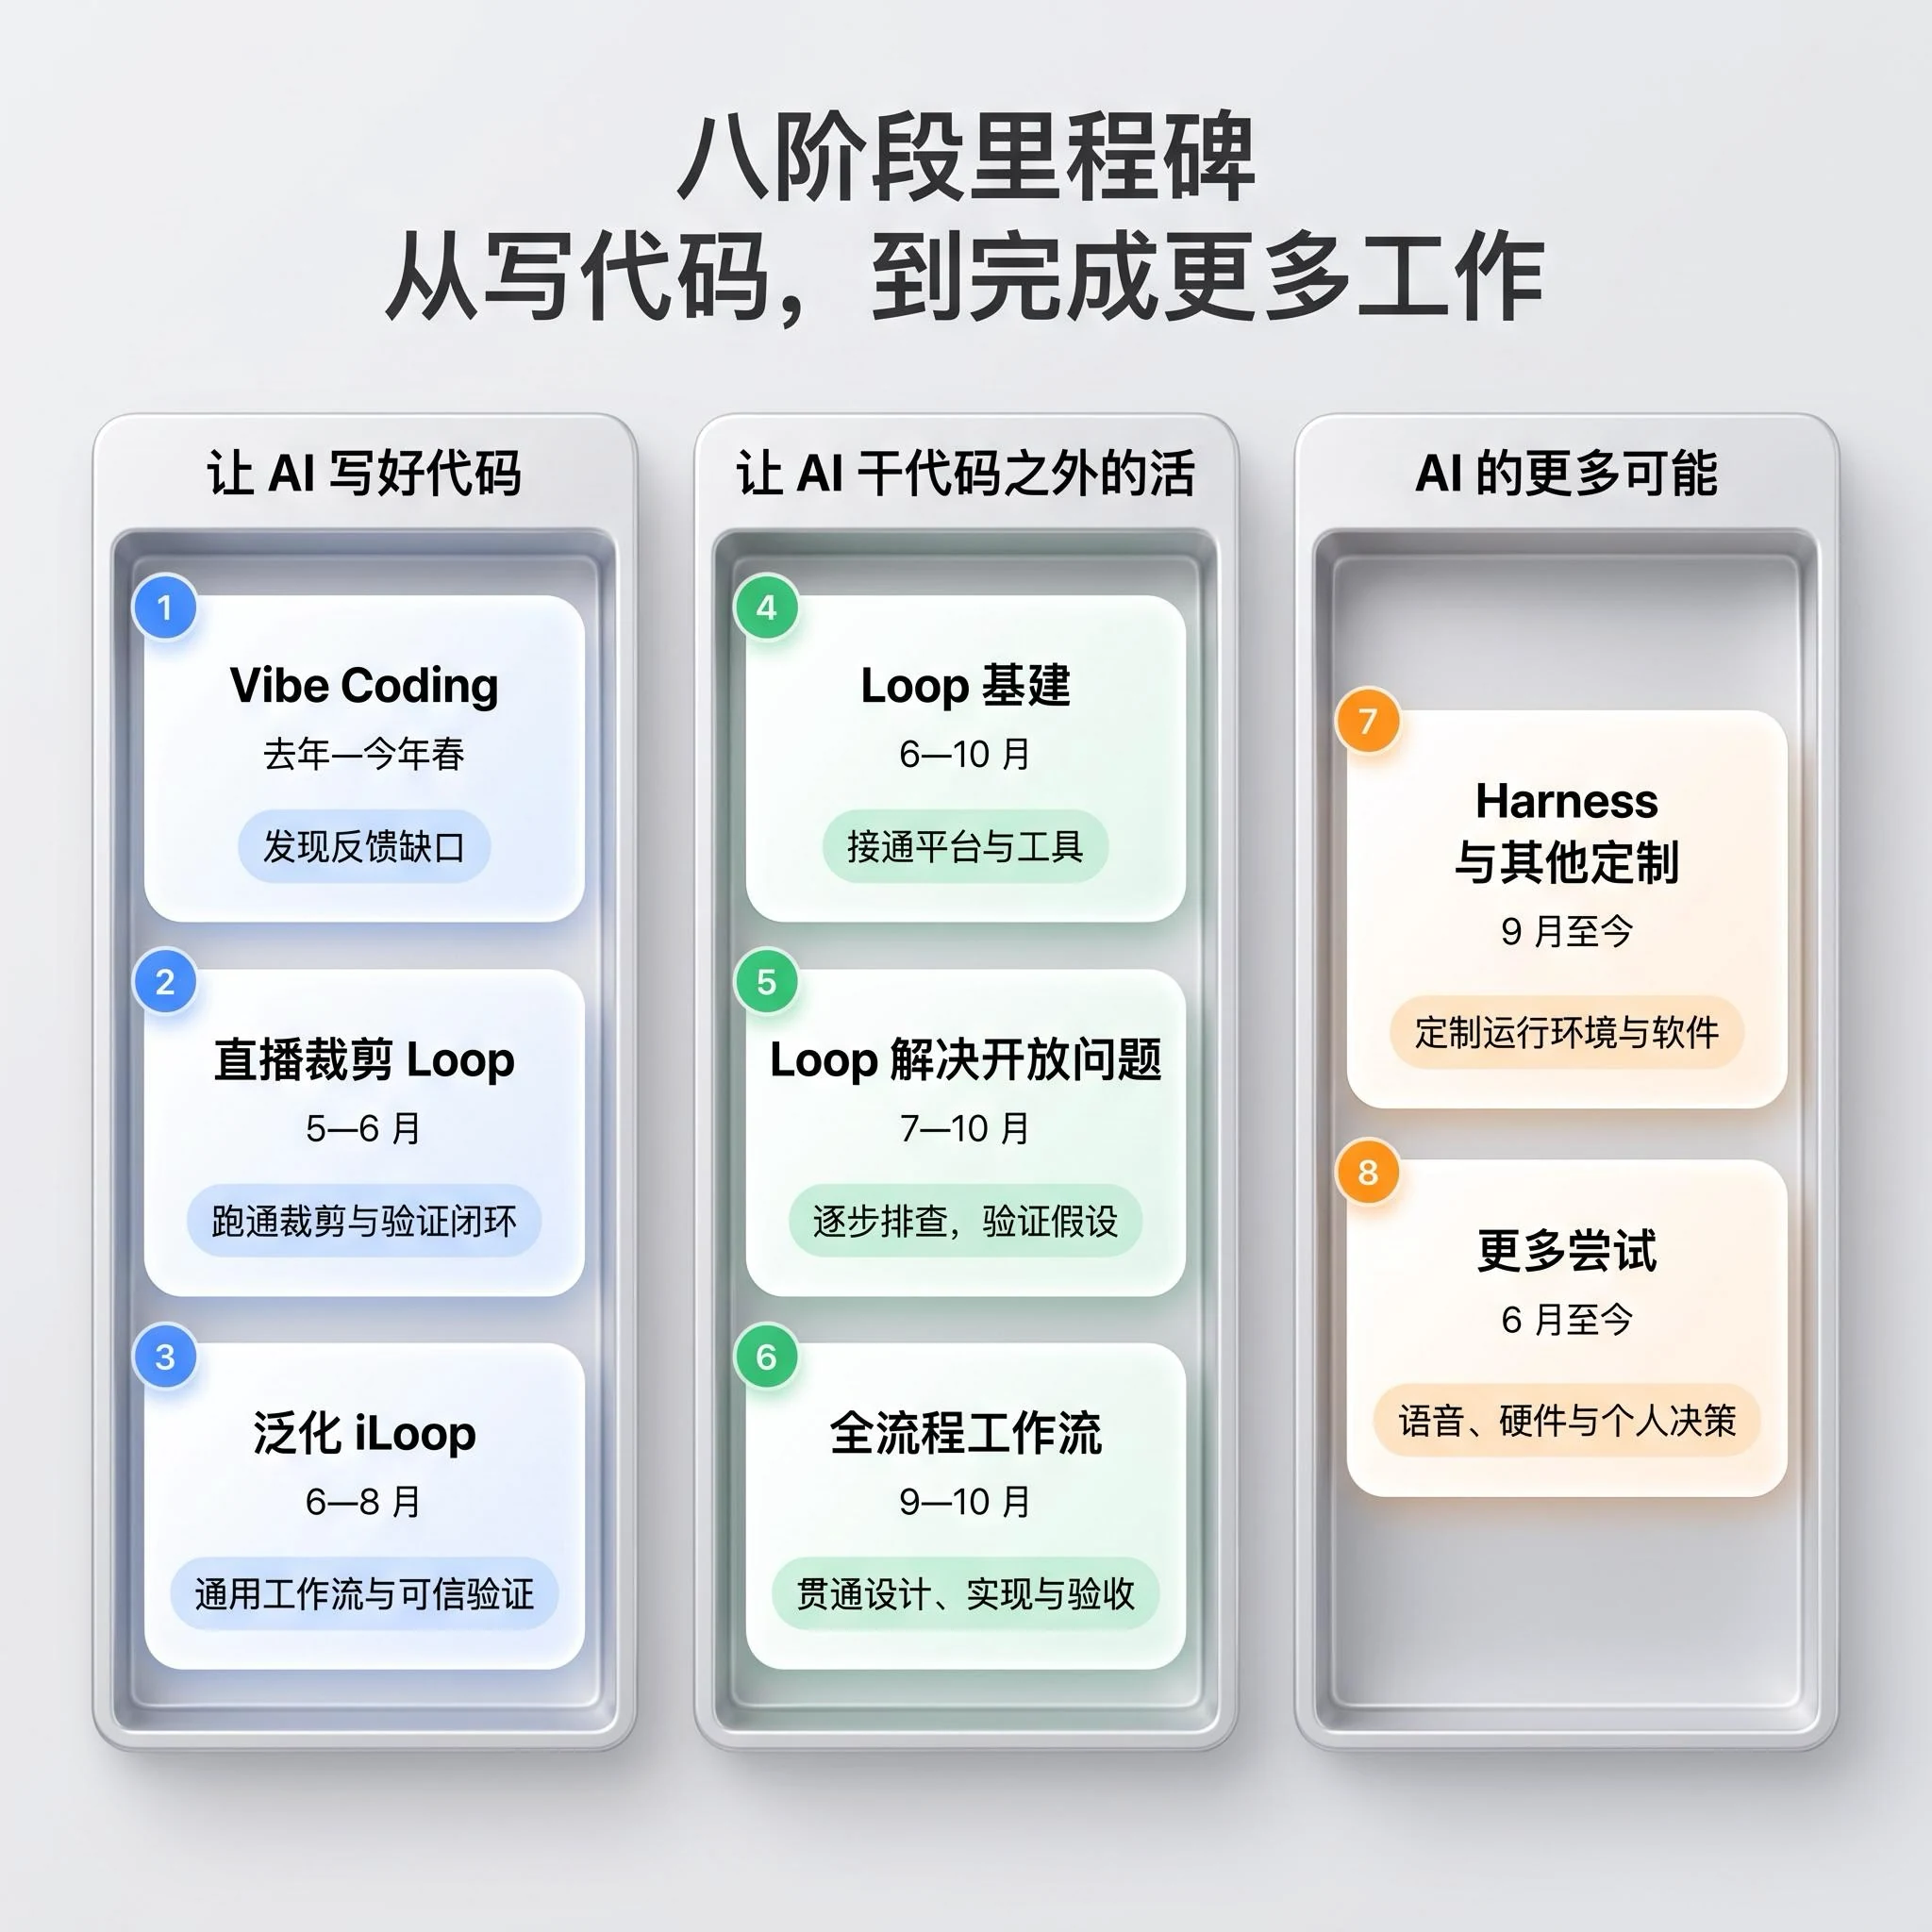
阶段 1 · Vibe Coding(去年—今年春)
AI 写不好 iOS,不全怪幻觉:它看不到编译和运行结果,只能猜。
最早用 AI 写iOS代码,就是对话框写一些代码片段的Vibe Coding阶段。
那时候写代码幻觉还很高,它十句里九句是对的,很容易被带到沟里;让它写的代码,经常编译不过。
只给代码文本,它只能猜
其实回头想想,不能全怪AI幻觉。
那时候AI拿不到整个仓库代码的上下文,也看不到运行时发生了什么。而大模型本质上是个概率机器,信息不够,就来瞎凑。
那时候的一个小技巧是:让它分析这段代码哪里需要加 Log。它把加 Log 的代码给我,我把运行态日志喂回去。程序报什么错、哪个分支没走到、实际输出和预期差在哪,AI 就大概有数了,效果好很多。
那个时候经常需要质疑它,看它有没有骗我。
前端为啥写得好?
AI 写代码,也不全是跟 iOS 这么糟,前端就写得挺好。这是为啥?因为那时 AI 用不了 Xcode ?
前端能接构建、浏览器、控制台和网络面板;那时的 iOS,AI 只能改代码,编译、装包、运行还得人来做。
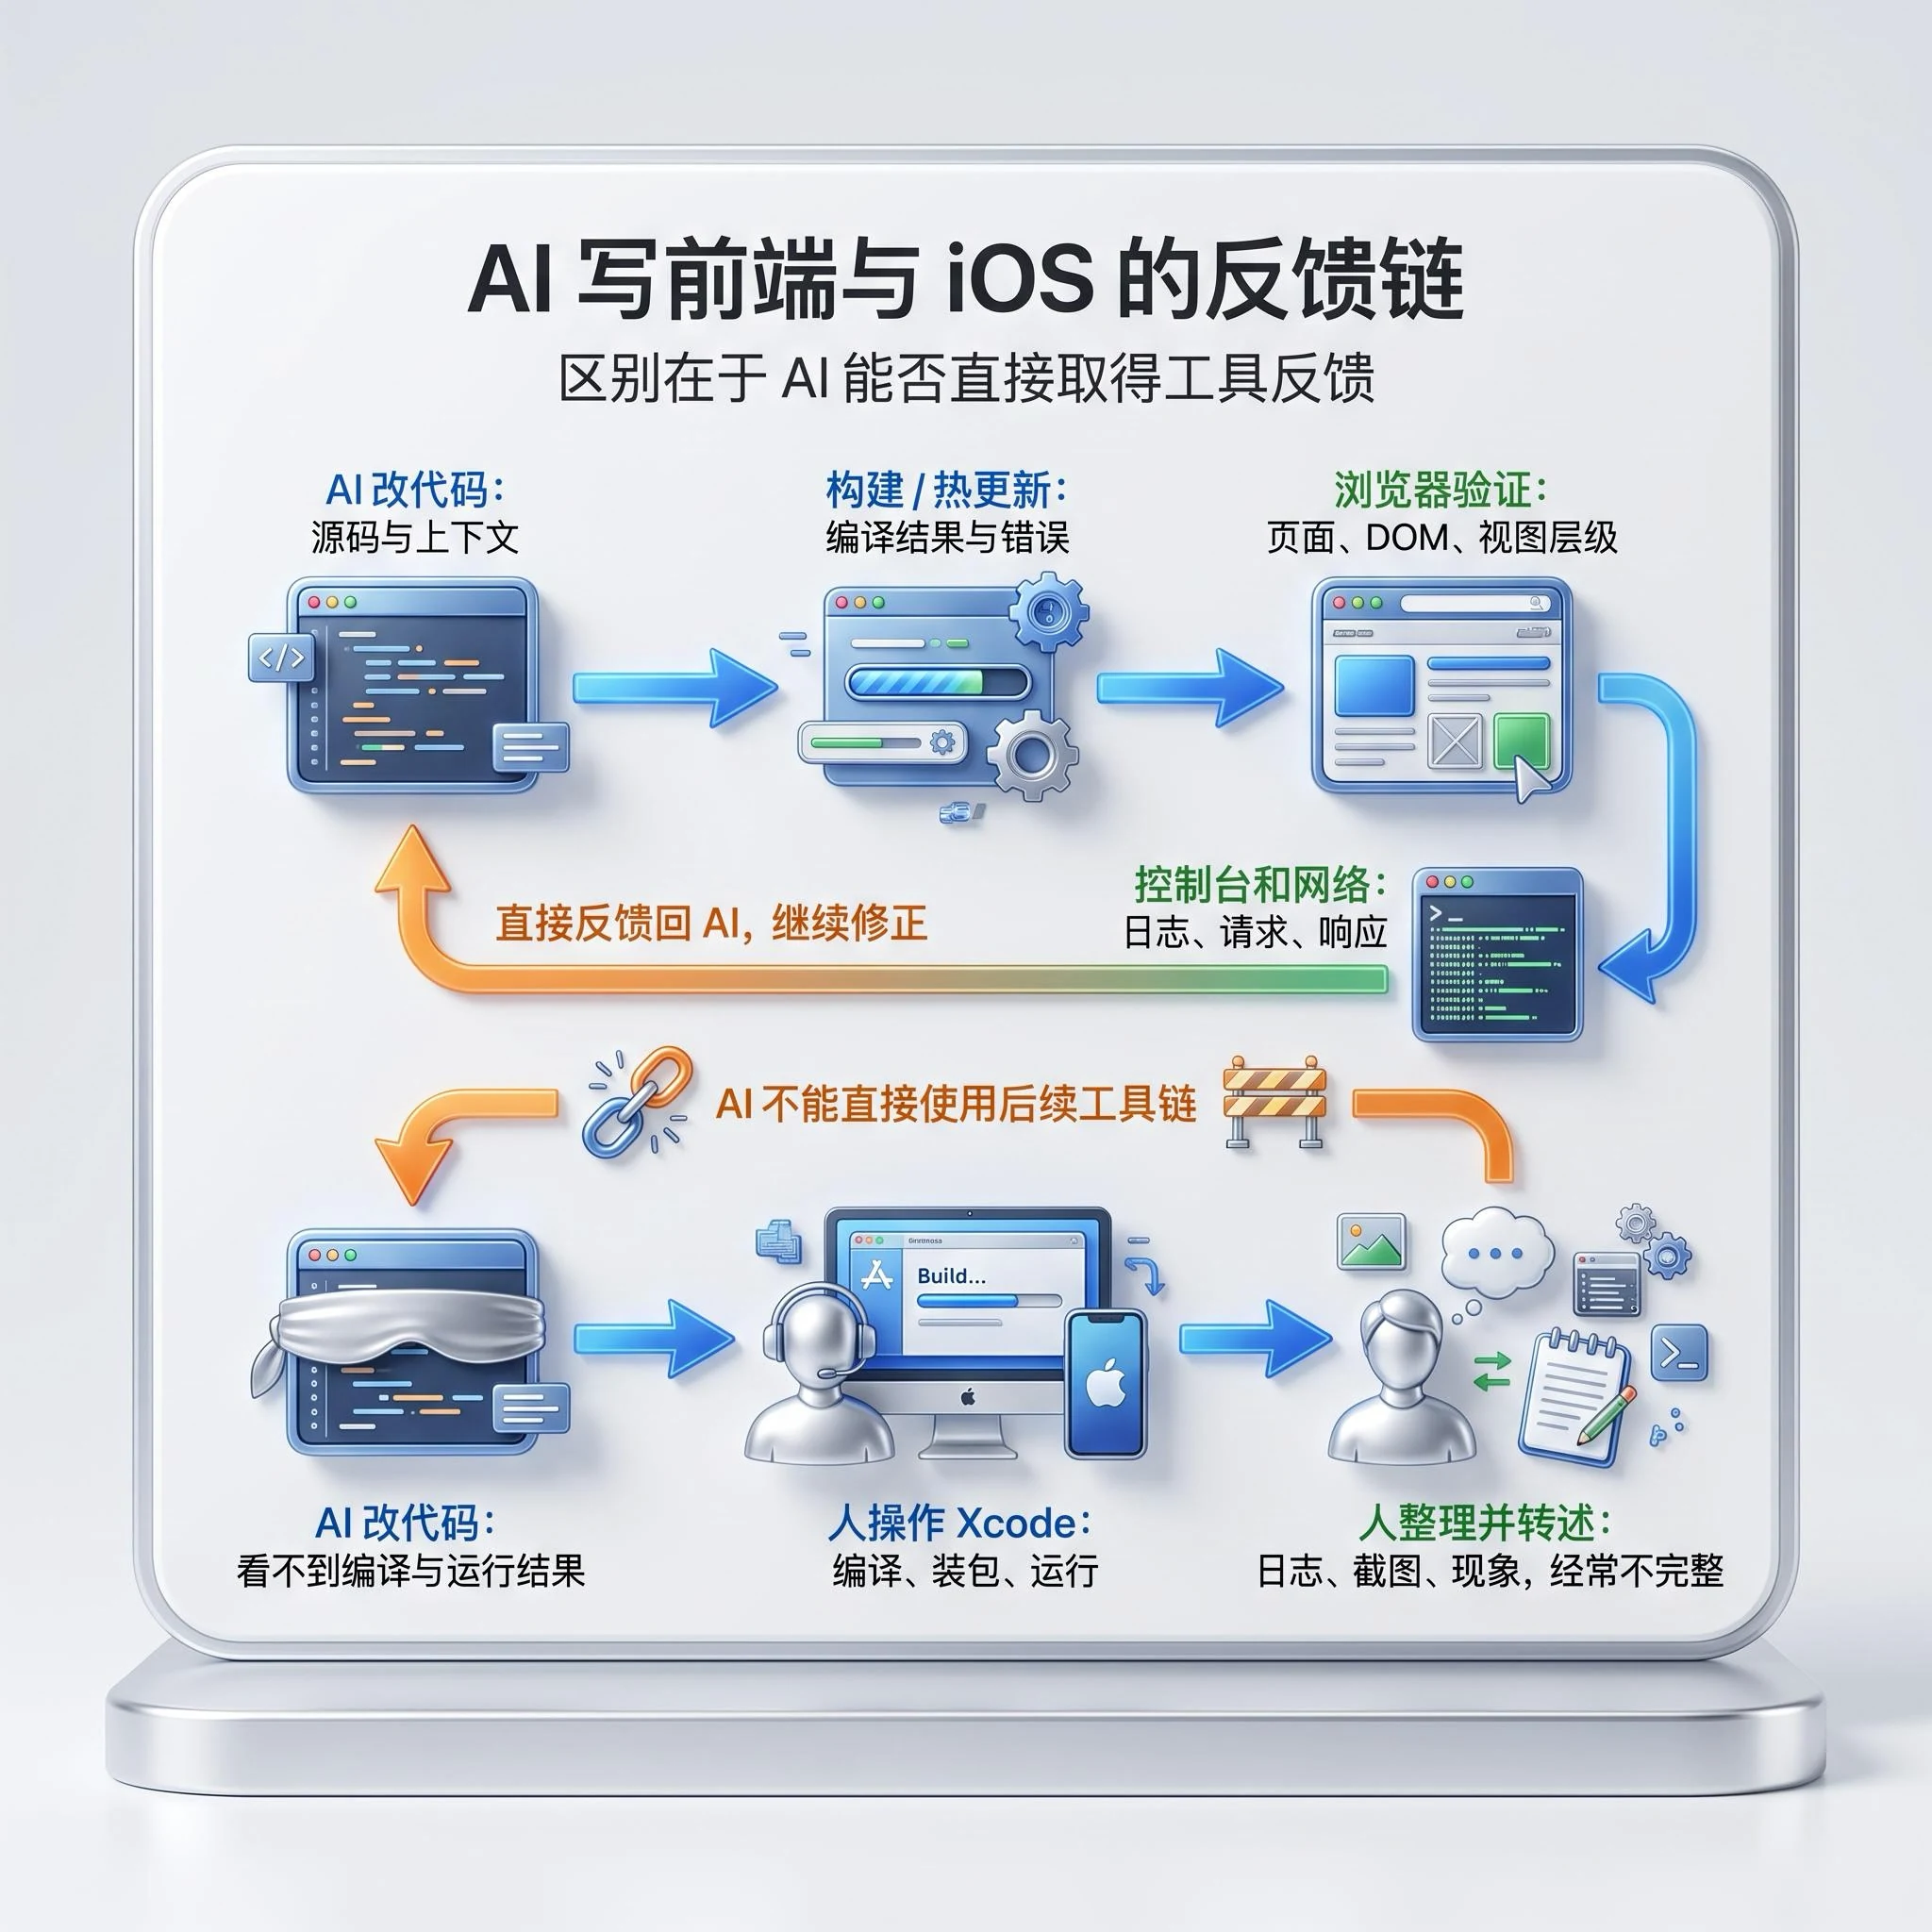
除此之外,还有三项差异:
- 数据:语料少(GitHub PR 口径:JS + TS 占全平台 30% 以上,Swift + OC 合计仅约 1.5%,差距 20 倍)
- 语言特性:OC Runtime(强依赖运行时,光看代码文件根本不知道运行起来是啥)、沙盒机制等
- 环境苛刻:强依赖 macOS + Xcode 工具链(前端是个机器就能跑)
前三点是短期难改,但反馈链却能补。人写完代码也要编译、运行,AI 拿不到这些上下文,其实和记事本里写代码没什么区别。所以当时就有一个感知:
借助AI持续学习
当然了,AI也是个很好的老师。那时候一个大疑问是:一个注意力模型怎么突然就有了智能的?
所以就疯狂补 AI 的底层原理,从梯度下降到 Transformer 架构。一遍遍地问 AI,多蠢的问题都问(反正它不会笑我)。有时候 AI 老师讲几遍也没听懂,就让它换成客户端能听懂的类比。一轮轮下来,一个个知识点就都清楚了。但时间长了又会忘,为了备忘,就总结了一篇文档《写给 RD 的 AI 底层原理》,让自己常看常新。后来感觉大家也有类似的困惑,就分享了出来,没想到大家还挺喜欢。
阶段 2 · 直播裁剪 Loop(5—6 月)
十天裁掉百万行代码,让我们设计了第一个带反馈的Loop体系;我从给AI当QA,变成了AI工具链的修理工。
这是“补齐反馈”的第一次完整Loop。
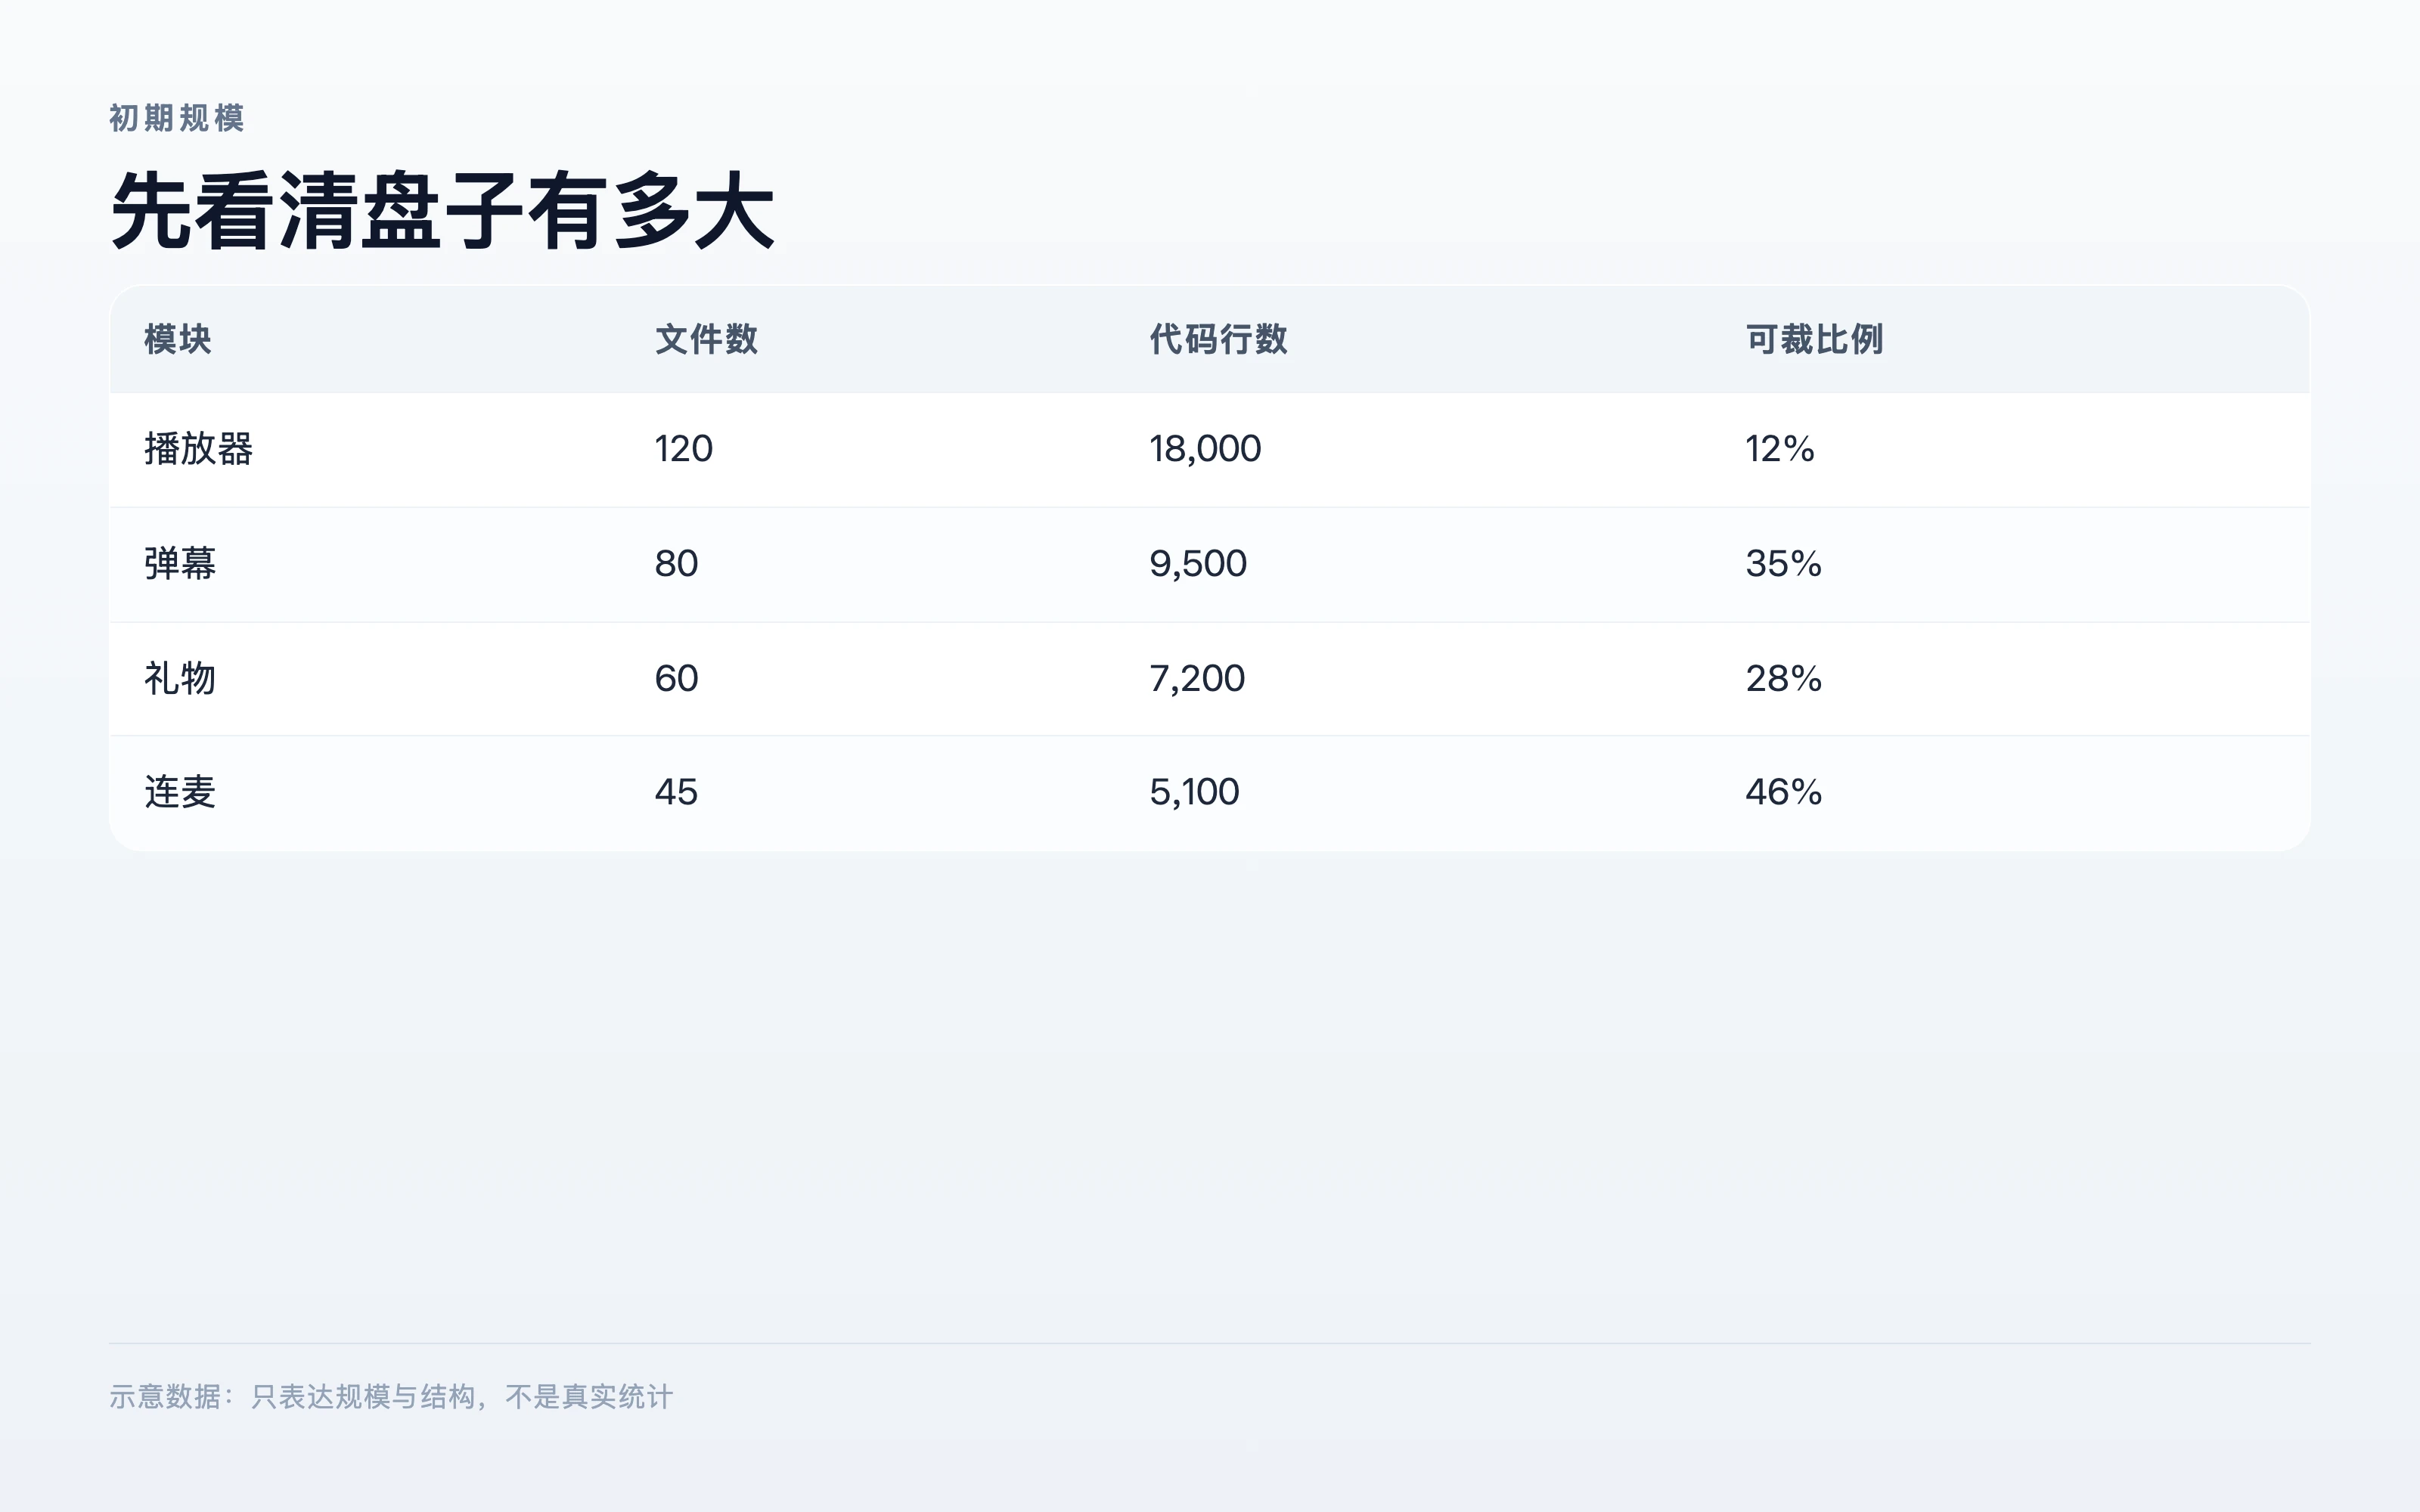
任务是把一个近百兆的直播SDK全家桶,10天内裁剪百万行以上的代码,进行极致的包体积裁剪。
核心难点有两个,且后续都是借助AI完成的:
- 能裁哪些不清楚(开放问题)
- 10天百万行怎么裁(效率问题)
裁哪些?
先梳理我们所有知道的上下文资产:
| 上下文来源 | 能提供什么 | 局限 |
|---|---|---|
| 直播 SDK 源码 | 最权威的事实 | 量太大,人读不过来 |
| 某独立端一期经验 | 明确不要哪些模块 | 只能缩小范围 |
| PM 诉求 | 粗粒度要什么、不关心什么 | 不到代码级 |
| 直播裁剪原则 | 哪些是基础能力不能裁 | 偏约束、非清单 |
| 另一独立端裁剪经验 | 同构裁剪的边界 | 很多策略不能太激进 |
| 2 年前 SaaS 上的裁剪 MR | 保留核心看播的范例 | 两年迭代差异大,已过时 |
| 直播研发同学 | 一些模块的大致情况 | 具体问题需要路由多个同学 |
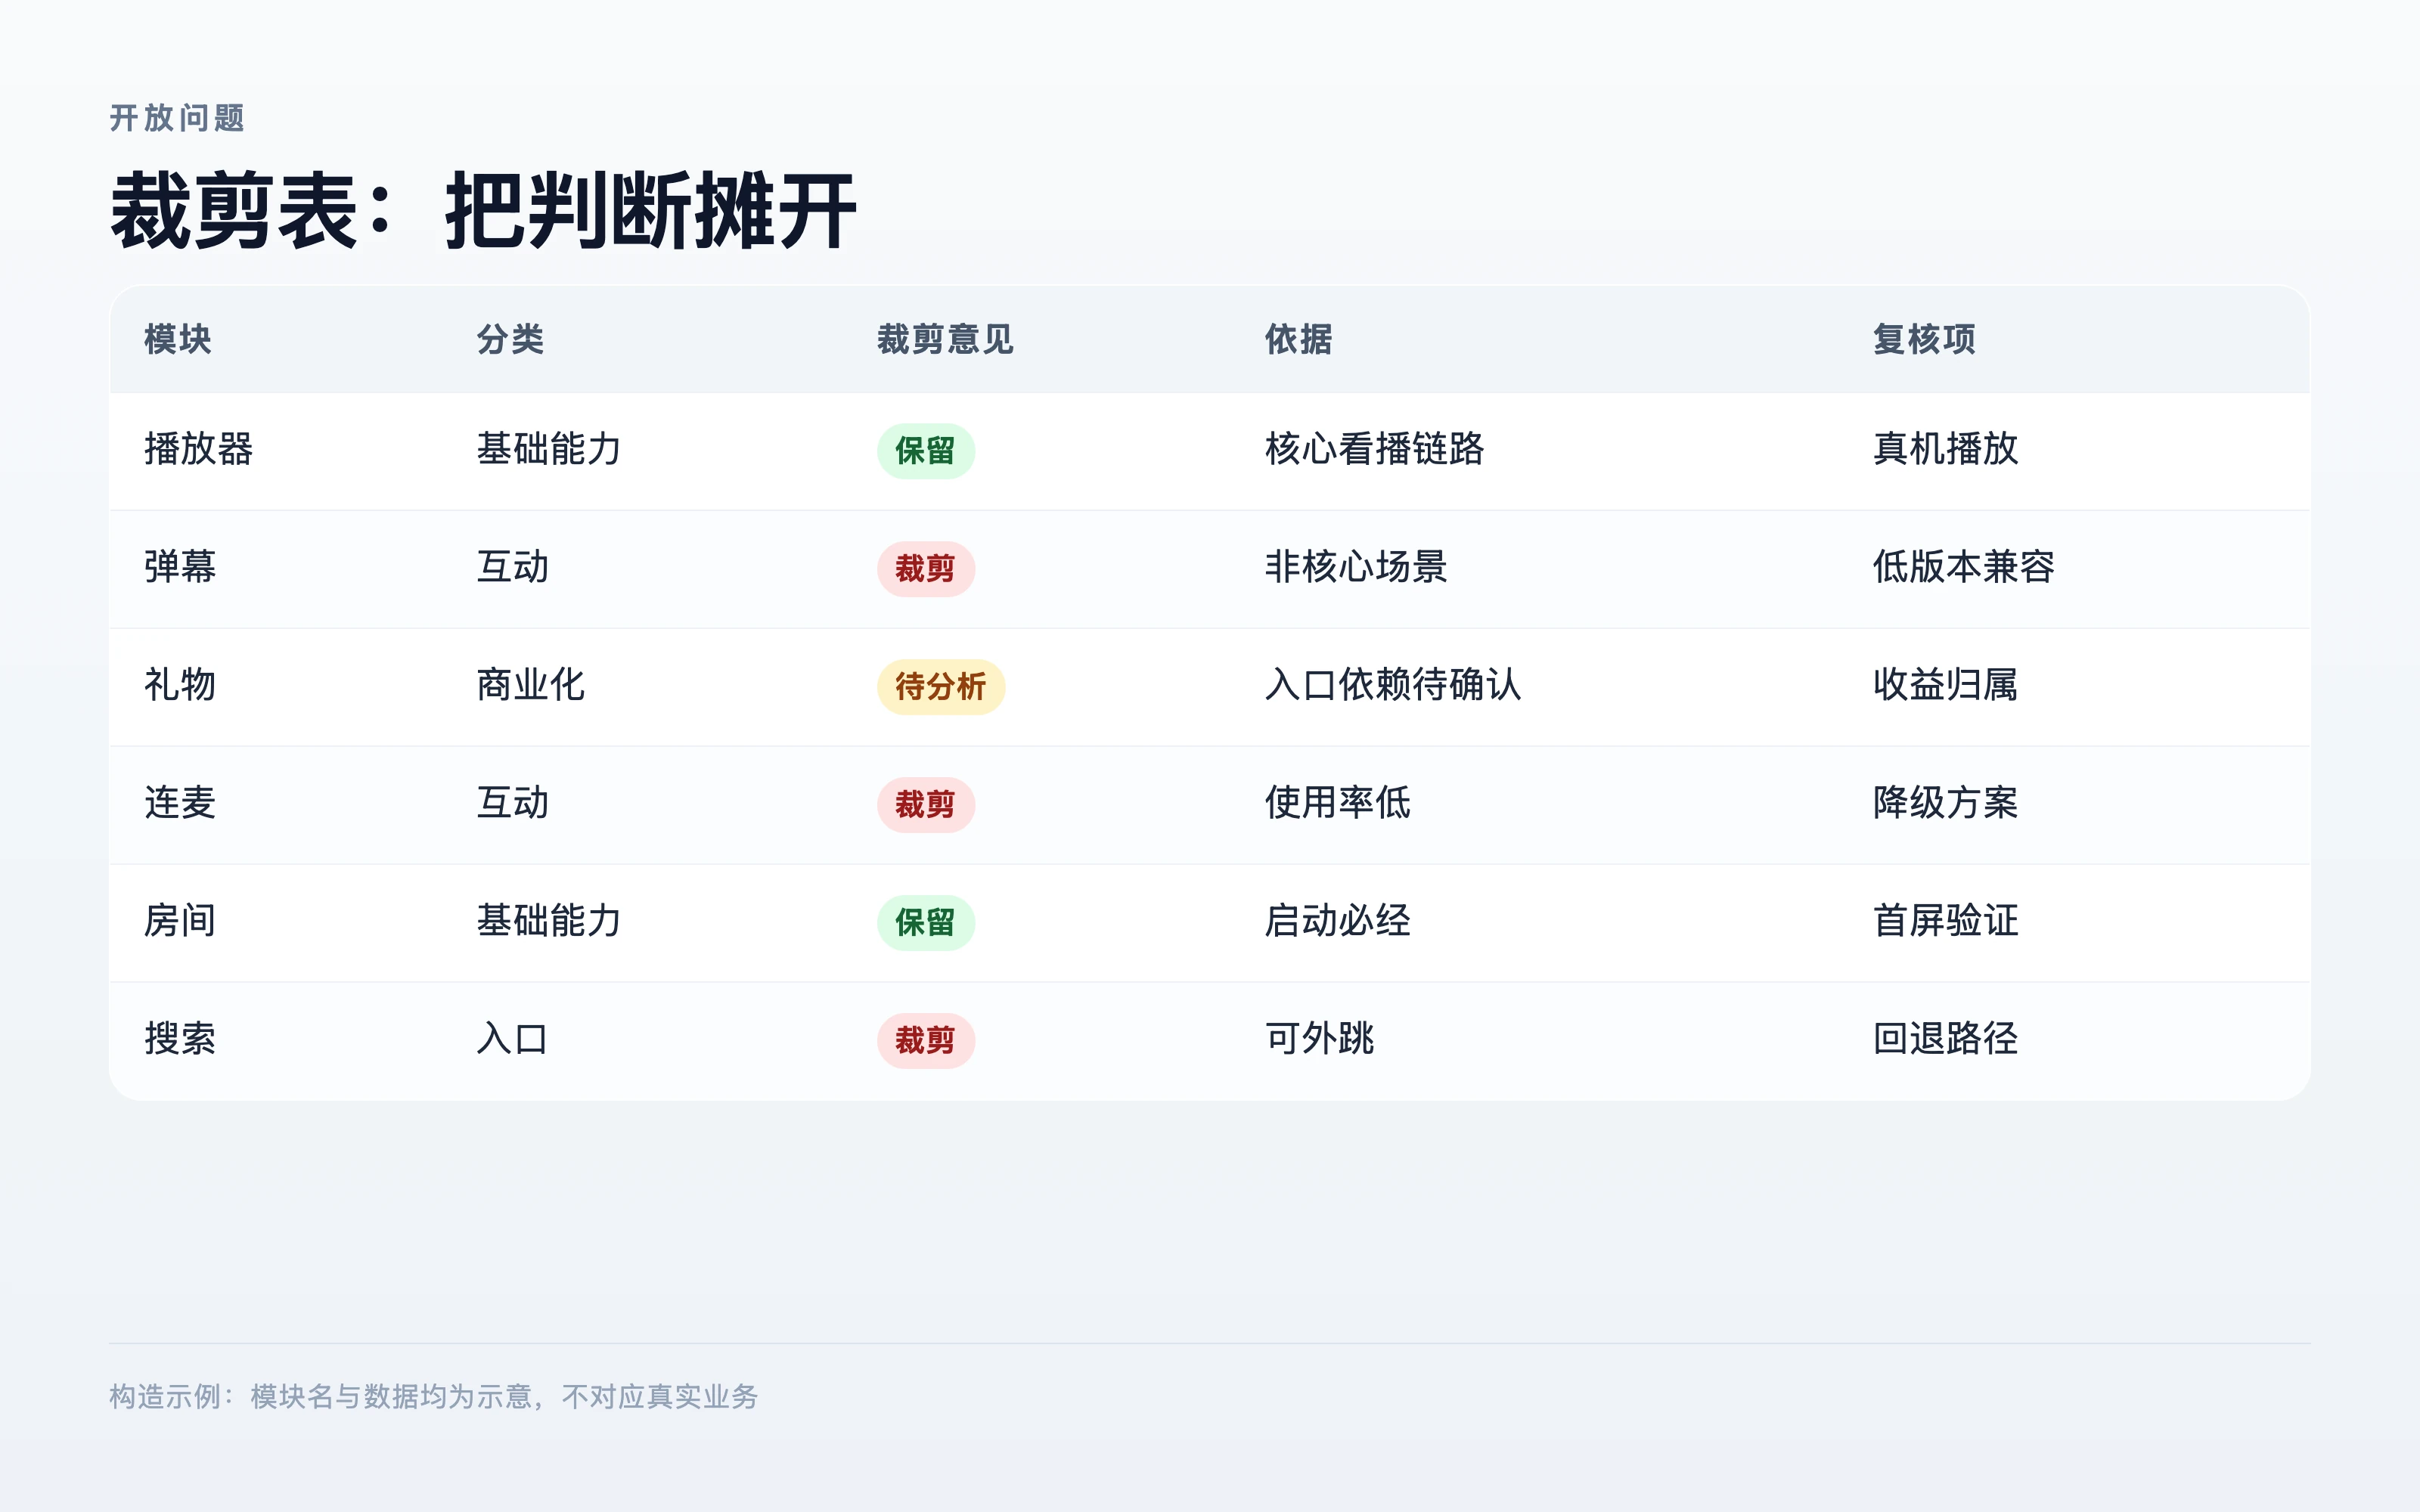
做法是让 AI 基于代码和上下文做源码分析,一层一层缩小范围,逐轮交叉验证、回源码反查,最后沉淀出一张粗粒度裁剪表。具体流程是:
- 根据直播SDK源码涉及的几个组件,进行源码扫描。分析出具体的模块(下钻到子模块维度),产出一个基础的直播模块表csv。
- 逐个分析上面这些上下文,提炼出能用的经验(比如明确哪些保留、哪些可以删除)。
- 根据经验加原始上下文数据,填入裁剪意见和裁剪说明。
- 补充新的上下文,再次对裁剪意见和说明进行复核《某独立端直播裁剪表合理性评估意见》
- 根据最终的直播裁剪表找直播同学review
当然了,它是经验值,不保证全对,这也让我们总结出了对于开放问题的一些思路。
怎么裁?
当时想过几种方式,可行的只有AI 裁、AI 验这一种。
关键原因是:它 5 分钟改完,我编译加验证要半小时,还得一直盯着,我成瓶颈了。
于是搭了一个 Loop,让它自己裁代码、自己编译、自己验证。
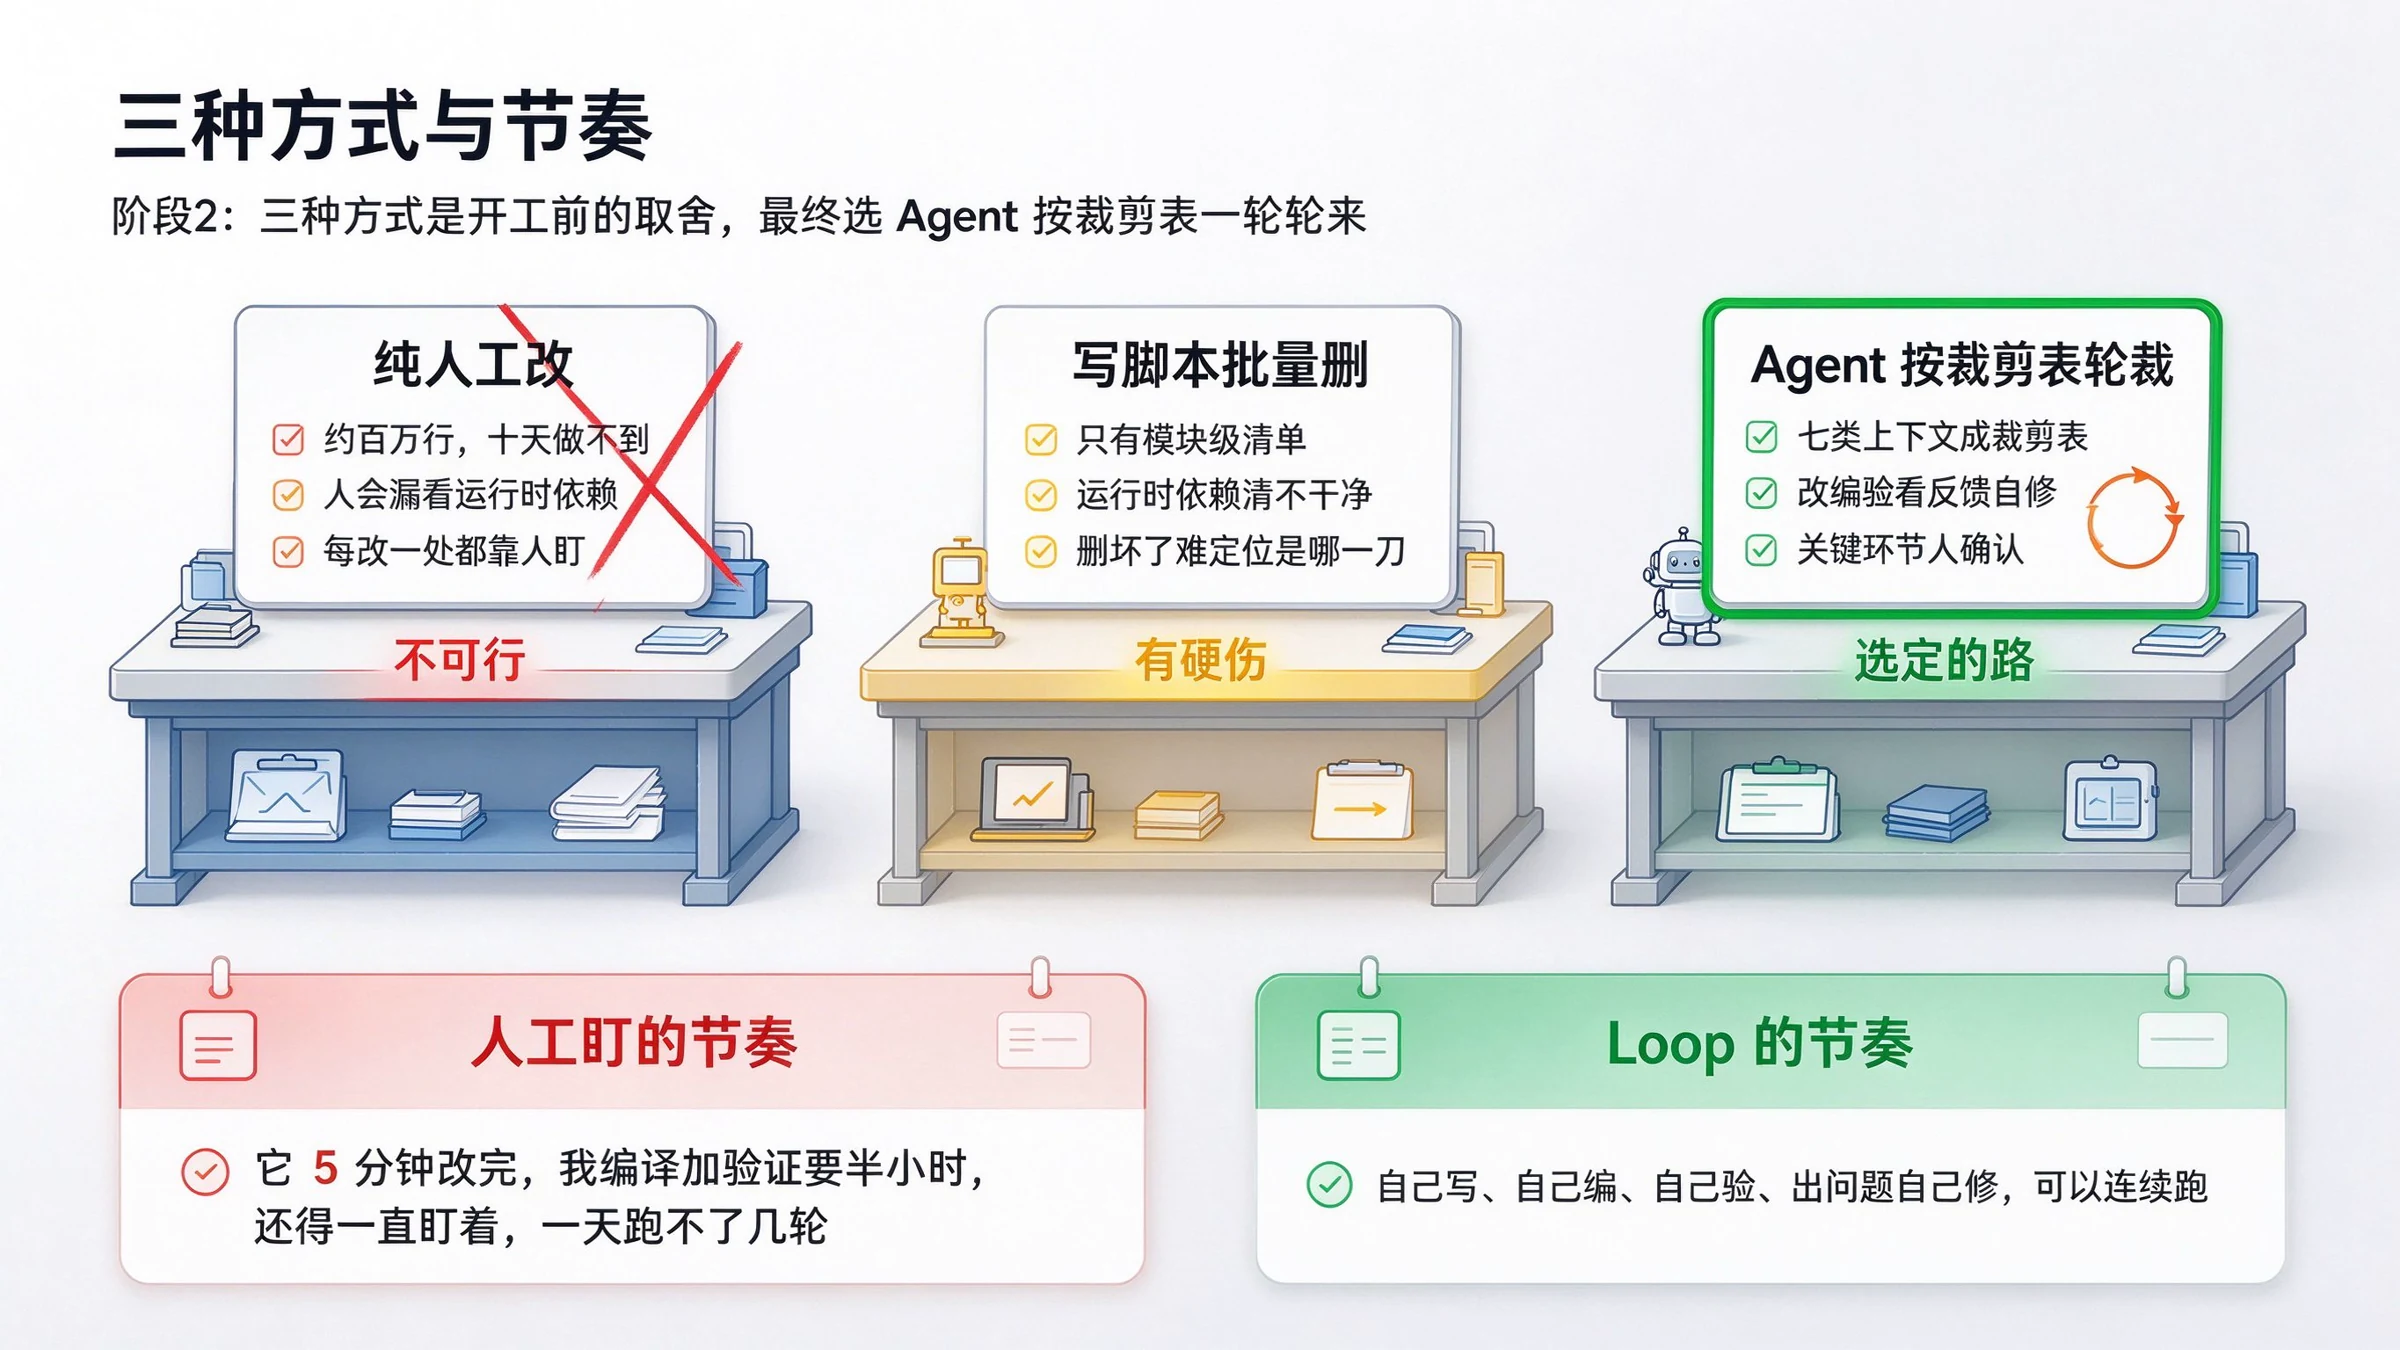
- 纯人工:键盘冒烟了都做不到
- 写脚本:清单维度过粗无从下手
- AI裁,我验:不行,我成瓶颈了
- AI裁,AI验:可行,补齐编译链
一些关键的思路:
编译:面向AI的编译,XcodeBuildMCP《XcodeBuildMCP 还能这么玩?》
验证:模拟器+真机UI自动化
长任务问题
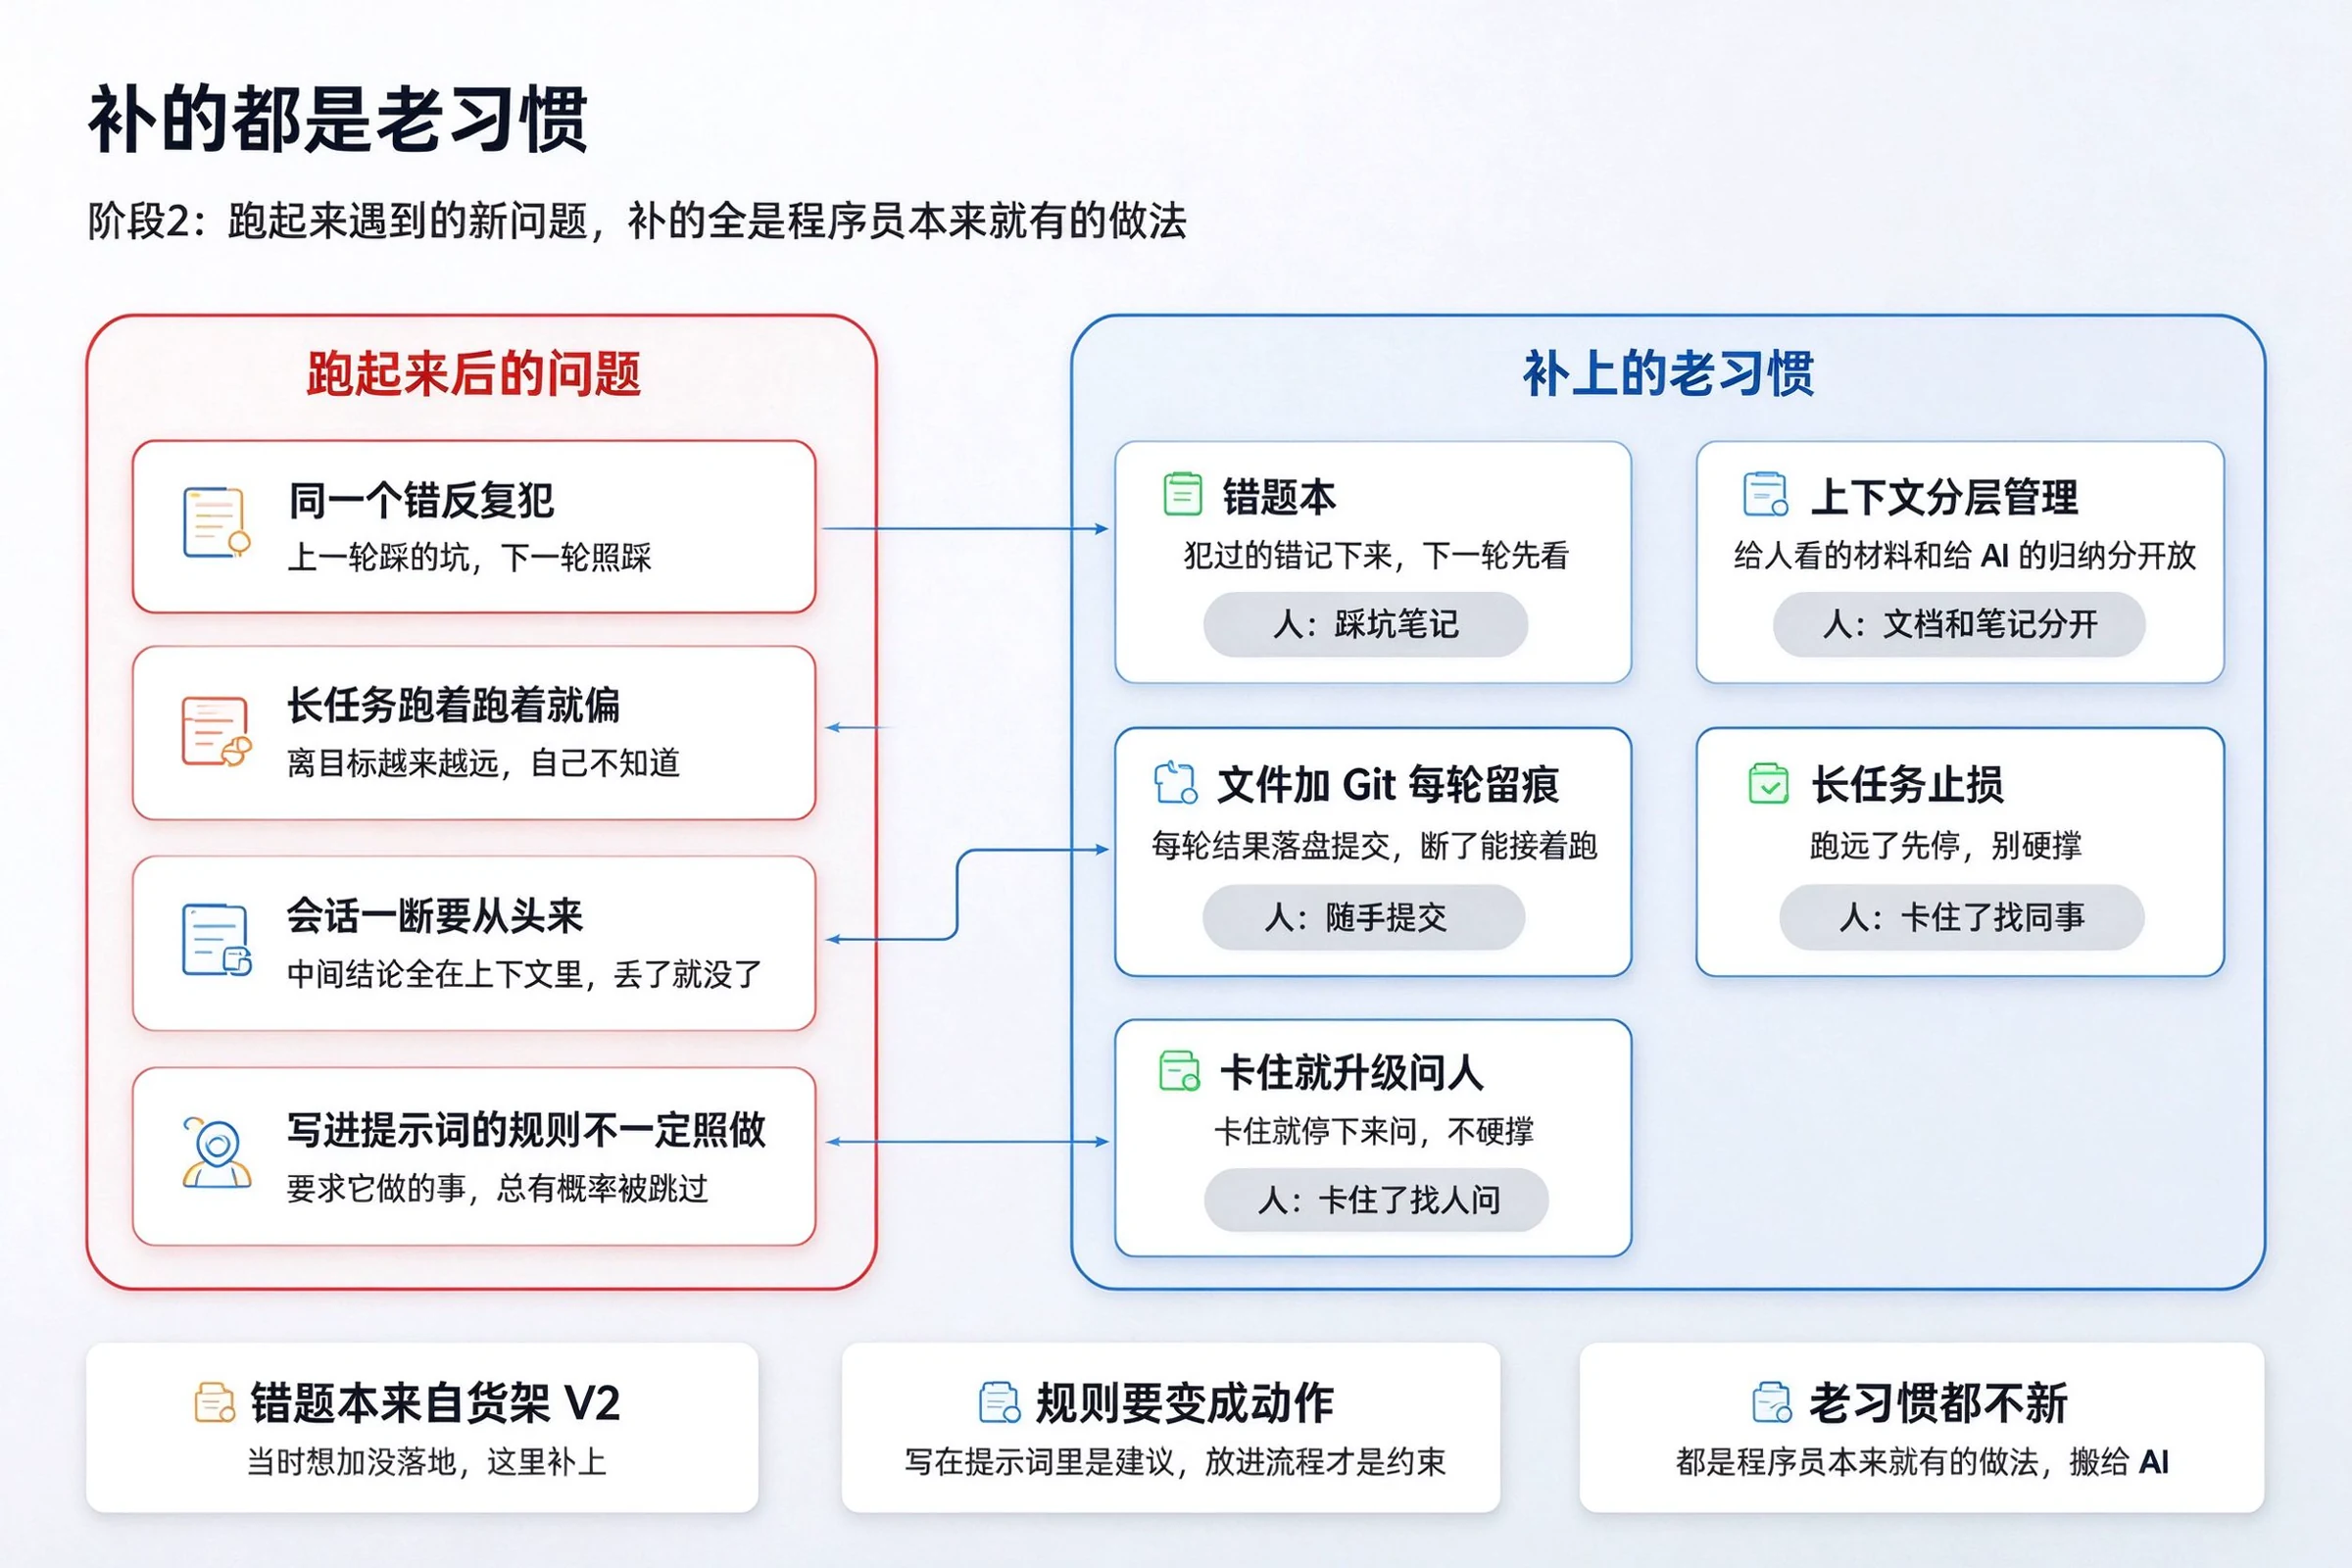
Loop 跑起来后,长任务又带来了新问题:
- 记忆问题:长任务跑着跑着偏,会话一断中间结论全丢
- 约束问题:写进提示词的规则总有概率被跳过。
- 同一个错反复犯等等
解法还是“仿生学”:看看人类程序员和业界大拿怎么说。
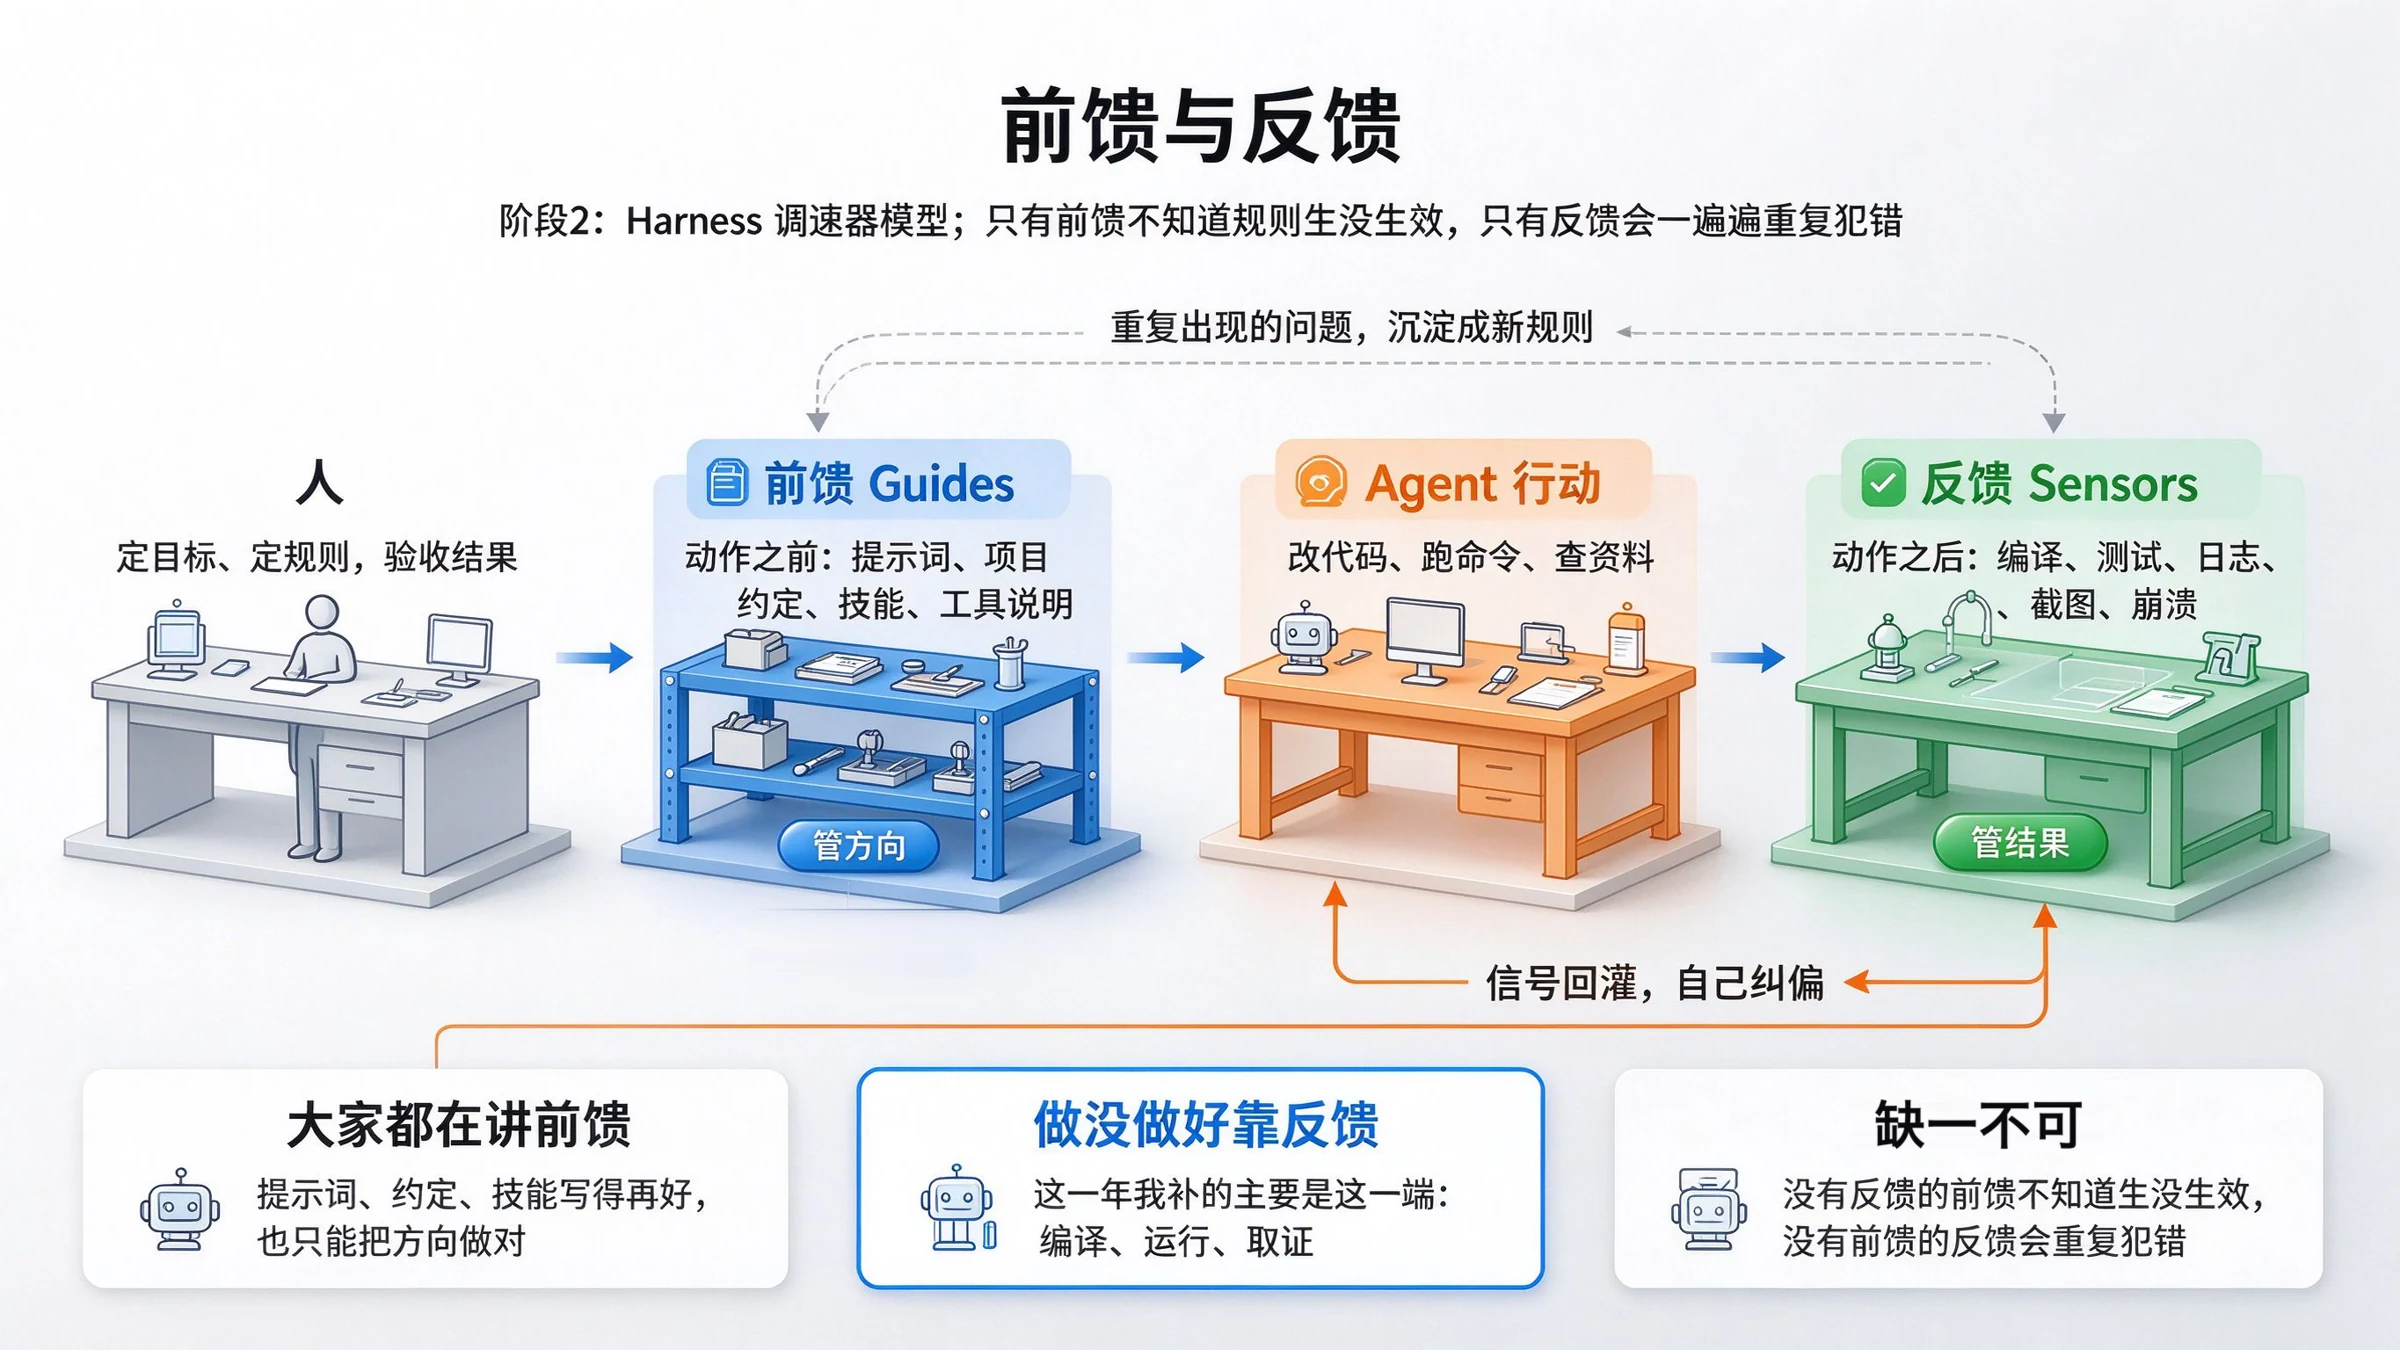
Claude Code 官方文档把最后一件讲得很直接:Hooks 提供确定性控制,关键动作一定发生,不靠模型自觉去选。写在提示词里是建议,放进流程才是约束。
“Hooks provide deterministic control over Claude Code’s behavior, ensuring certain actions always happen rather than relying on the LLM to choose to run them.”
Harness Engineering 早有记载:前馈在动作之前给方向,反馈在动作之后纠偏,缺一不可。Harness Engineering:模型之外的 98%
“Guides … aim to steer the agent’s behaviour and lead it to act on the best possible version before it acts."
"Sensors observe after the agent acts and help it self-correct."
"Separately, you get either an agent that keeps repeating the same mistakes (feedback-only) or an agent that encodes rules but never finds out whether they worked (feed-forward-only).”
所以最后的架构和结论是:
分阶段验收
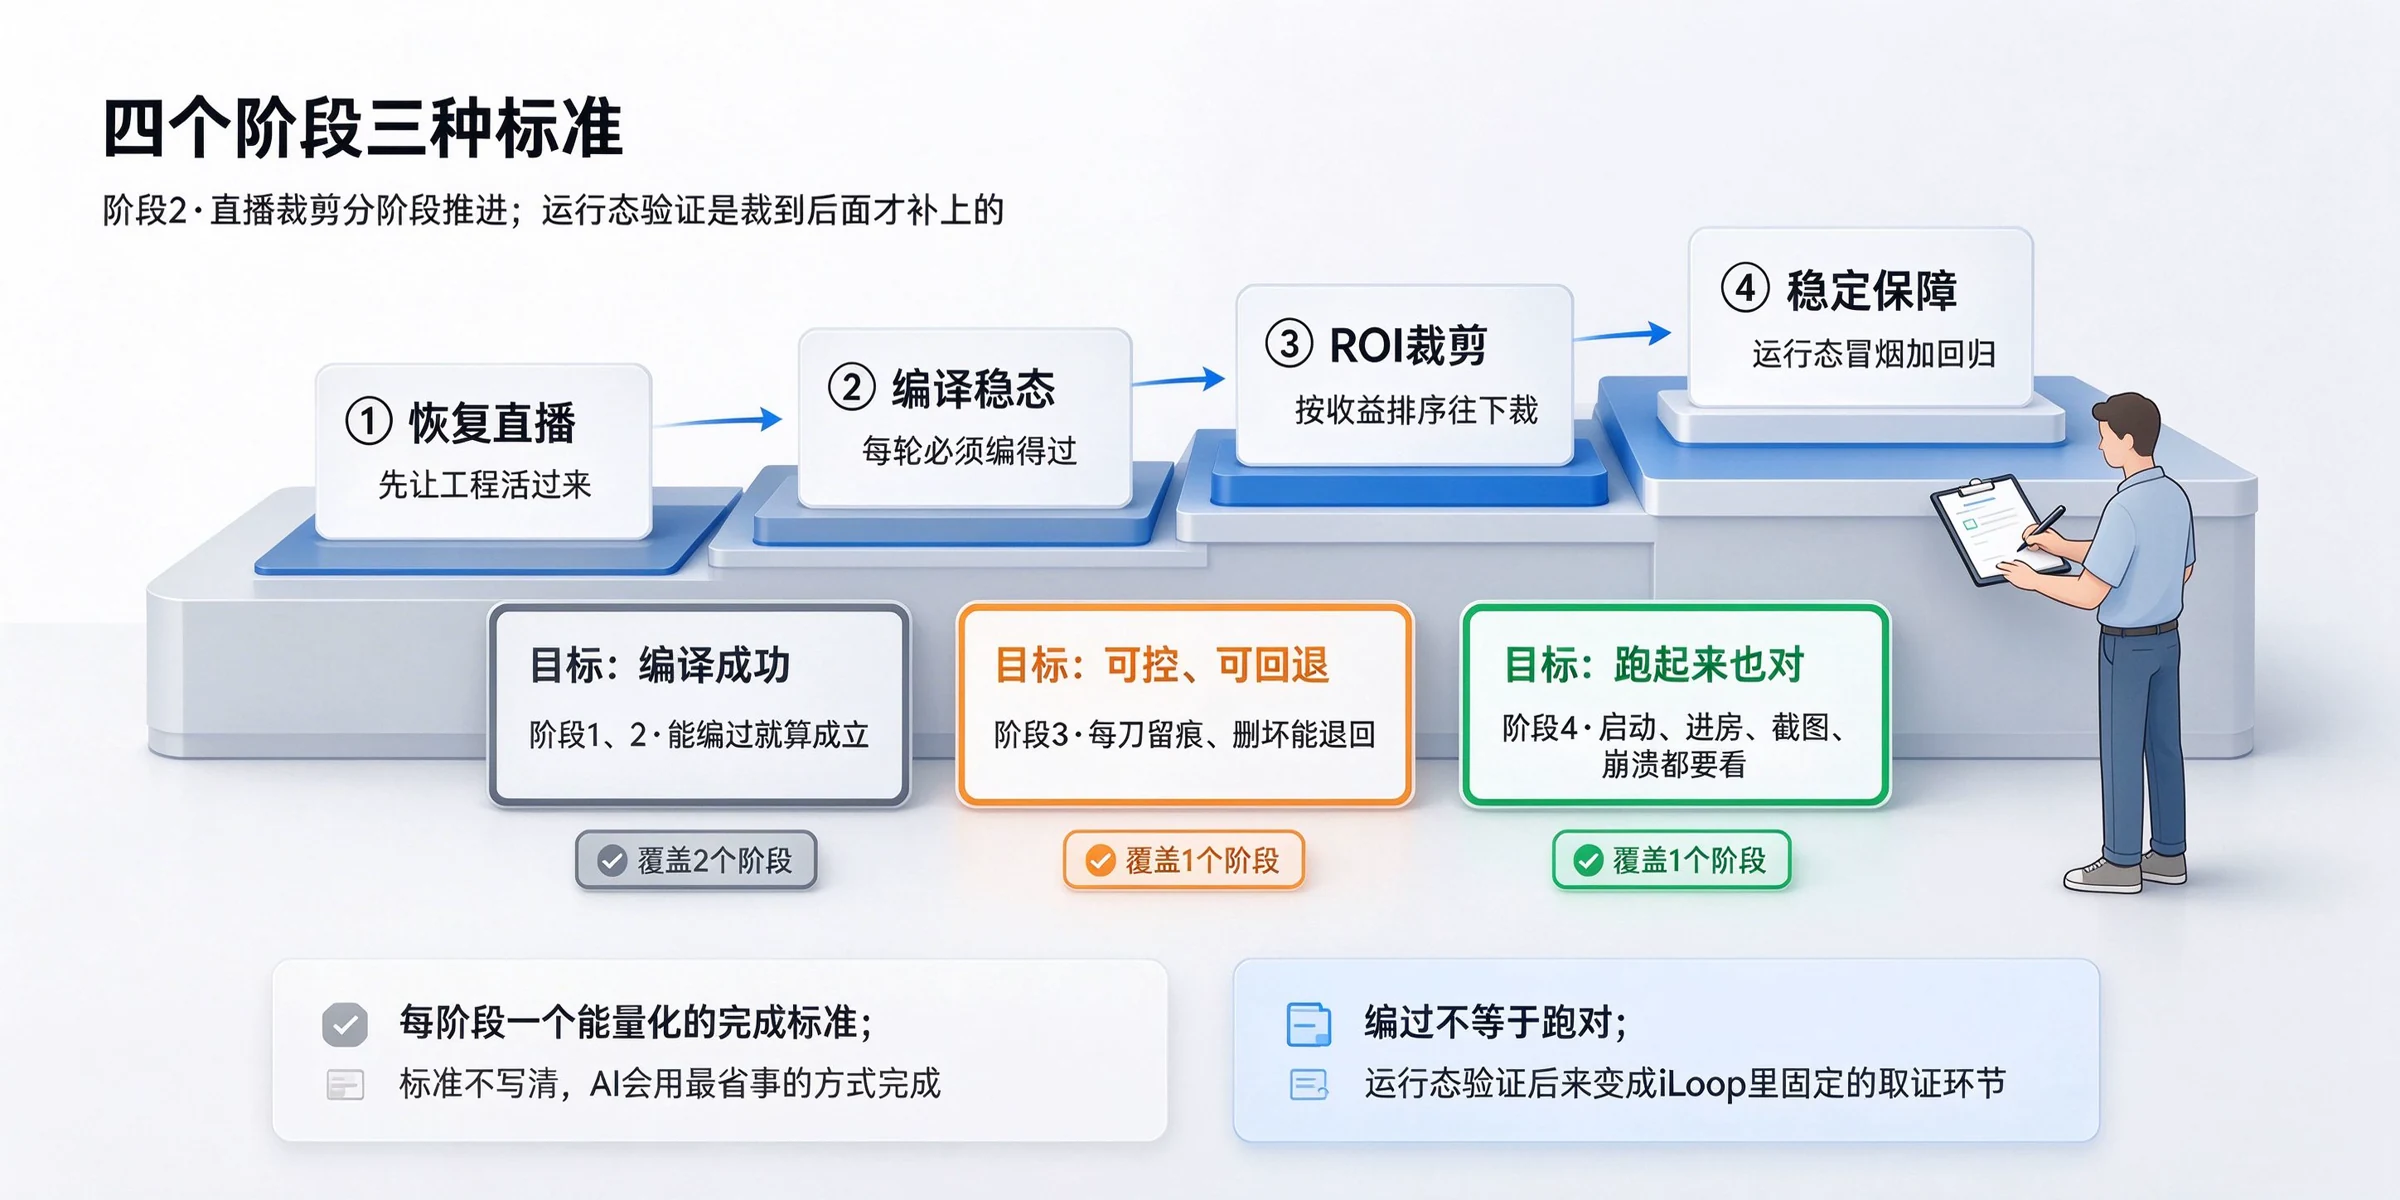
过程中我们还发现,让它直接完成一个大目标,成功率很低。所以我们就把大目标拆成子目标、分别验证,整体成功率就高很多。关键是每个阶段的目标和量化标准不一样:
- 前两段编译通过就行;
- 第三段按收益排序往下裁,每一轮留痕、可控可回退;
- 第四段要跑起来不崩溃、页面正常。
裁完以后,还需要AI帮我验证。因为我也review不了这么多改动《直播裁剪运行态保障方案》。
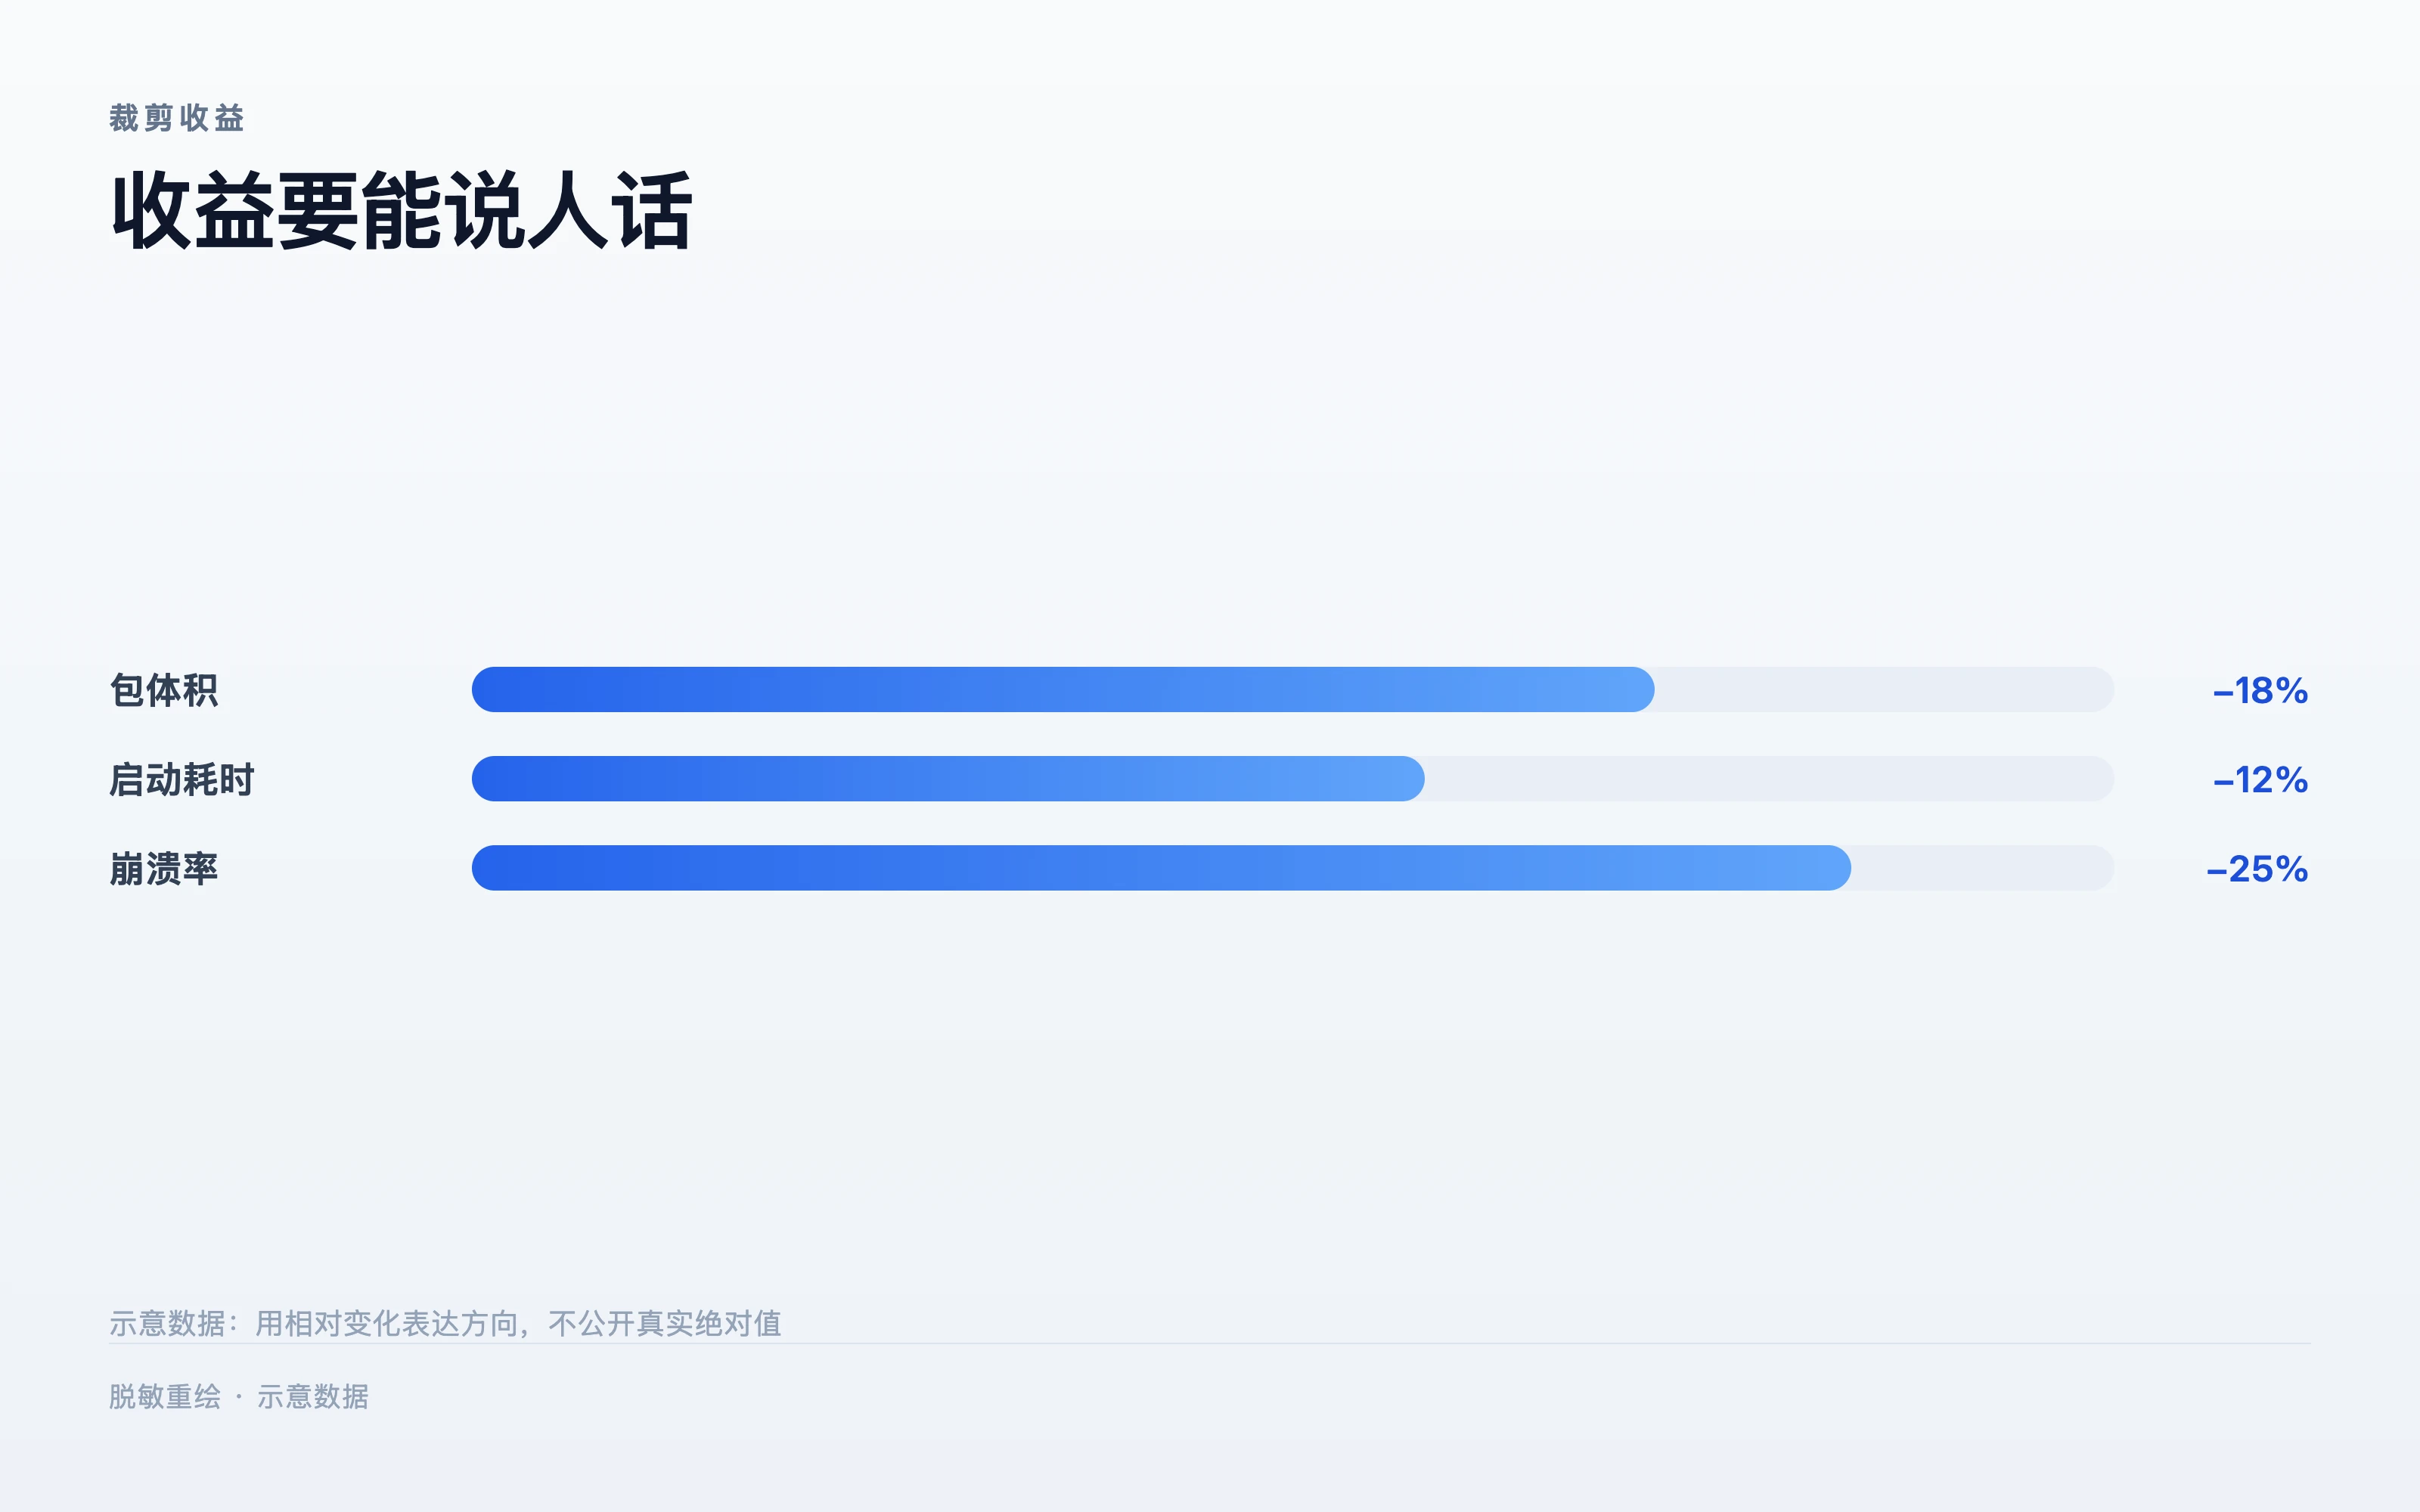
最终得到了一些有意思的数据和收获:
- 体积:一期 Release 实测减少三十余 MB,二期实测减少数 MB,两期合计四十余 MB;优化代码百万行以上。
- 托管:按执行时间算,超过 98% 的时间不需要我介入(夜间运行);累计无人值守 一百二十余小时,单轮最长十四小时以上,同口径粗估我一共介入约 2 小时。
- 代价:十天里前四五天边调 Agent 边裁剪,后半程相对顺;编译验证二百四十余次,通过一百六十余次、失败约八十次(约三分之一),失败本身就是它在拿反馈;人工介入约四十次。
- 敏捷:时间紧任务重,只能边裁边调,有问题当天改,不先憋一个完美 Agent 再开工。
- 不足:编译与页面验证形成闭环,不等于直播核心播放全覆盖。核心播放只能在真机上跑,模拟器跑不了;当时 QA case 的上下文不够,AI 没法完全理解测试链路,仍是半自动加人工兜底。
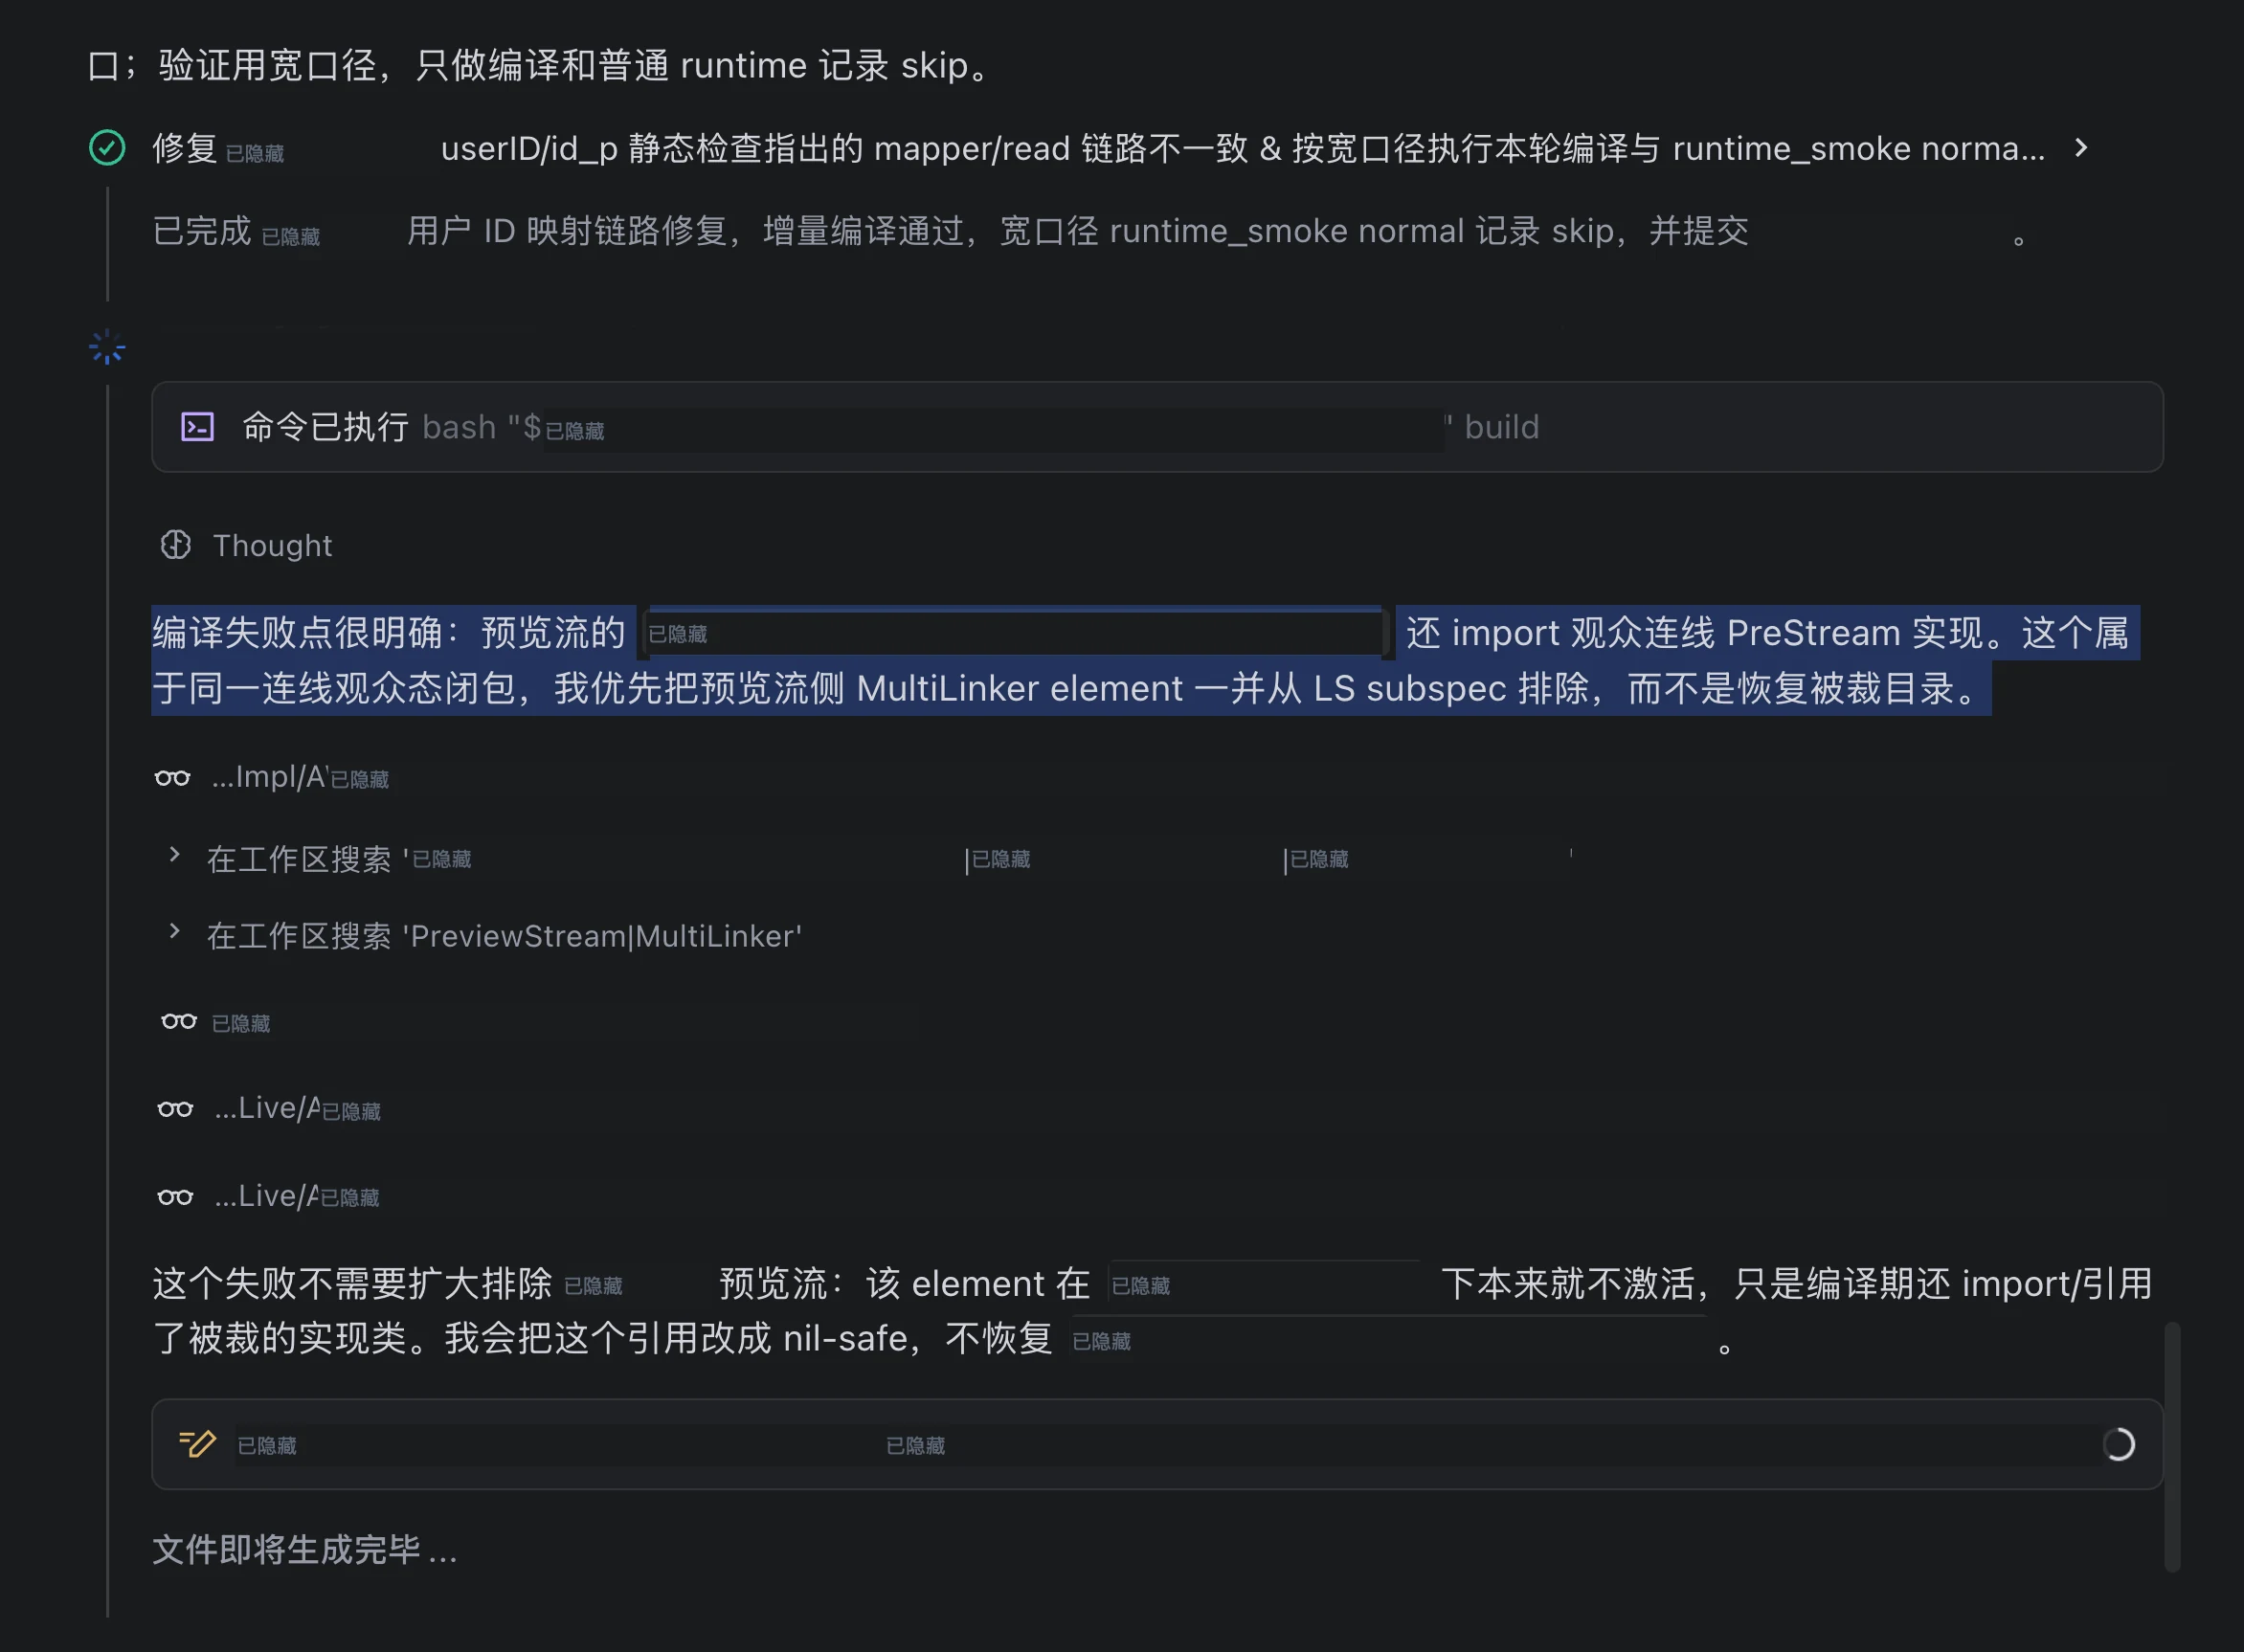
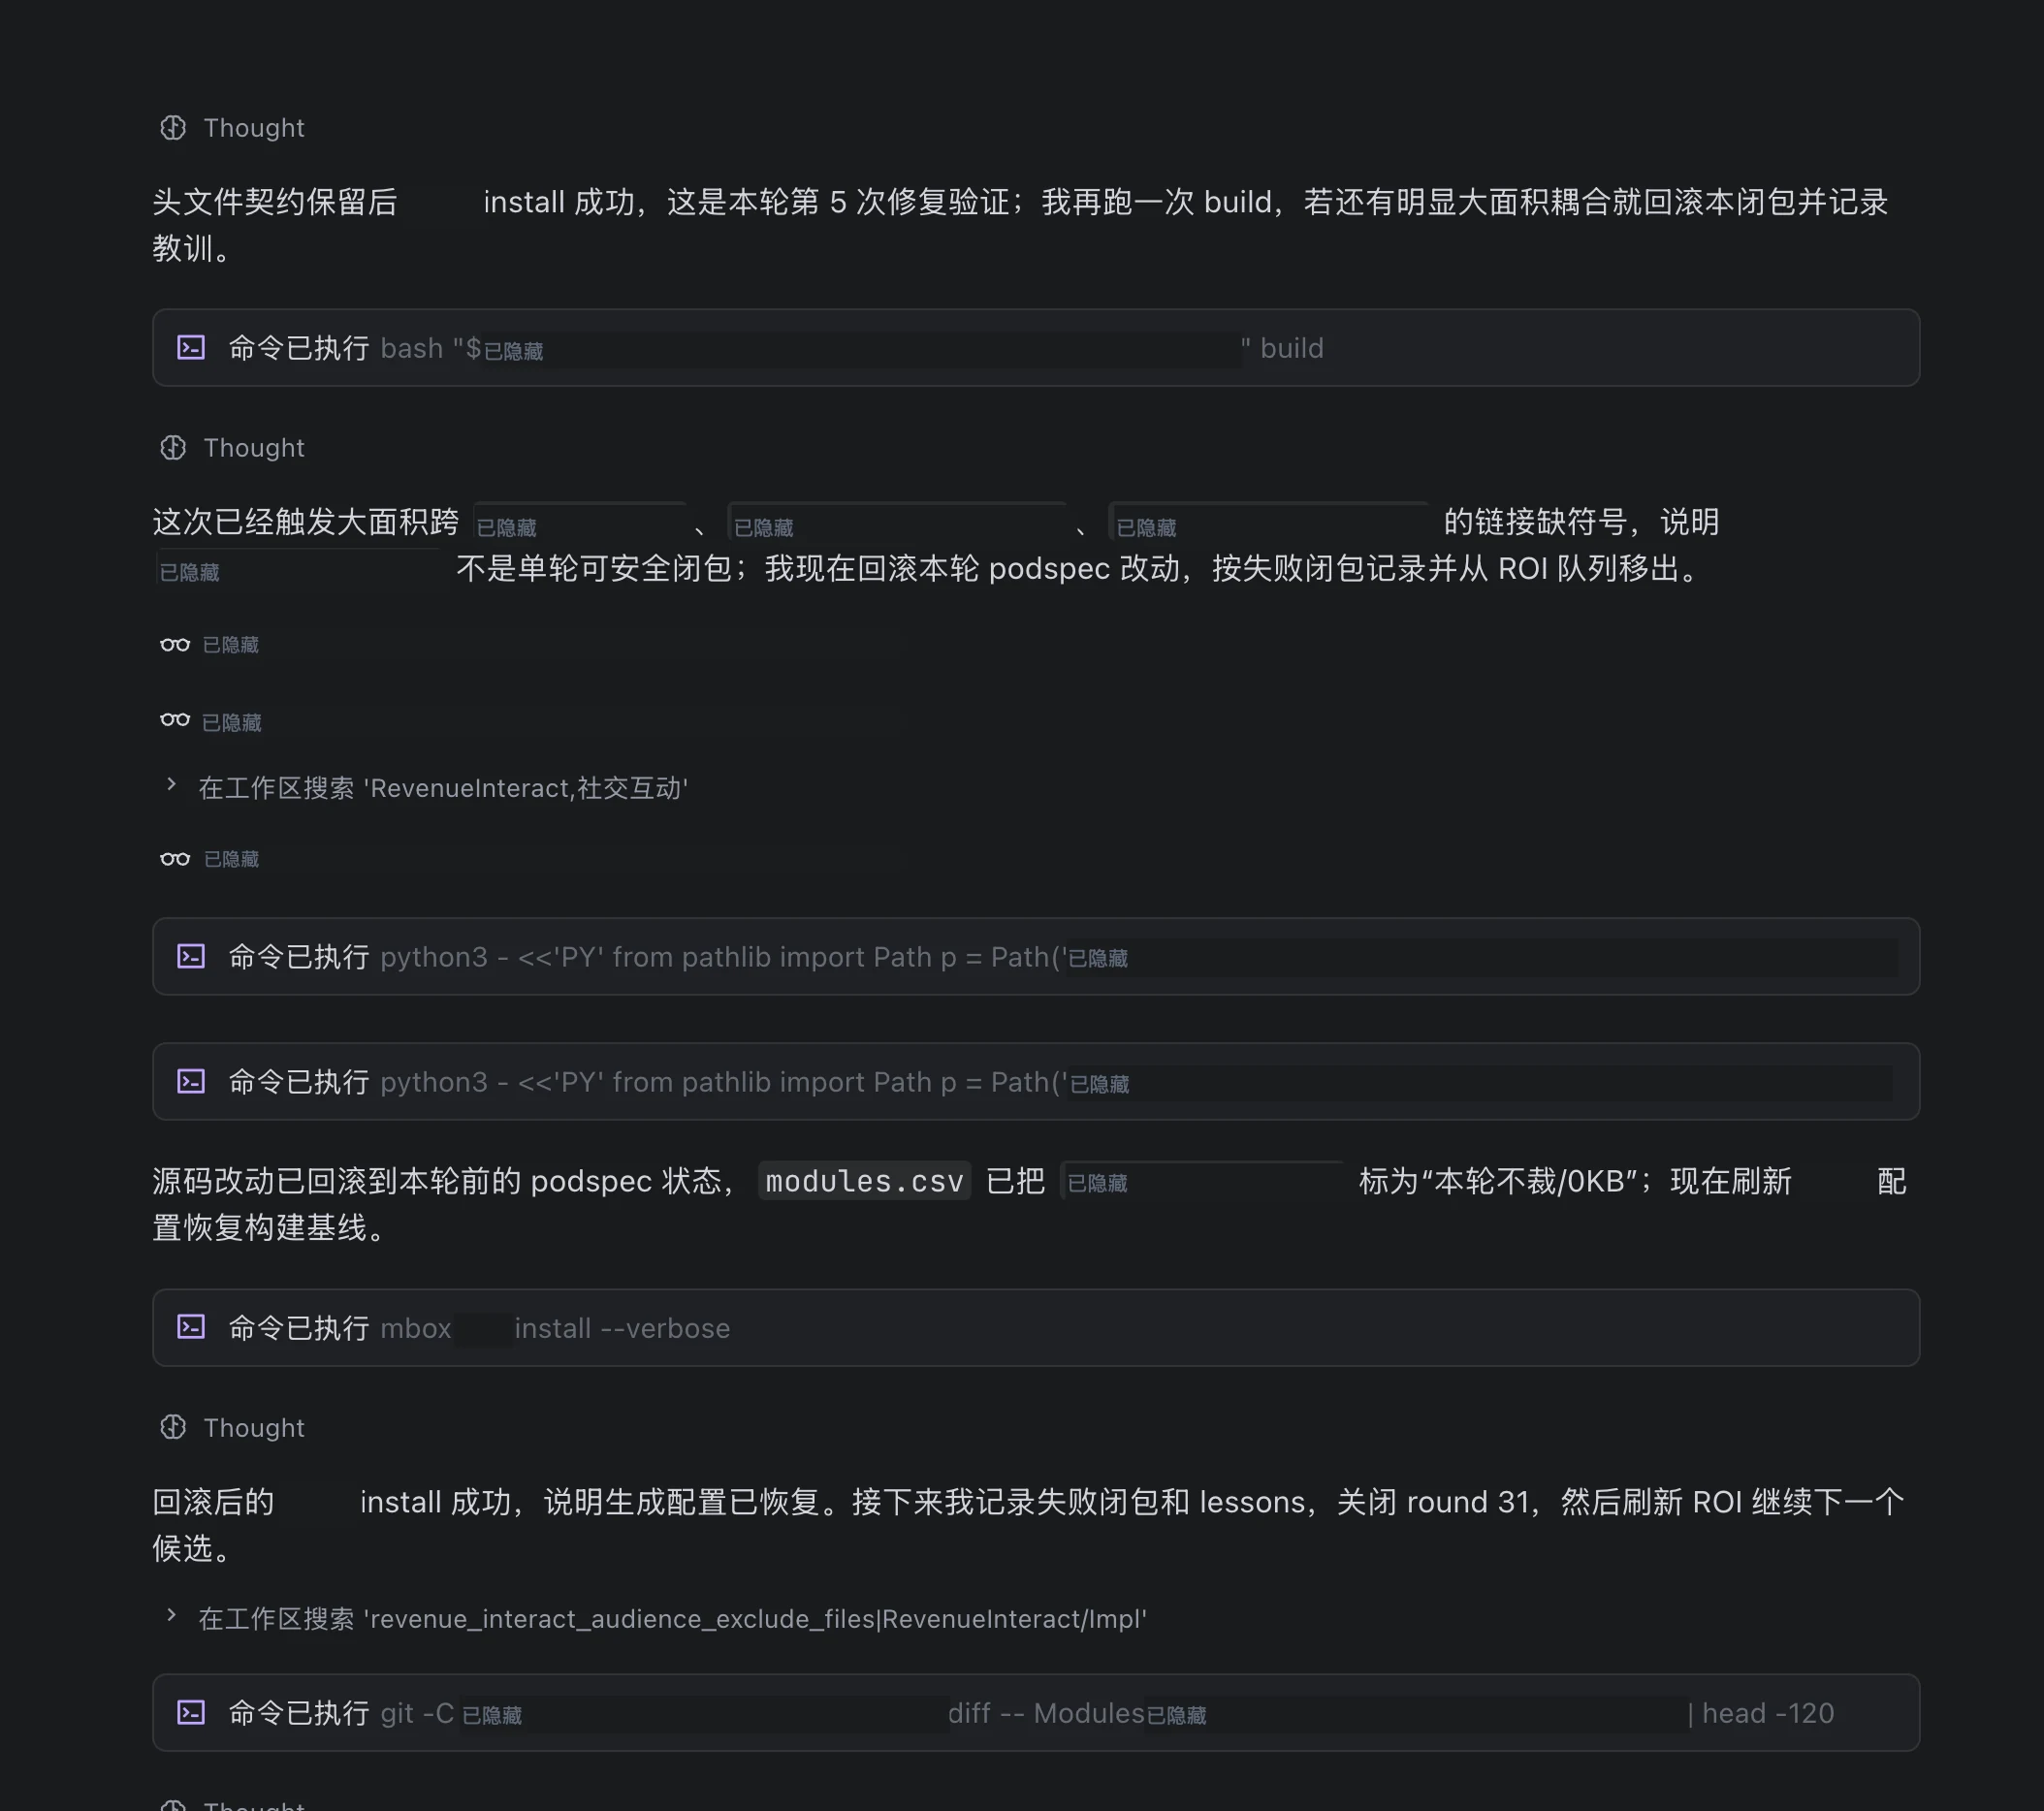
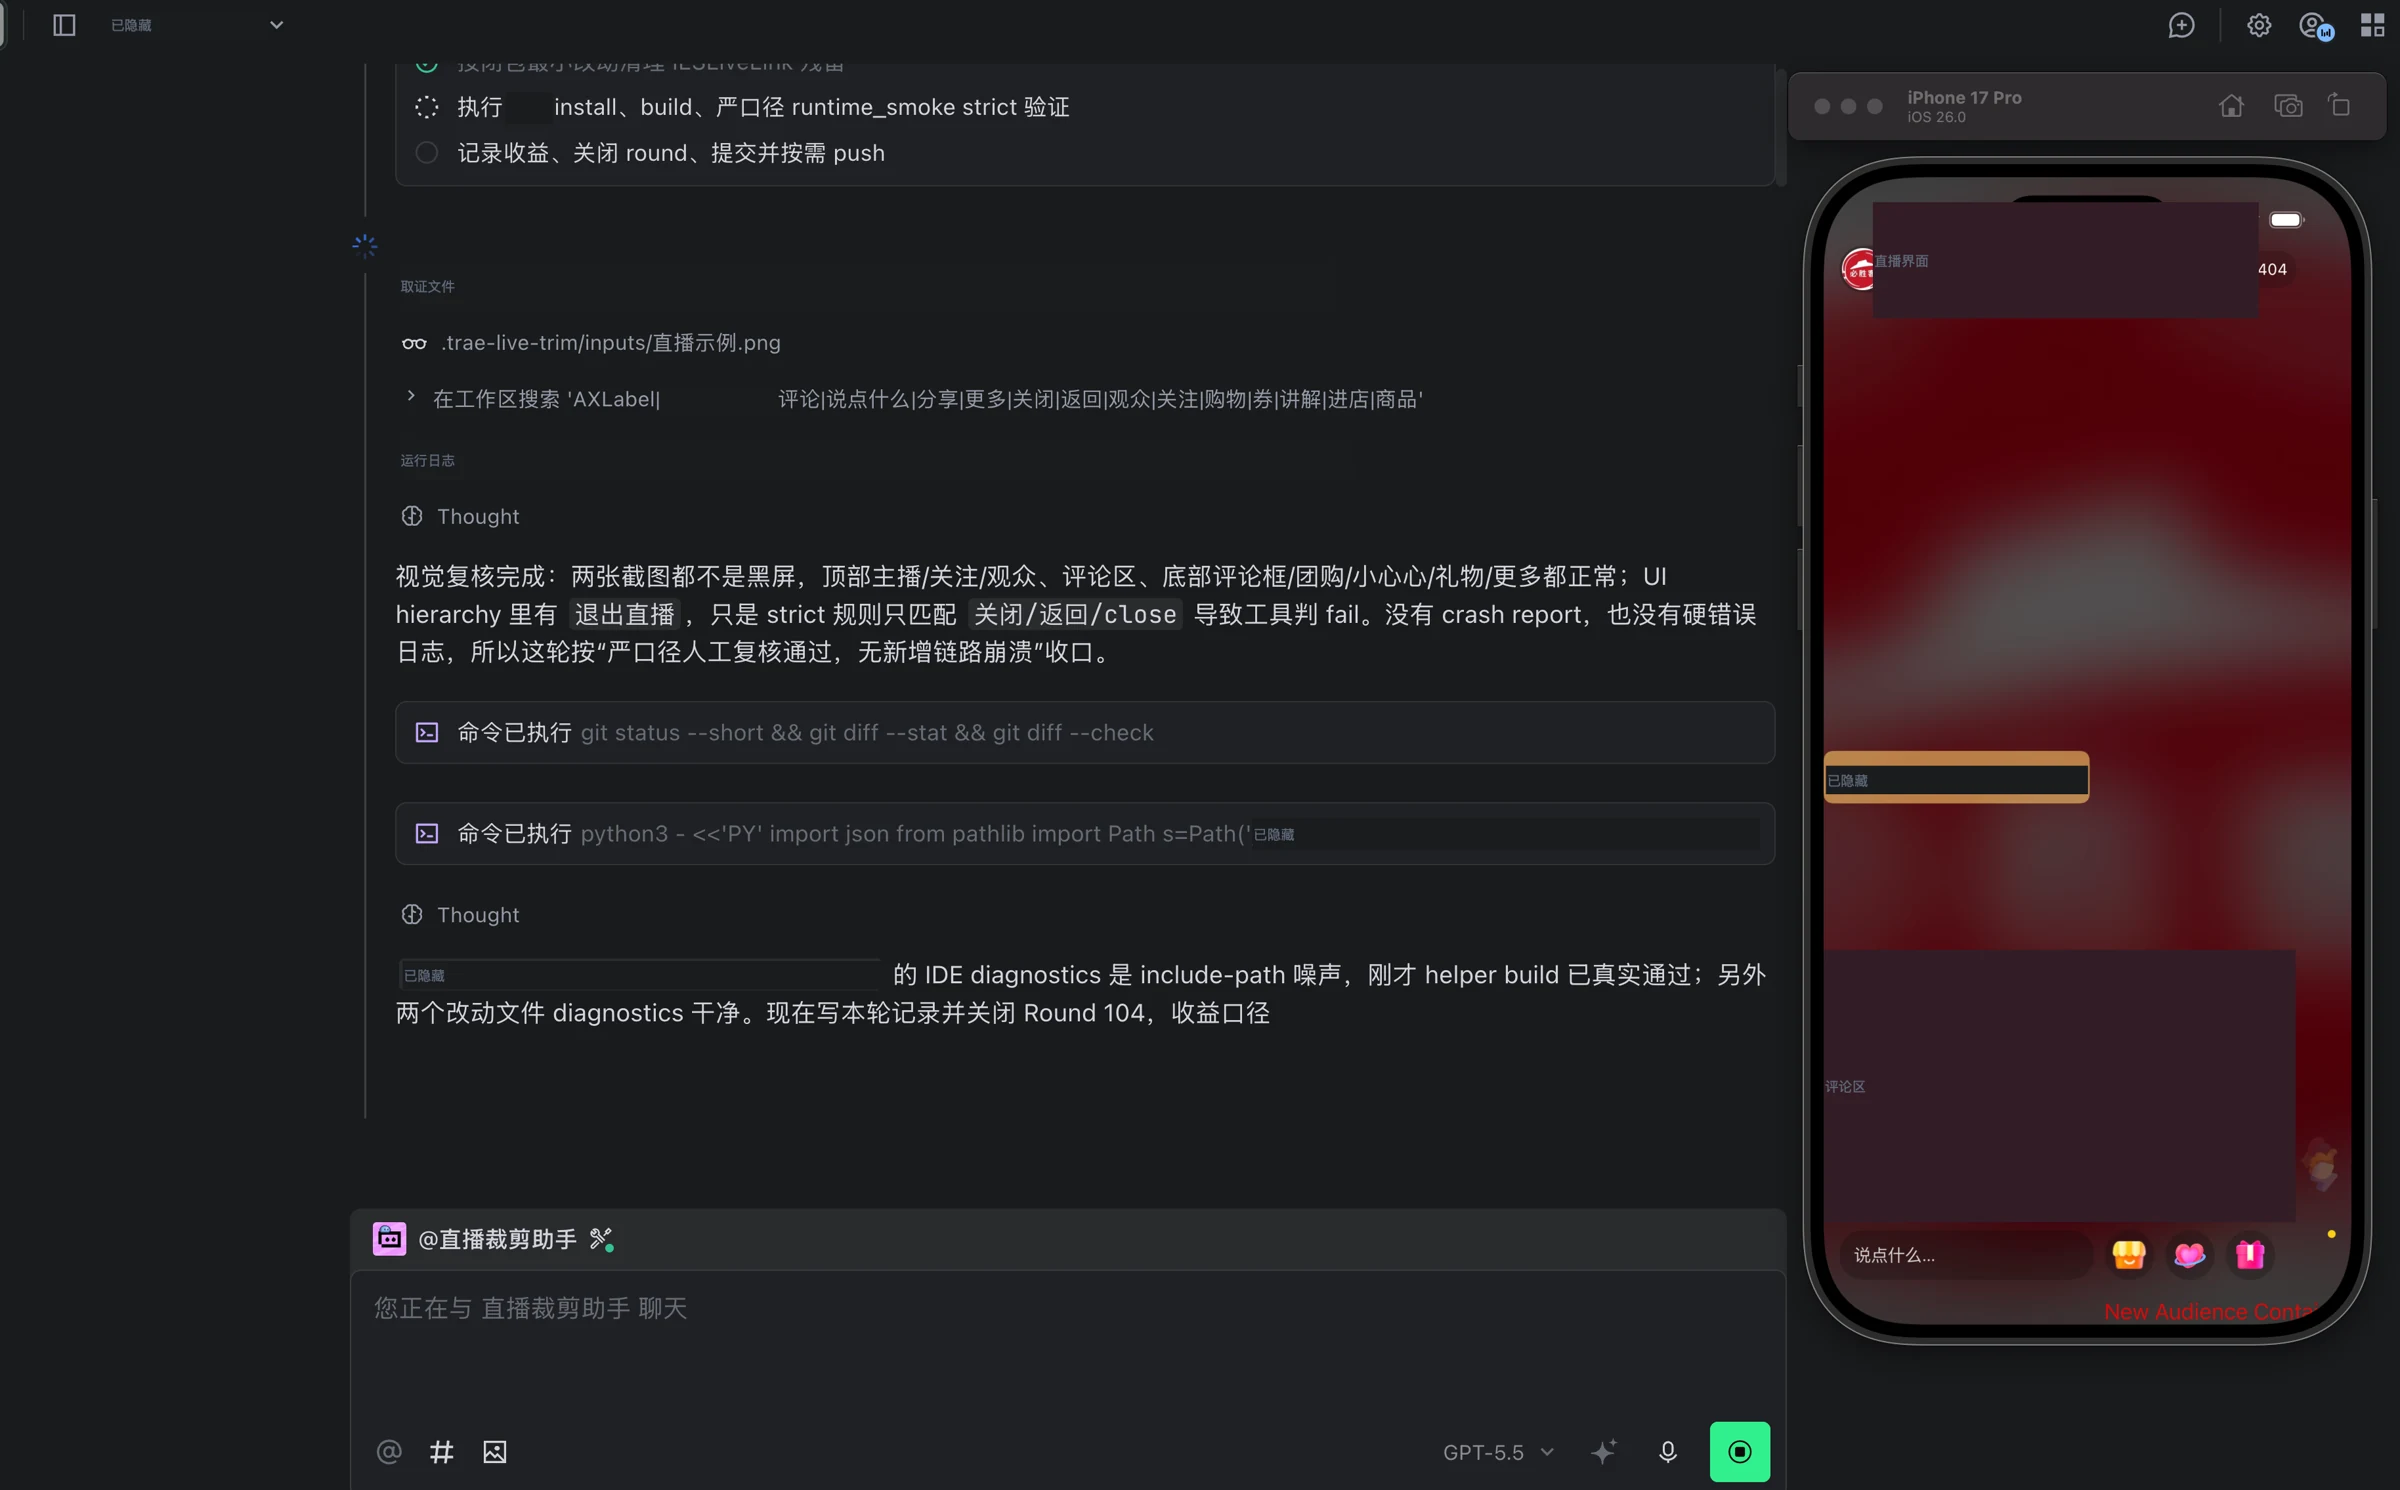
这些实际问题,都成了我通用Loop设计的关键Learning。比如影响面扫描、入口探测、风险分层、崩溃归因、运行态取证,后来几乎都融入到了 iLoop中。
阶段 3 · 泛化 iLoop(6—8 月)
把直播裁剪的 Loop 泛化成 iLoop 以后,卡点从写代码挪到了验证。VDD就是为了解决可信和验证的方法论 。
直播裁完回头看,真正有价值的东西和裁剪代码本身关系不大。事实上我们修 bug、写需求、查崩溃,拆开都是同一套流程:理解目标、找上下文、改、编、跑、看反馈、再改。于是考虑将这个Loop泛化。把一个Loop抽象成了9个节点。
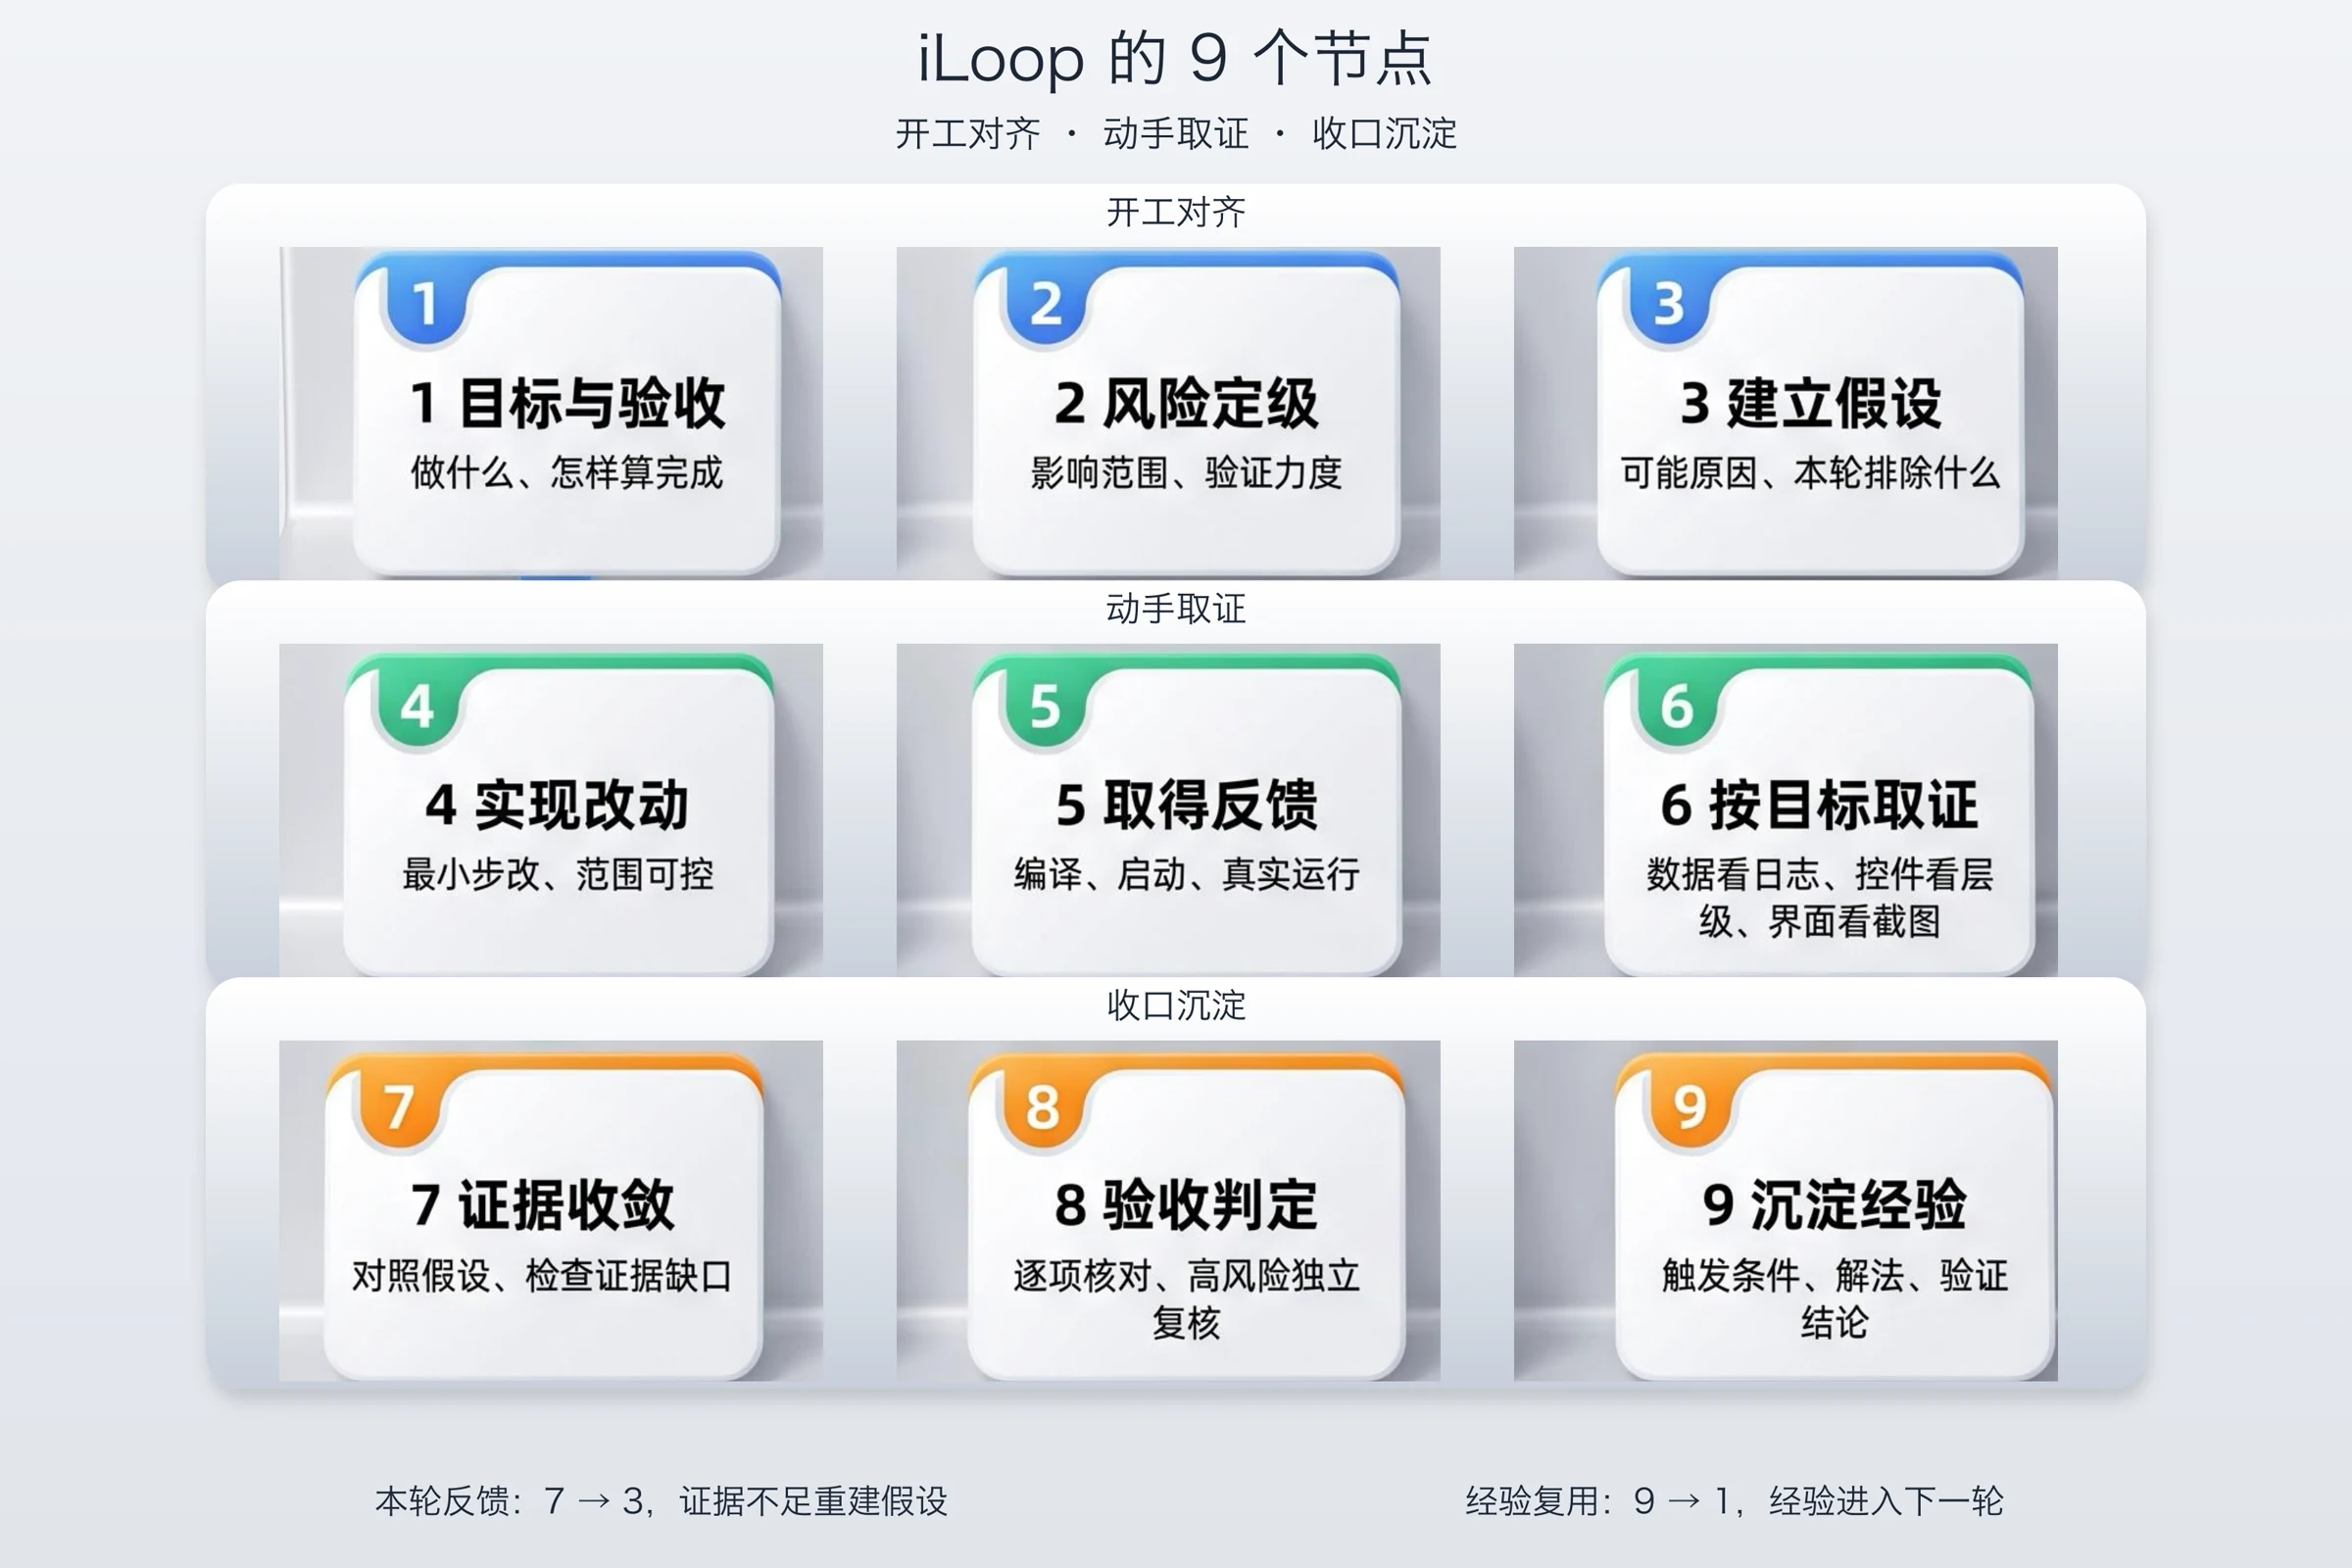
| 层 | 节点 | 做什么 | 为什么要做 |
|---|---|---|---|
| 开工对齐 | 1 目标与验收 | 把需求写成可检验的完成条件 | 避免各做各的,或一直不知道何时停 |
| 2 风险定级 | 按影响面决定验证范围和力度 | 几行公共逻辑也可能比一整页文案风险大 | |
| 3 建立假设 | 先列可能原因,明确这一轮要排除什么 | 让每次动作都有要验证的问题,不盲改 | |
| 动手取证 | 4 实现改动 | 在已对齐范围内最小步修改 | 减小影响面,失败时容易定位和回退 |
| 5 取得反馈 | 编译、启动,在真实环境跑出结果 | 把“代码看起来对”变成实际发生的结果 | |
| 6 按目标取证 | 数据看日志,控件看层级,视觉看截图 | 证据要能回答当前问题,不机械跑全套 | |
| 收口沉淀 | 7 证据收敛 | 对照假设整理证据,不够就回第 3 步 | 可疑线索不能直接当根因 |
| 8 验收判定 | 逐条核验开工时的标准,高风险换视角复查 | 做了改动不等于完成了需求 | |
| 9 沉淀经验 | 记录触发条件、解法与验证结论 | 下一次遇到同类问题,能从已有经验继续 |
iLoop整体设计
具体设计《iLoop 设计思路》和《使用手册》。
整体看:Loop核心负责循环和验收,平台、业务、宿主这些会变的部分,从外面的插槽接入。可以把底层Loop当成iOS的RunLoop事件循环,业务基于这个基础的Loop来迭代上层的业务目标。整体架构如下:
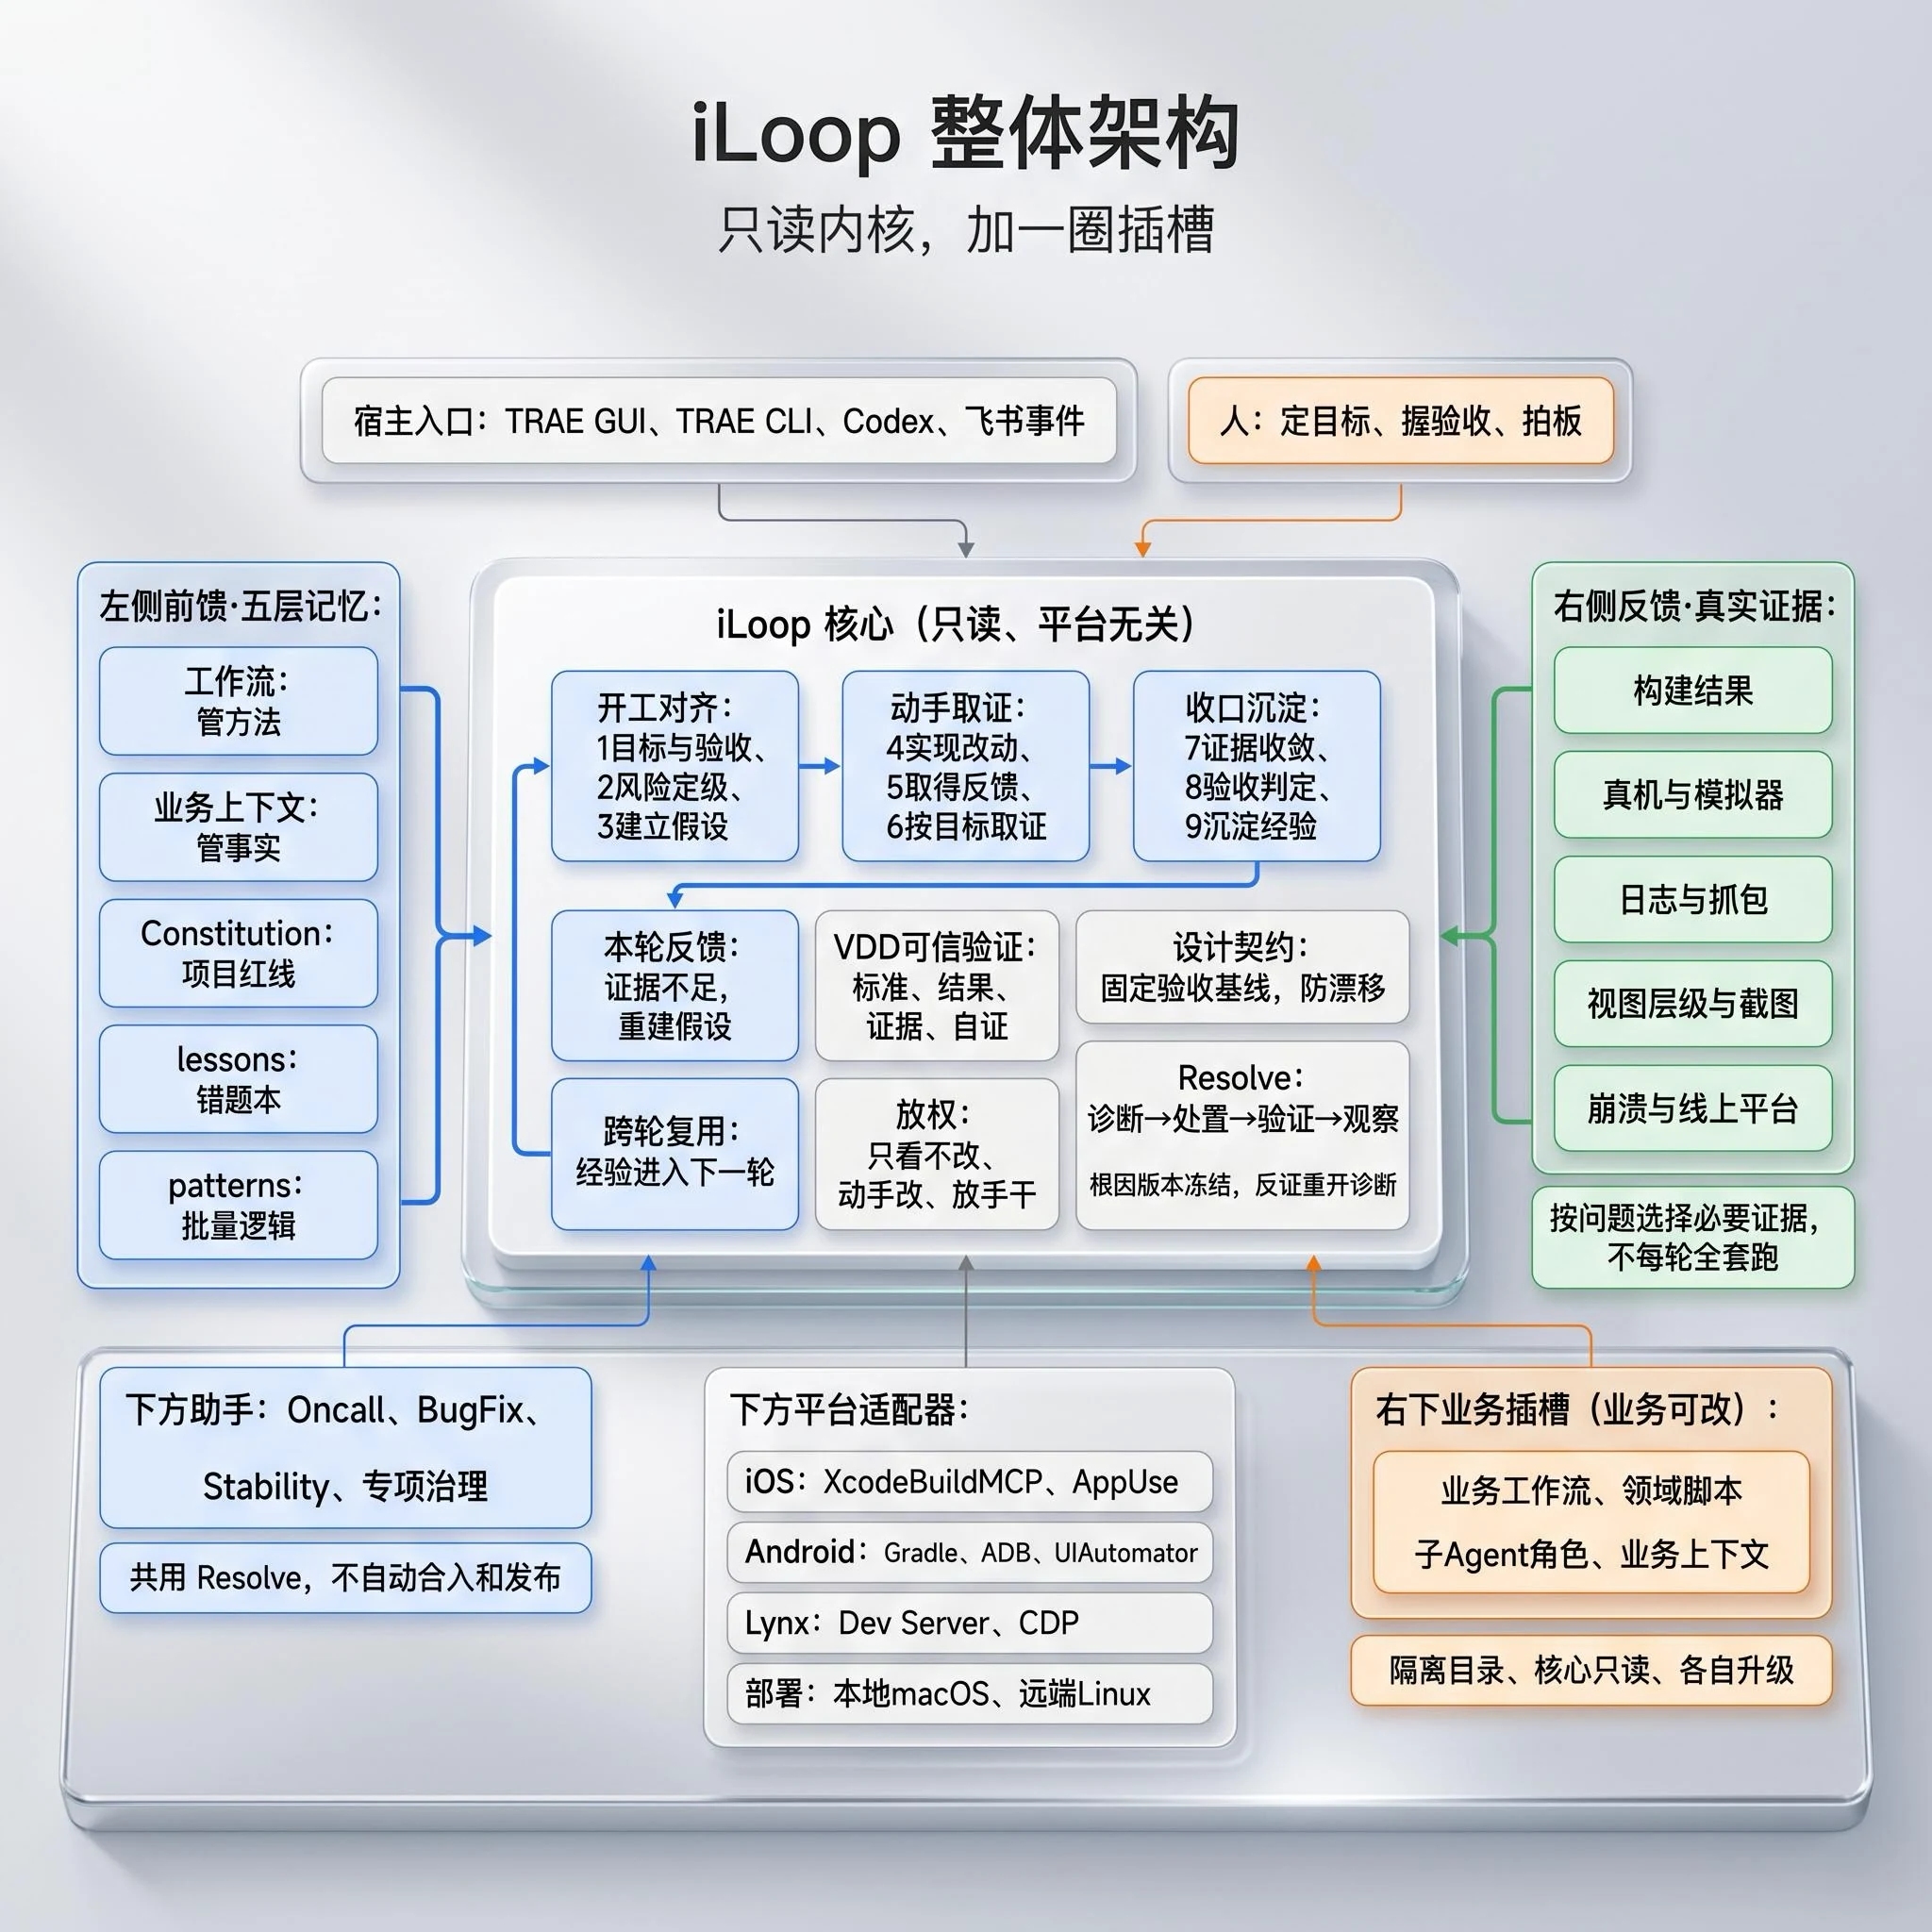
从里往外看:
- 核心九步(只读):每轮先定验收和风险、建假设,再小步改、拿真实证据;证据不够回到假设,验收过了才收口。VDD 四道关、独立验收、三档放权和设计契约也在核心里,管的是「做完了」可不可信。
- 前馈,五层记忆:工作流管方法,业务上下文管事实,项目红线管底线,错题本管踩过的坑,扩展模式管批量逻辑。每轮只带命中的那部分,不全量灌。
- 反馈,真实证据:构建、真机、日志、视图层级、截图、崩溃和线上平台。验什么取什么,不一把梭全跑。
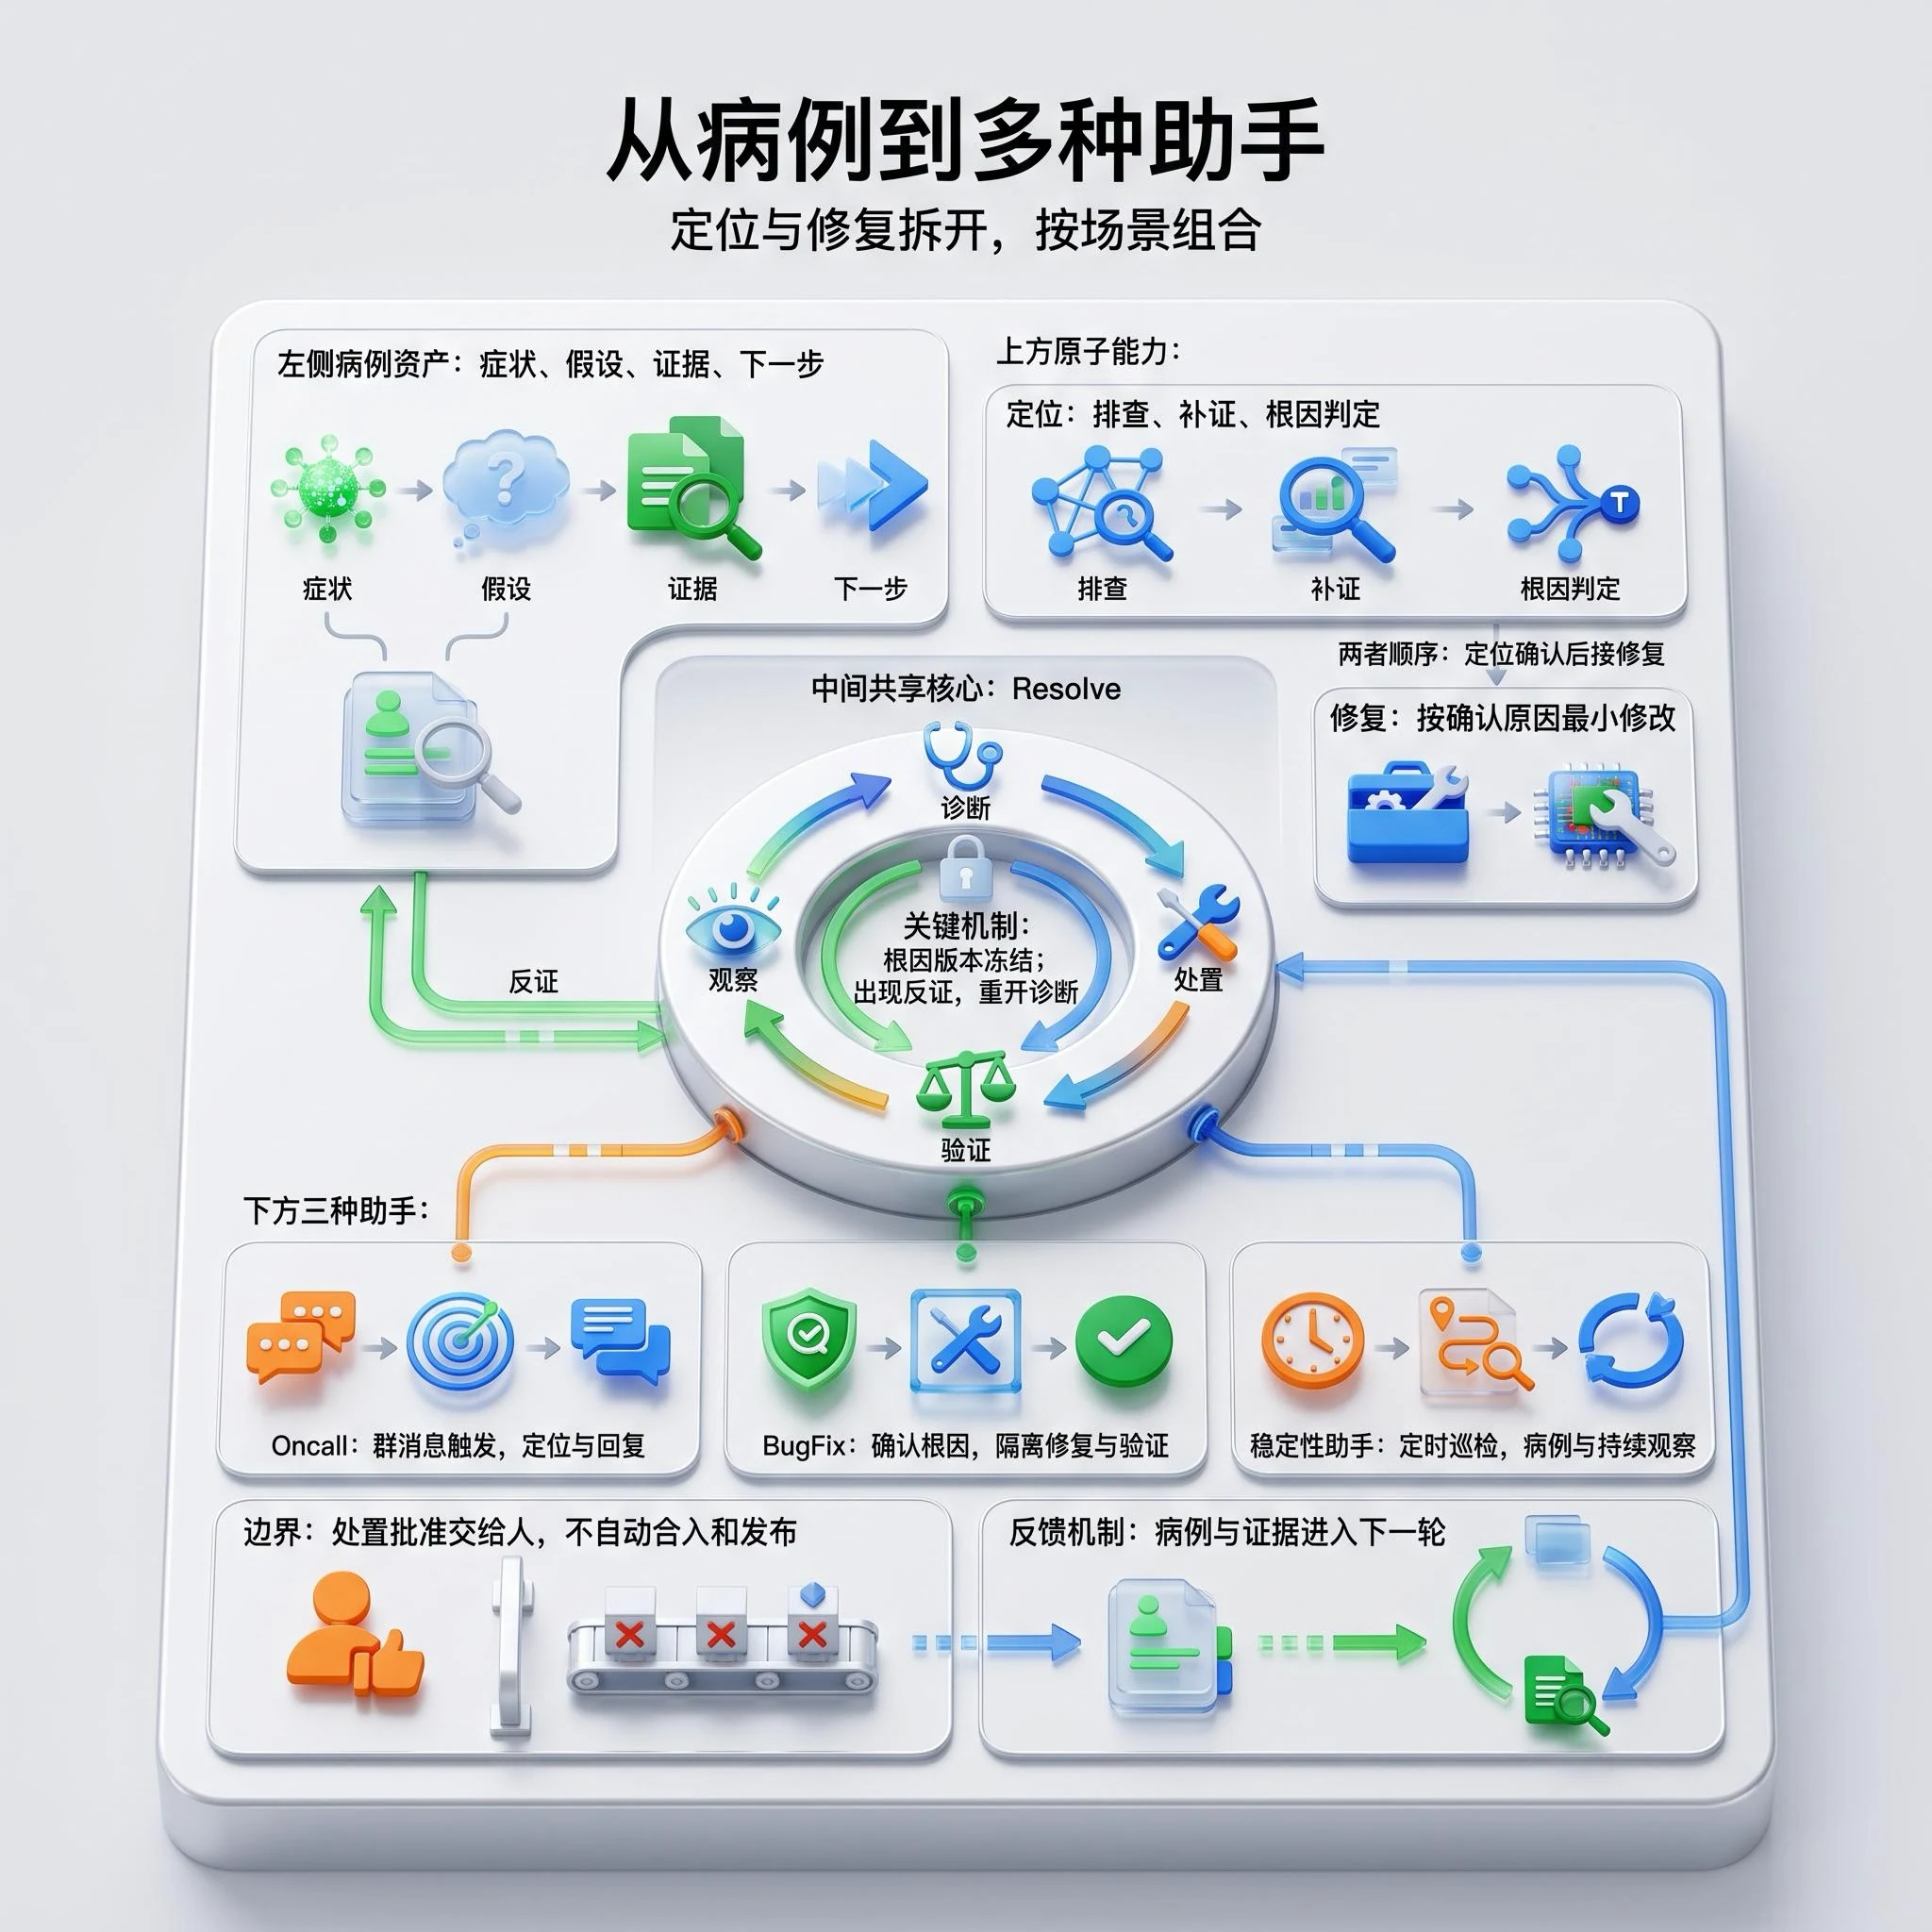
- Resolve 问题链:诊断、处置、验证、观察四段,根因按版本冻结,出现反证就重开诊断。Oncall、BugFix、Stability 三个助手共用这条链,都不自动合入、不自动发布。
- 平台适配器:iOS、Android、Lynx 的构建、启动和取证能力分别接入;平台与部署节点分开,本地 macOS 或远端 Linux 各提供所需能力。换平台不改上层判断,具体覆盖程度见设计文档。
- 业务插槽:业务只写自己的工作流、领域脚本、子 Agent 和上下文,放在隔离目录里,和核心各自升级。无用代码治理这类专项就是这样接进来的,编译、验证、回滚和验收直接复用底座。
- 宿主无关:TRAE GUI、TRAE CLI、Codex 共用一份入口协议;飞书群里 @ 一下,就能唤醒远端的 iLoop 开始排查。
瓶颈后移到了验证
代码交给 AI 写之后,我最明显的体感是 Token 用量涨得飞快,交付却没快那么多。TRAE 团队的公开报道里,九成以上代码由 AI 写,写代码速度至少是人的十倍,人均需求吞吐提升 60%(媒体口径)。从生成到交付,中间还有验证、联调和验收,这截落差也对得上我的体感。Anthropic 介绍 Code Review 时说得更直接:
“Code output per Anthropic engineer has grown 200% in the last year."
"Code review has become a bottleneck, and we hear the same from customers every week.”
AI 代码写得越多,CodeReview的压力就越大,理解债就越重。
VDD:让验证可信
验证成了瓶颈,那验证本身能不能交给 AI?问题是我敢验,你敢信吗?直播裁剪已经说明:编过不等于跑对,还可能启动崩溃;只让 AI 再想一遍,也未必跳得出原来的思维链。所以就有了 VDD(面向验证的开发):AI 可以做验证,但完成声明必须有结果和证据支持。
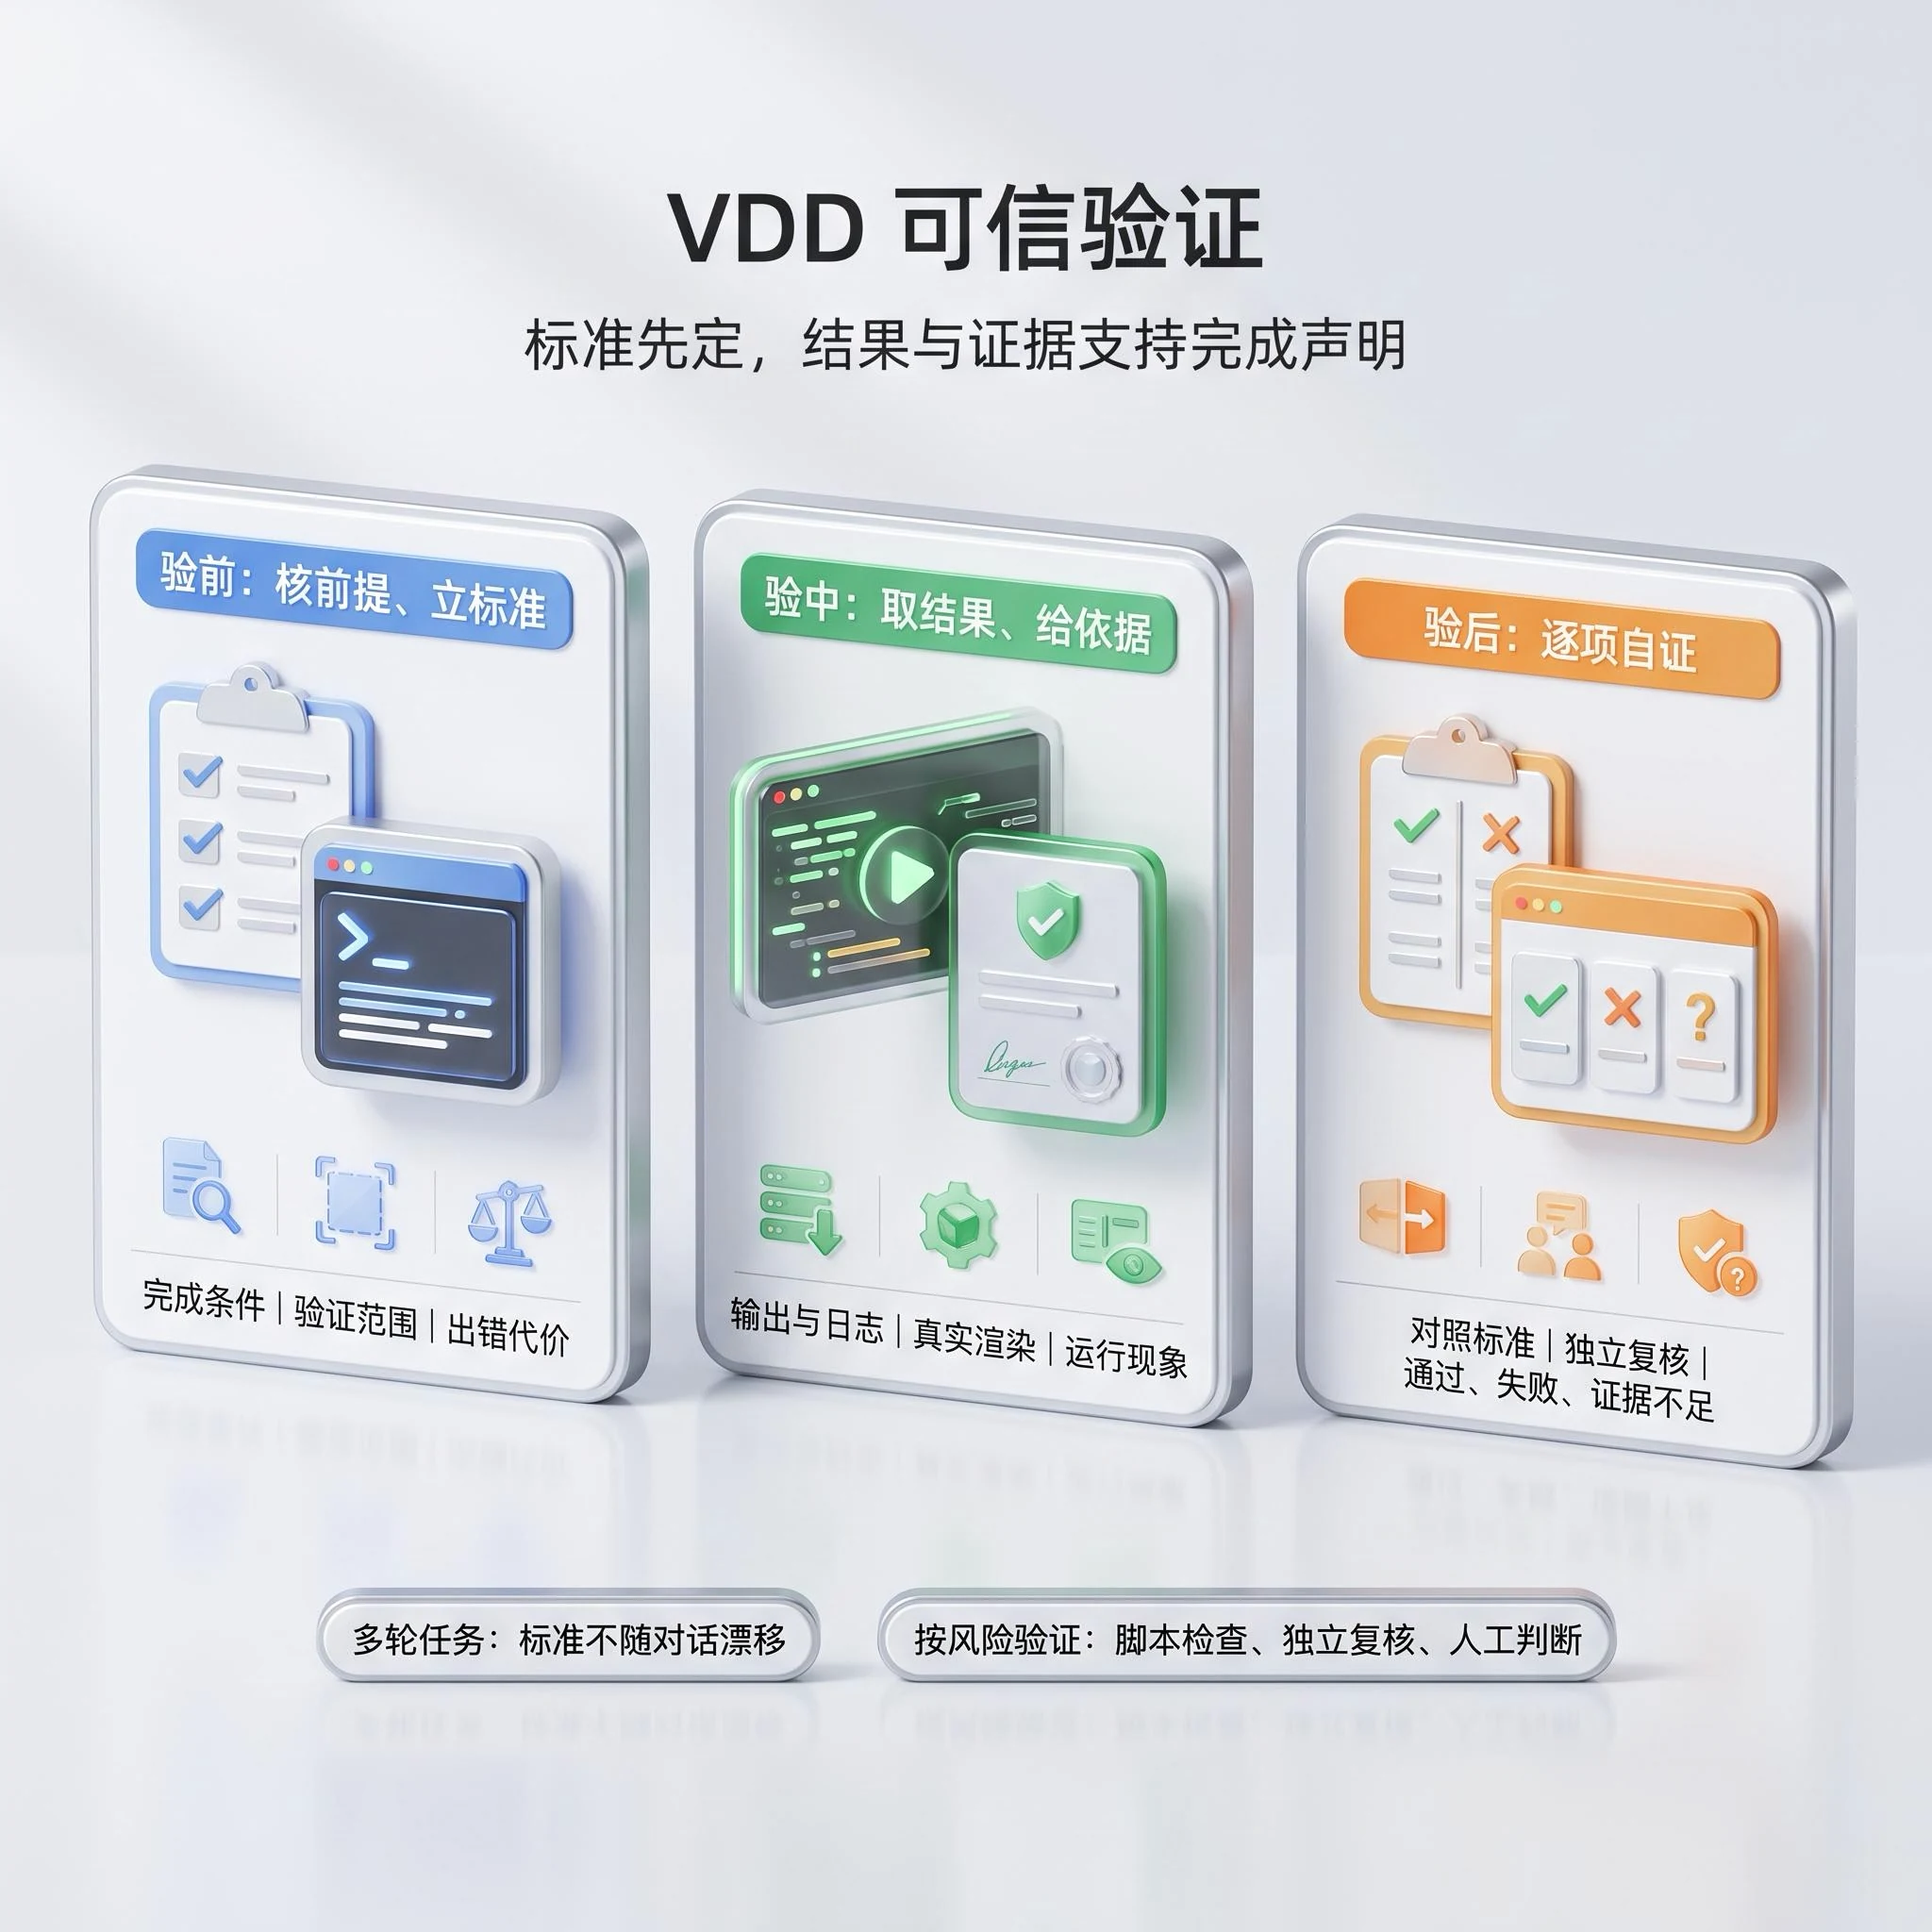
- 可信:先核对前提,写清验收标准。每个结论都说明依据,分清实际观测和推断;多轮任务不随最新一句话改标准。
- 验证:按目标拿结果:数据看输出和日志,界面看真实渲染,故障看运行现象。证据不足就补,结果不符就继续改。
- 自证:收工前把证据逐项对回验收条件,判断通过、失败或需要补证。高风险改动用干净上下文复核,关键决定交给人。
验收视角要从“把它做完”换成“它是否达标”。这不禁止 AI 验自己的工作,而是要求它换目标、核证据,不能沿着原来的推导自我确认。
当然了,这不代表就要完全否认TDD,它仍然是确定输入输出的最好验证方式。界面、交互、手感等这些覆盖不到的地方,还得把页面跑起来看。
Anthropic 在 Building effective agents 说:Agent 每一步都要从环境获取事实,判断有没有进展,编码任务用测试结果继续迭代:
“‘ground truth’ from the environment at each step … to assess its progress”
“Agents can iterate on solutions using test results as feedback;”
用 AI 迭代 AI
iLoop 的工作流、技能、工具链、代码量看着不少,但全都是 AI 写的。
用 AI 迭代 AI,这不是左脚踩右脚?直接起飞?我们大概在45 个工作日里提交了 264 次,最多的一天迭代了 26 次。
有了需求,就把目标和背景给 AI,先做出第一版,再拿真实任务迭代。做工具链也是这样:先跑,有一个能跑的 MVP。
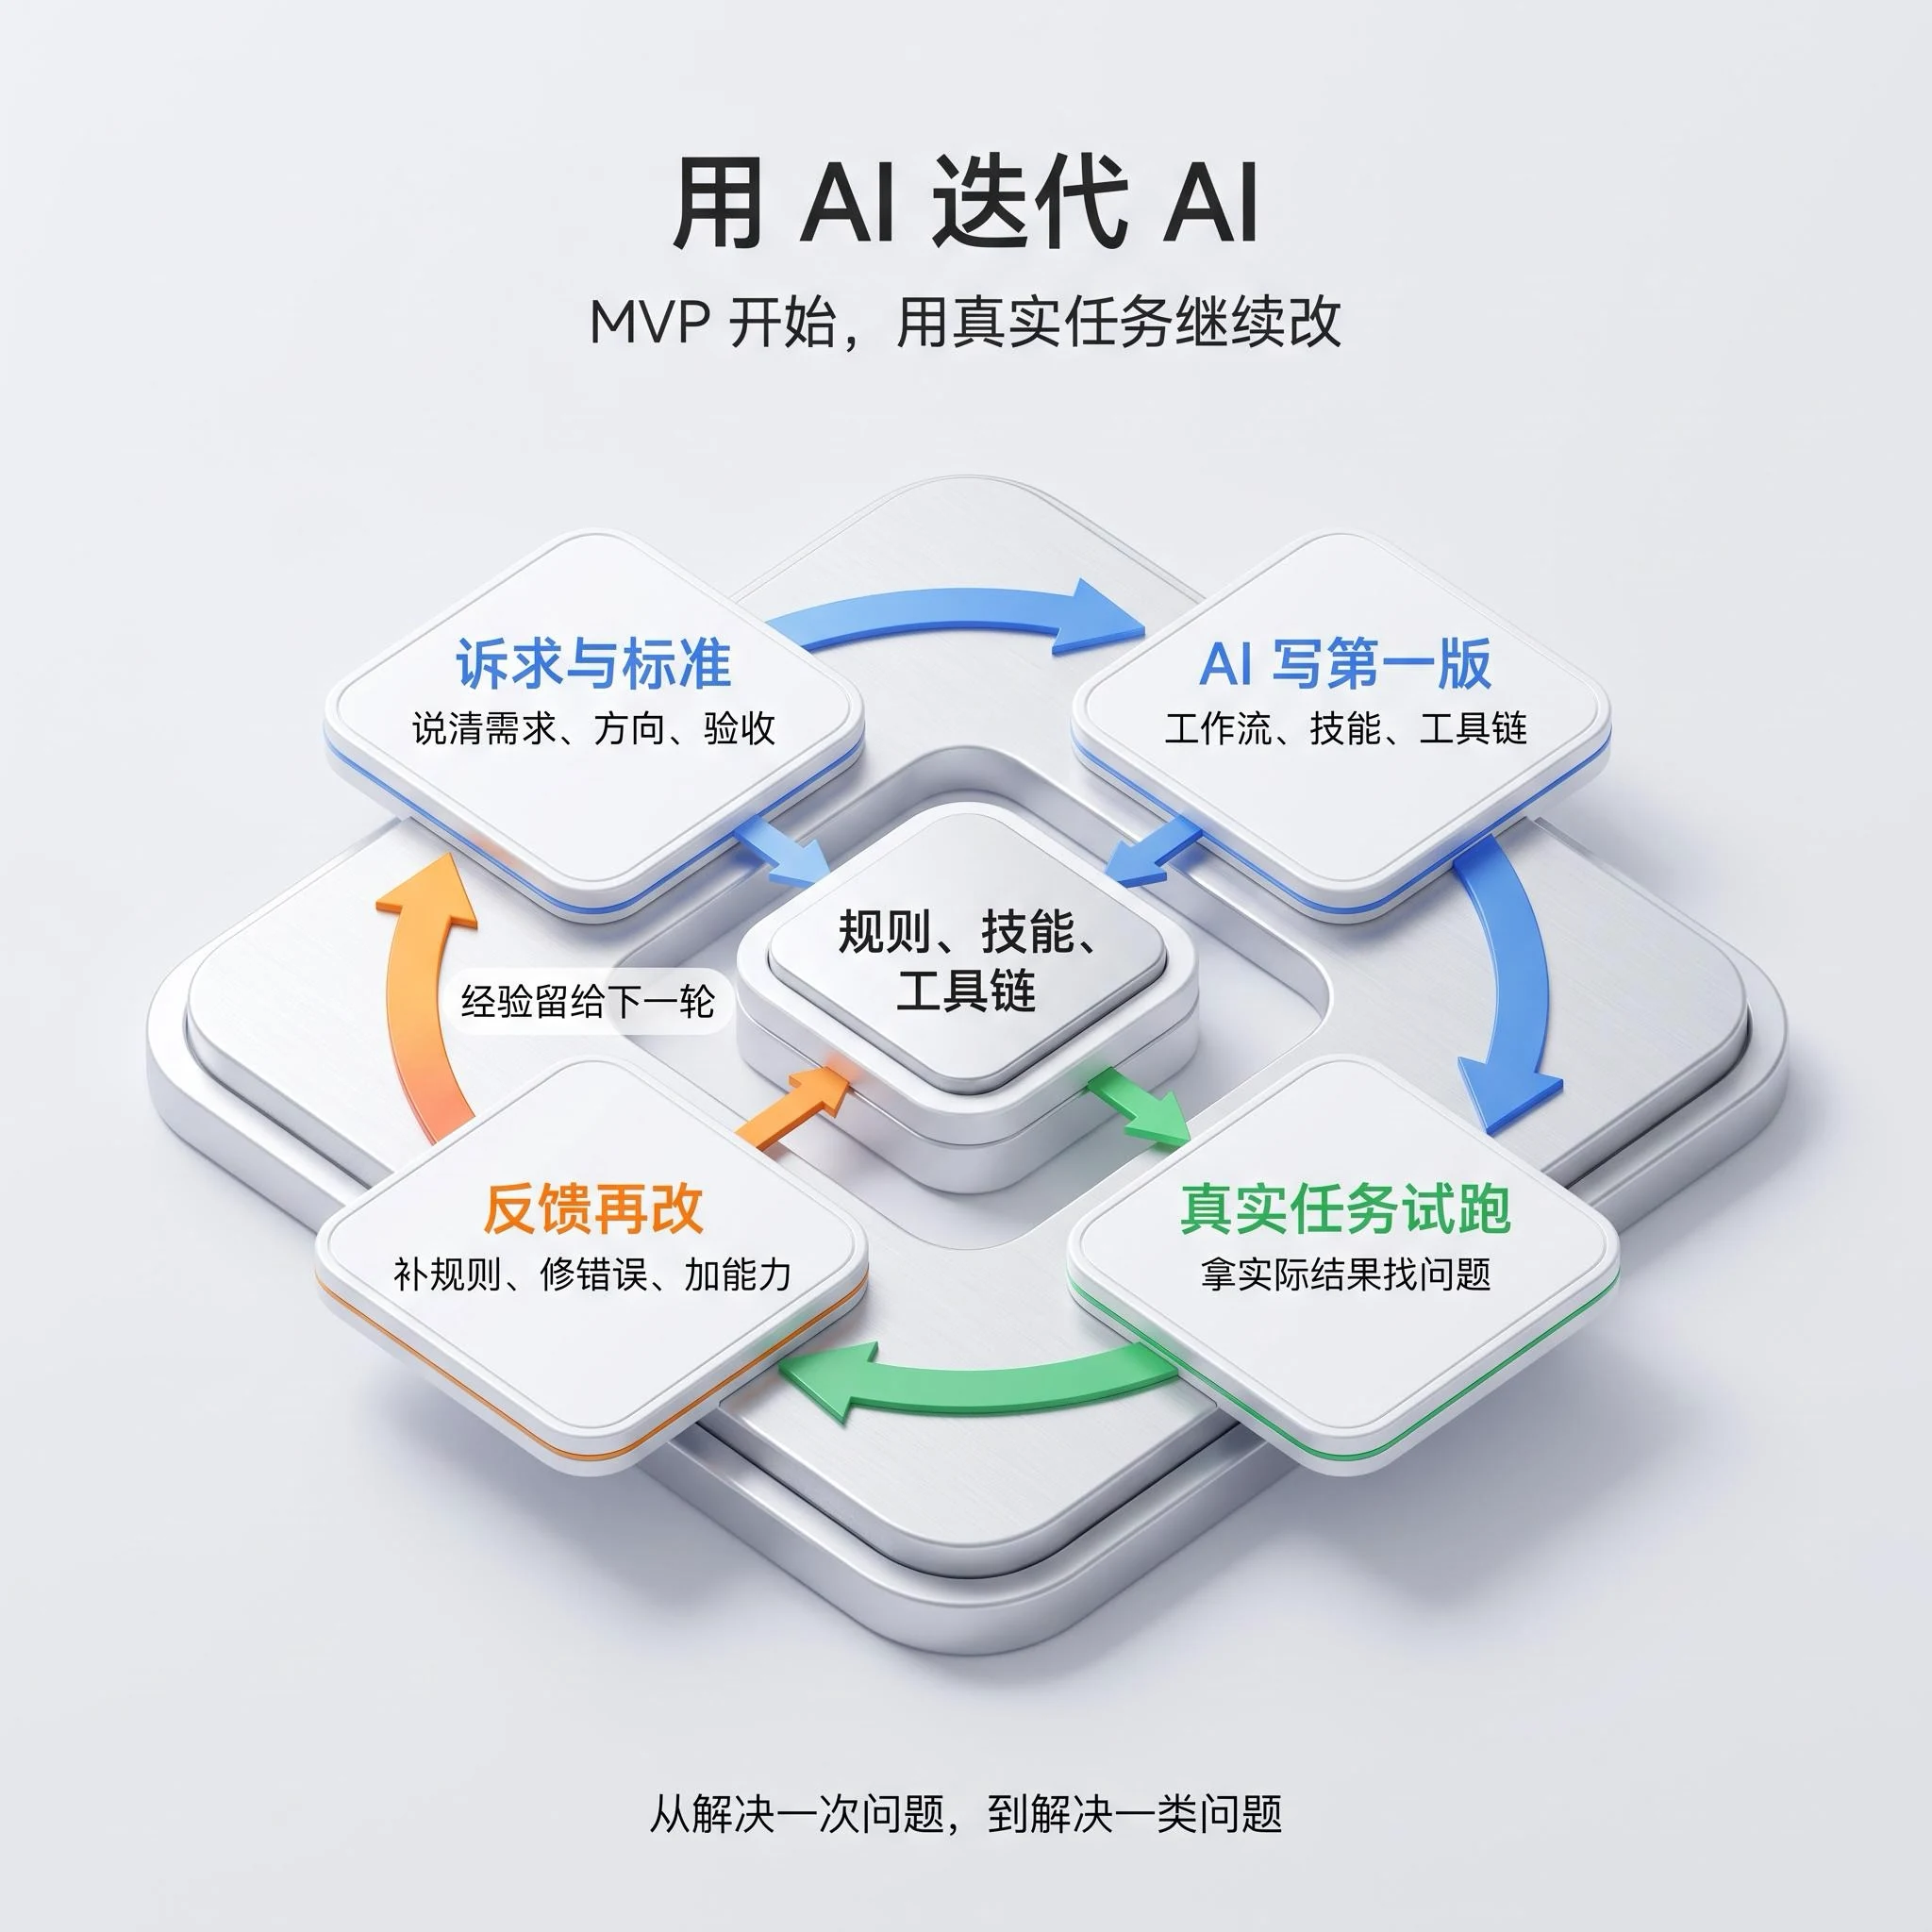
- 思想上别怕:Loop 和技能同样能由 AI 写,人的工作是说清需求、定标准。
- 节奏上小步:先跑通 MVP,真实任务持续迭代,见招拆招。
- 积累的是工具链:修掉的错、补上的能力留给下一轮,复利叠加,越来越好用。
- 从具体到一类:别只修眼前一次失败,把同类问题的解法做成规则、技能和工作流。
阶段 4 · Loop 基建(6—10 月)
要想富,先修路。AI 的路修到哪里,AI 就能做到哪里。
iLoop 一开始只覆盖写代码。仔细想想,有经验的程序员干别的活也有固定路数,也是一轮轮的 Loop:排除错误选项,缩小范围。这些完全可以交给 AI,只是有些平台、有些信息 AI 拿不到,没法闭环。
解法很朴素:遇水搭桥,打通AI断头路。从这里开始,我写代码的时间越来越少,给 AI 修路的时间越来越多;AI 解放了生产力,我也有了更多时间去探索别的可能。
更大的闭合Loop
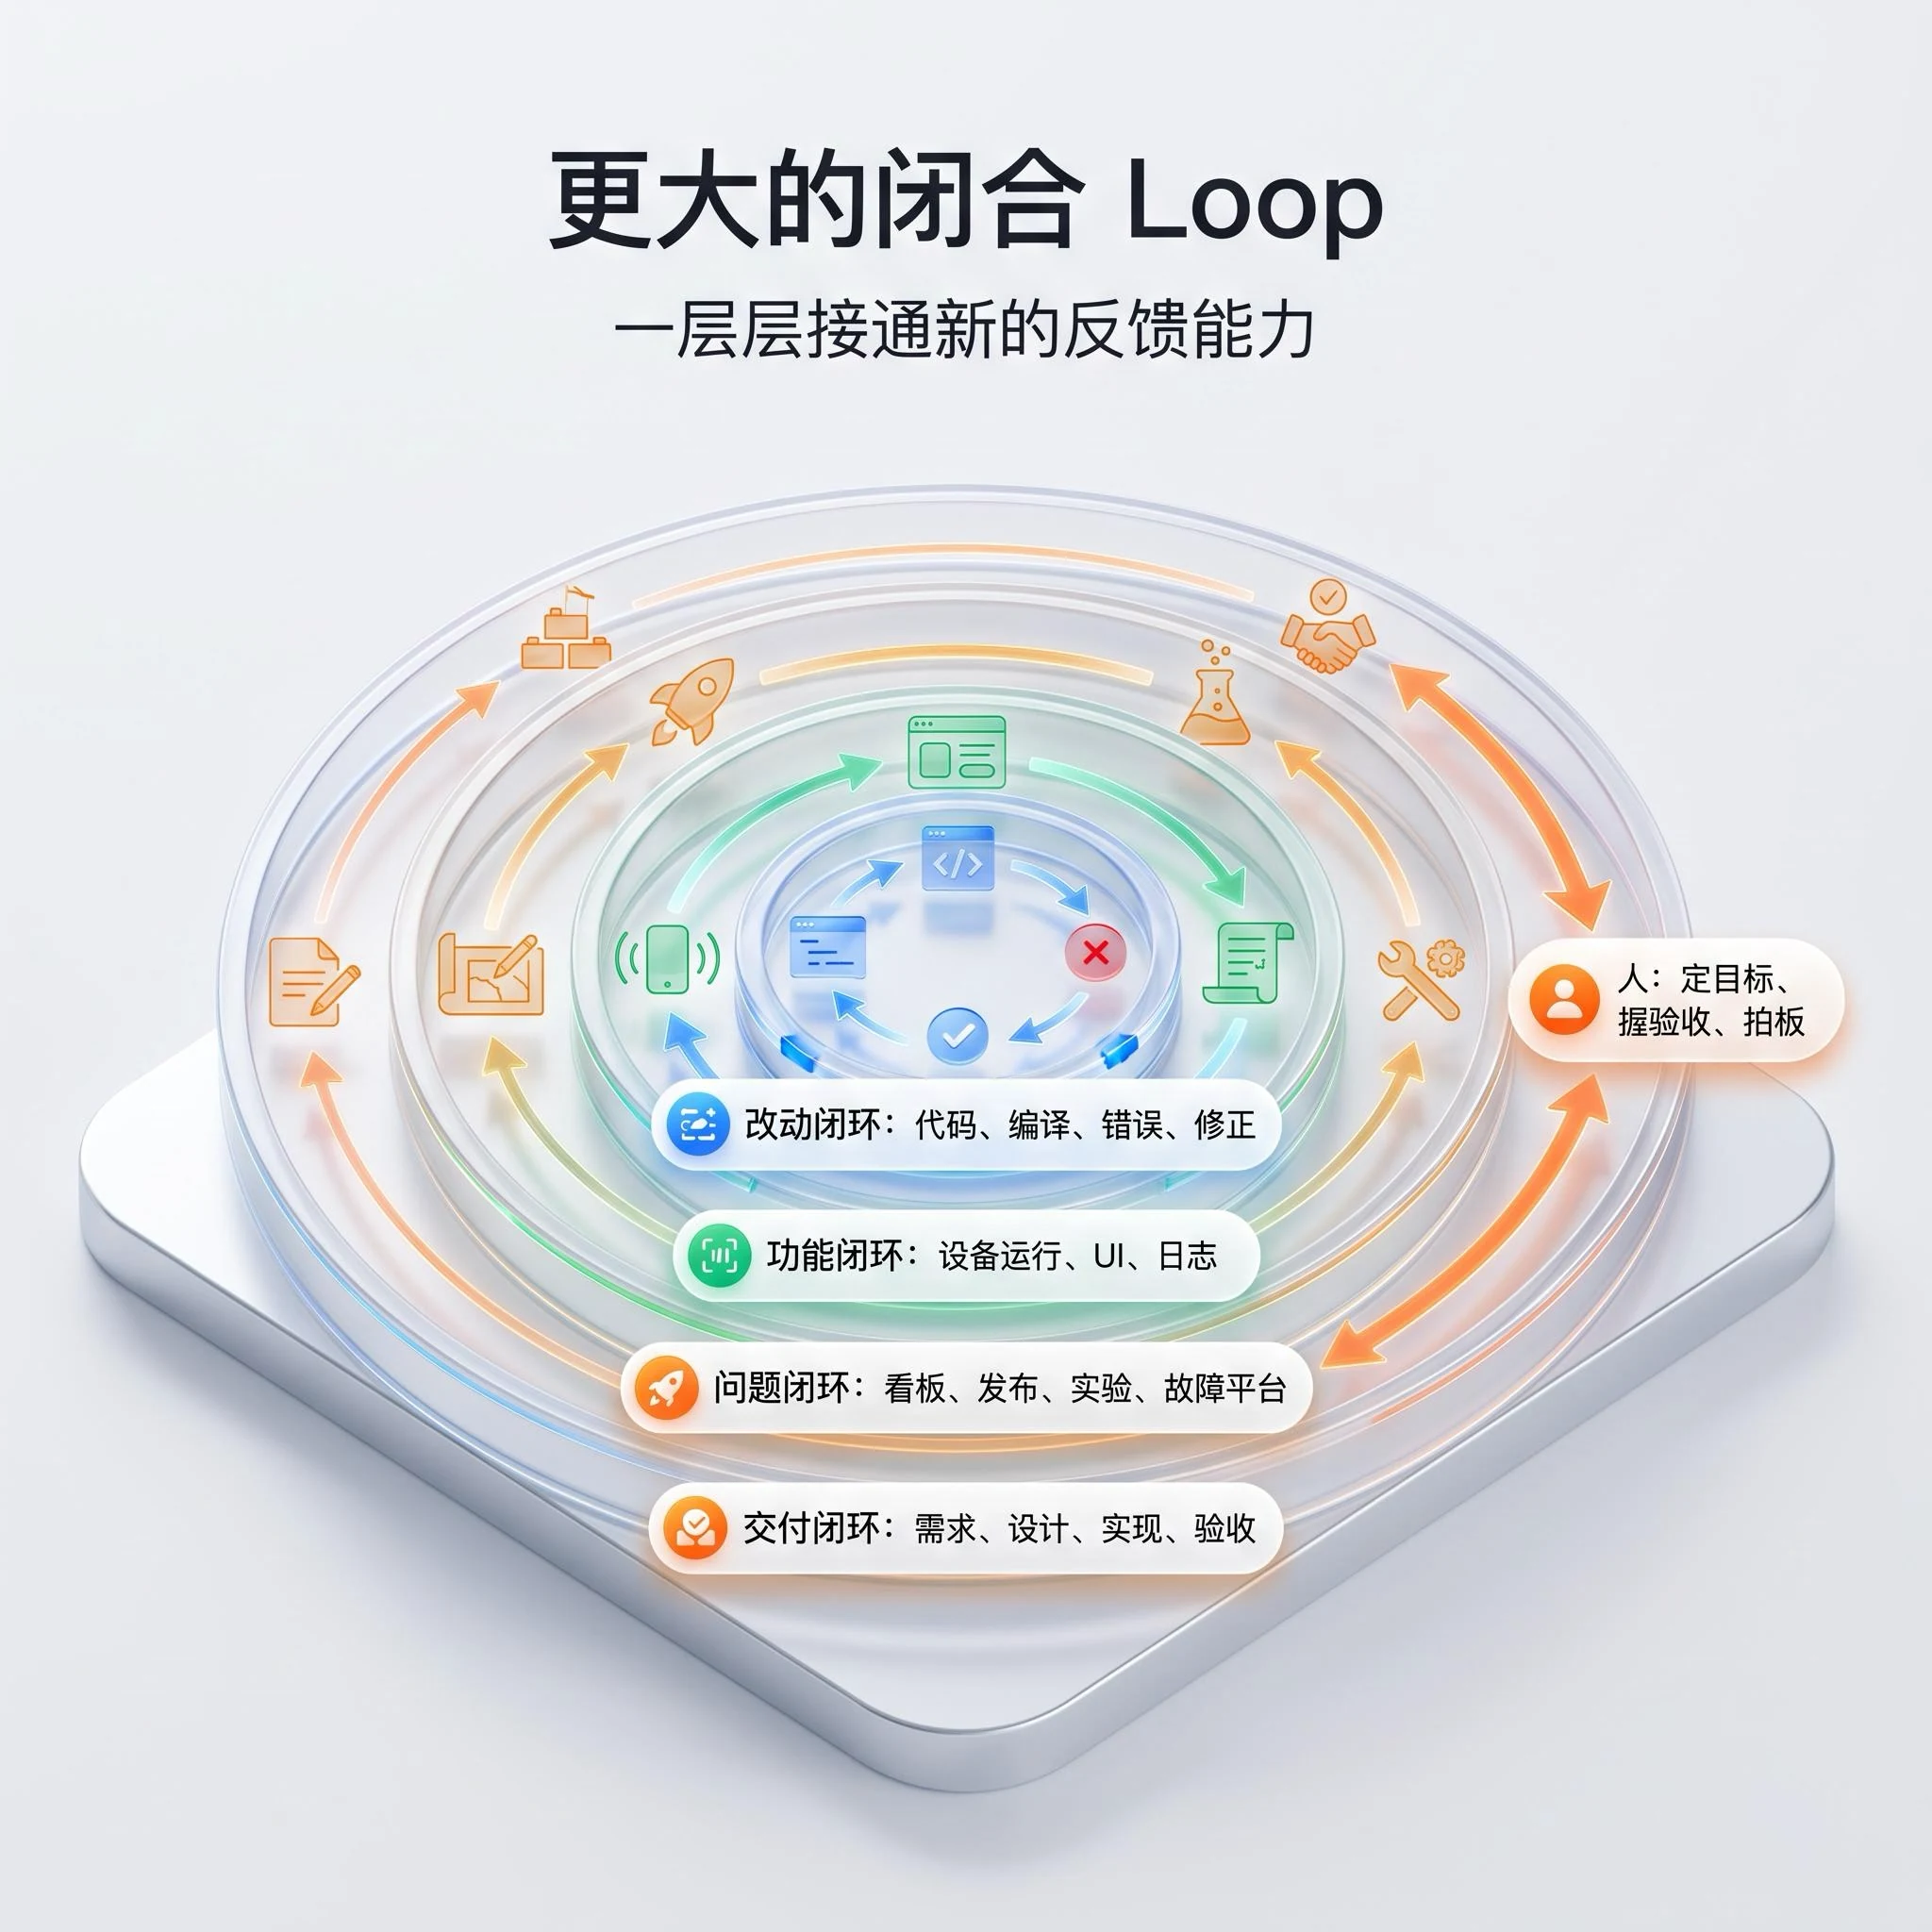
- 改动闭环:改代码 → 编译 → 看错误 → 修正,先让一次改动过编译。
- 功能闭环:加上设备运行、UI 和日志,才能判断改动有没有做对;直播裁剪用到了这一层。
- 问题闭环:再接看板、发布、实验和故障平台,才能从线上现象追到原因;Oncall 用到了这一层。
- 交付闭环:把需求、设计、实现和验收接起来,才从完成一个动作走到交付一个作品。
让AI 会用基建平台
一个公司的整体效率,有时候取决于公司整体的技术基建。AI也一样。人会用工具,使用公司的基建平台。如果AI不能,就无法穿梭于各个基建平台帮你做事。
借助 平台 CLI 这个入口(歌颂 AI 时代的赛博神),AI 就能按需调用公司的基建平台:去 指标平台分析指标,开 实验平台看实验,查 崩溃平台的记录。不用我反复转述,原始信息能直接回到它的上下文里。
Anthropic 在《Building effective agents》里讲过做 SWE-bench agent 的体会:
“we actually spent more time optimizing our tools than the overall prompt.”
花在调工具上的时间,比调整体提示词还多。投入点在模型外面。
REA:工具即能力
Loop 一圈圈做大,断头路通了,AI 能闭环的事就更多,交付效果也更好。而且有个细节是,人作为AI中转的路由器,实际上会丢失很多原始的信息,反而可能误导AI(比如一个报错,我截图没截全)。
其实这个思路,现在在AI时代挺常见的。比如说最近一个超火的逆向开源项目REA(429K Star)对他的一些调研:《REA 之后,移动端还有秘密吗》。
它的整体思路可以概括为“工具即能力”:通过 MCP 把 Hopper、Ghidra、IDA 这些现成逆向引擎接给 Agent,教会 AI 使用它们。
引擎原本就在,补上工具调用和结果理解之后,AI 能自己推进更多逆向分析环节。社区里有一句评价:
“People are not using AI to decompile things, they are using it to interpret decompilation.”
反编译器一直都在,补上的是让 AI 读懂结果、把流程串起来这一环。这其实和我们做Loop的思路非常的类似,AI能使用的工具越多,它的上限越高。在AI的语境下,工具=能力。
| REA 思路 | iLoop | 说明了什么 |
|---|---|---|
| 把现成逆向引擎通过 MCP 接给 Agent | 把编译、拉起、截图、日志、视图层级接给 Agent | 模型没变,工具接通后能力上限抬高 |
| 每条结论带 evidence_id,「模型会幻觉,evidence 不会」 | 九步里的按目标取证、证据收敛 | 结论要能指回证据 |
| 脱壳、强混淆、动态分析仍要人 | 真机签名、回滚决策仍要人 | 工具接得再全,判断留给人 |
想让 AI在一个领域多做一点,就先接上它缺的工具,让原始结果直接回来,再把这些环节接成能闭合的Loop。
平台之外的能力
AI基建也覆盖不了所有 AI 能力。比如Oncall 的时候经常会扔一个录屏过来,以前大模型不支持视频,我只能截一帧,再用不准确的自然语言去形容一个动态过程,总得不到好结果。
于是遇水搭桥技能触发。为了减少中间商赚差价,我做了 Video Reader 技能,用一些小技巧抽帧,让大模型能看懂一段视频。这类技能还有很多,攒成了一个多维度的技能矩阵(只列名字,有需要找我要):
| 分类 | 代表技能 |
|---|---|
| 写作与表达 | 好好说话、talk-smith、费曼讲透、三思而后行 |
| 研发与验证 | VDD、Video Reader、png-compress、engineering-docs、content-infographic |
| 工作专项 | metric-anomaly-drilldown、cross-domain-diagnosis、event-tracking-validator、release-builder、unused-code-governance |
| 产品 | 机会雷达、机会评分、product-brief、设计罗盘 |
| 判断与思维 | claim-check、outside-view、steelman-choice、root-rethink |
| 个人与信息 | me-context、ai-briefing |
| 技能管理 | skill-library-keeper |
阶段 5 · Loop 解决开放问题(7—10 月)
AI基建完善,就可以让AI解决开放问题了。思路上只需要和人一样,逐步缩小范围,逼近问题根源。
桥搭好了,就能让 AI 碰更开放的问题了。Oncall、稳定性这类开放任务,能不能也交给 Loop?
让AI解决Oncall问题
7 月中旬起,iOS 端页面 A、页面 B两个页面的 FMP(首屏内容渲染指标)大量取到兜底值 -1,占比从约一成升到约四成。这是字段缺失造成的指标失真,不能据此认定页面变慢。随后,Oncall 机器人被拉进群。左图是远端部署的闭环,右图是这次排查。
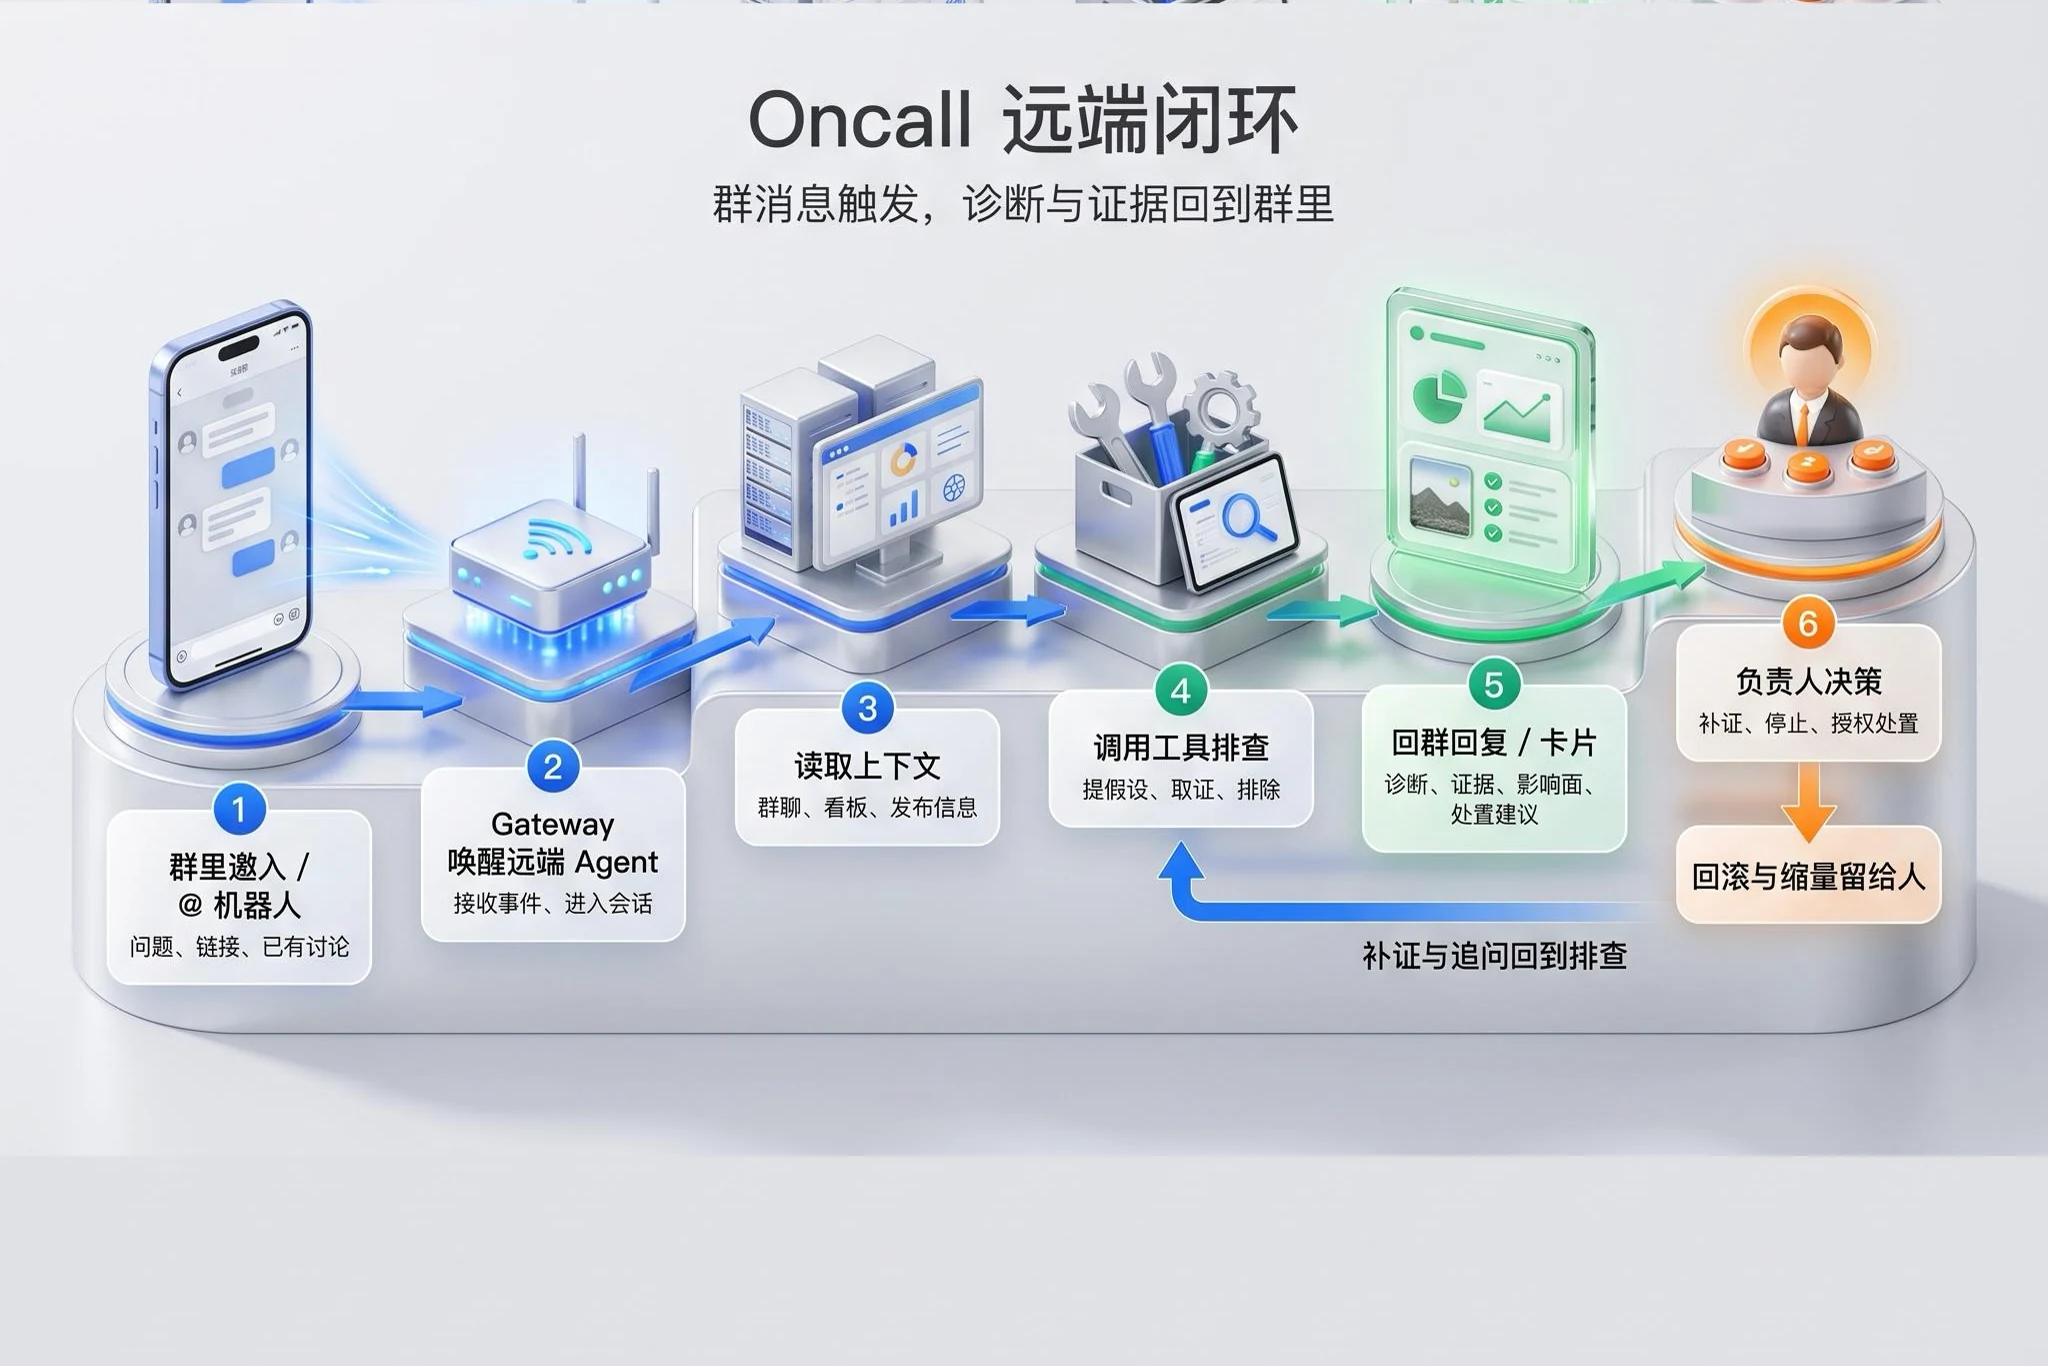
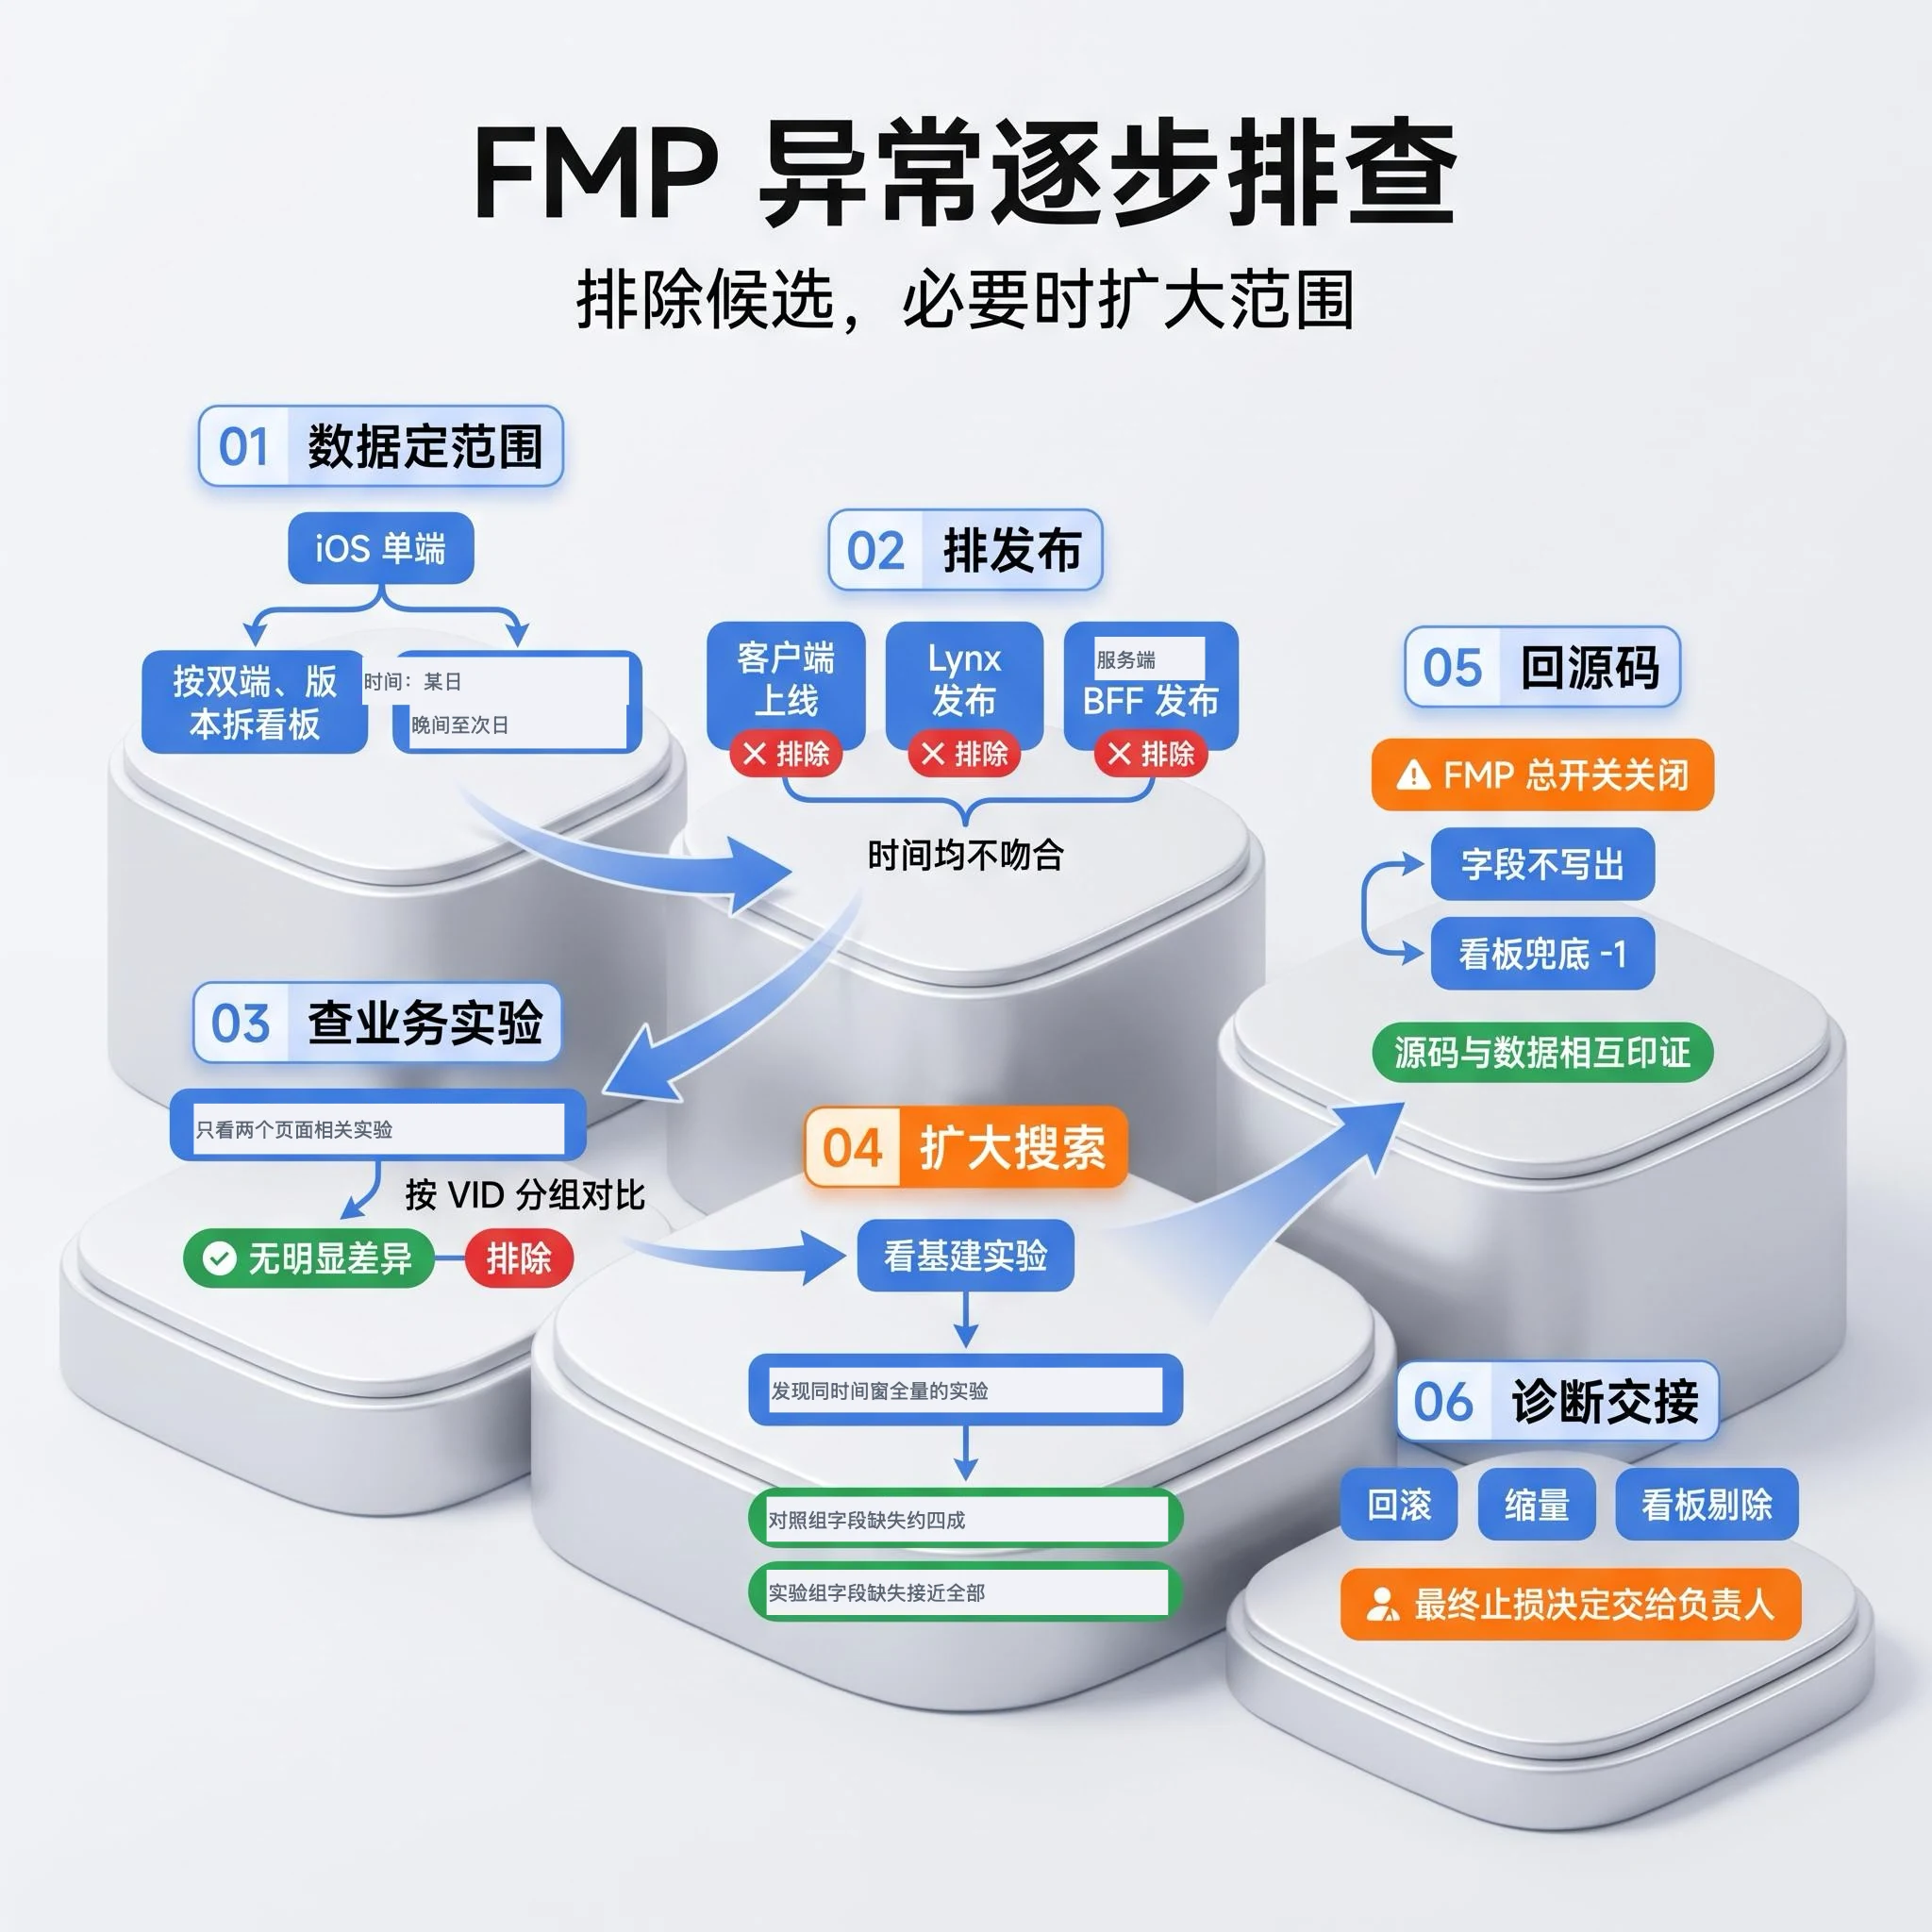
它先按双端和版本数据锁定时间窗,排除客户端、Lynx 和 服务端发布,再看页面 A、页面 B的相关实验。 页面 A、页面 B相关实验里,按 VID分组看不出对应差异。业务实验解释不了,就扩大到基建实验,继续找和异常时间吻合的变化。最终用源码解释了为什么总开关关闭后,FMP 字段不再写出。
根因查清了,如何止损还得负责人确认。AI 给出回滚、缩量、看板剔除的建议,拉相关负责人进群,交回证据和影响面,没有替人做处置决定。
事后把症状、假设、证据、下一步存成病例,下一轮接着查,不重新开图。再把定位和修复拆成两个原子能力,用 Resolve 串起诊断、处置、验证、观察,供 Oncall、BugFix、稳定性助手按场景组合。
好好说话:AI 味从哪来
有没有 AI 味,是个更开放的问题:AI 又不是人,为什么会有 AI 味?
答案也是和 AI 一起找到的。我先抛了一个假设:会不会跟翻译有关系?灵感来源于文心一言早期中英翻译的魔性生图。
AI 帮我顺着这条线调研和求证,从机器翻译研究里的 translationese,一路查到王力 1943 年的《中国现代语法》,发现一百年前就有人诊断过类似的毛病。例如维基中的 欧化中文。最后得到一个能解释一部分现象的说法,然后按照病因给方子,就有了好好说话这个技能(《为了根除 AI 味》)。
过程中也发现不少开源技能是如何解决AI味的。这些工具为了像人说话,给 AI 套个随意的人设,说着说着就把原意改了,AI会根据这个人设幻想出很多符合人设的话,但原文根本没有表达这个意思。所以后续我们技能也是优先保事实这个原则。
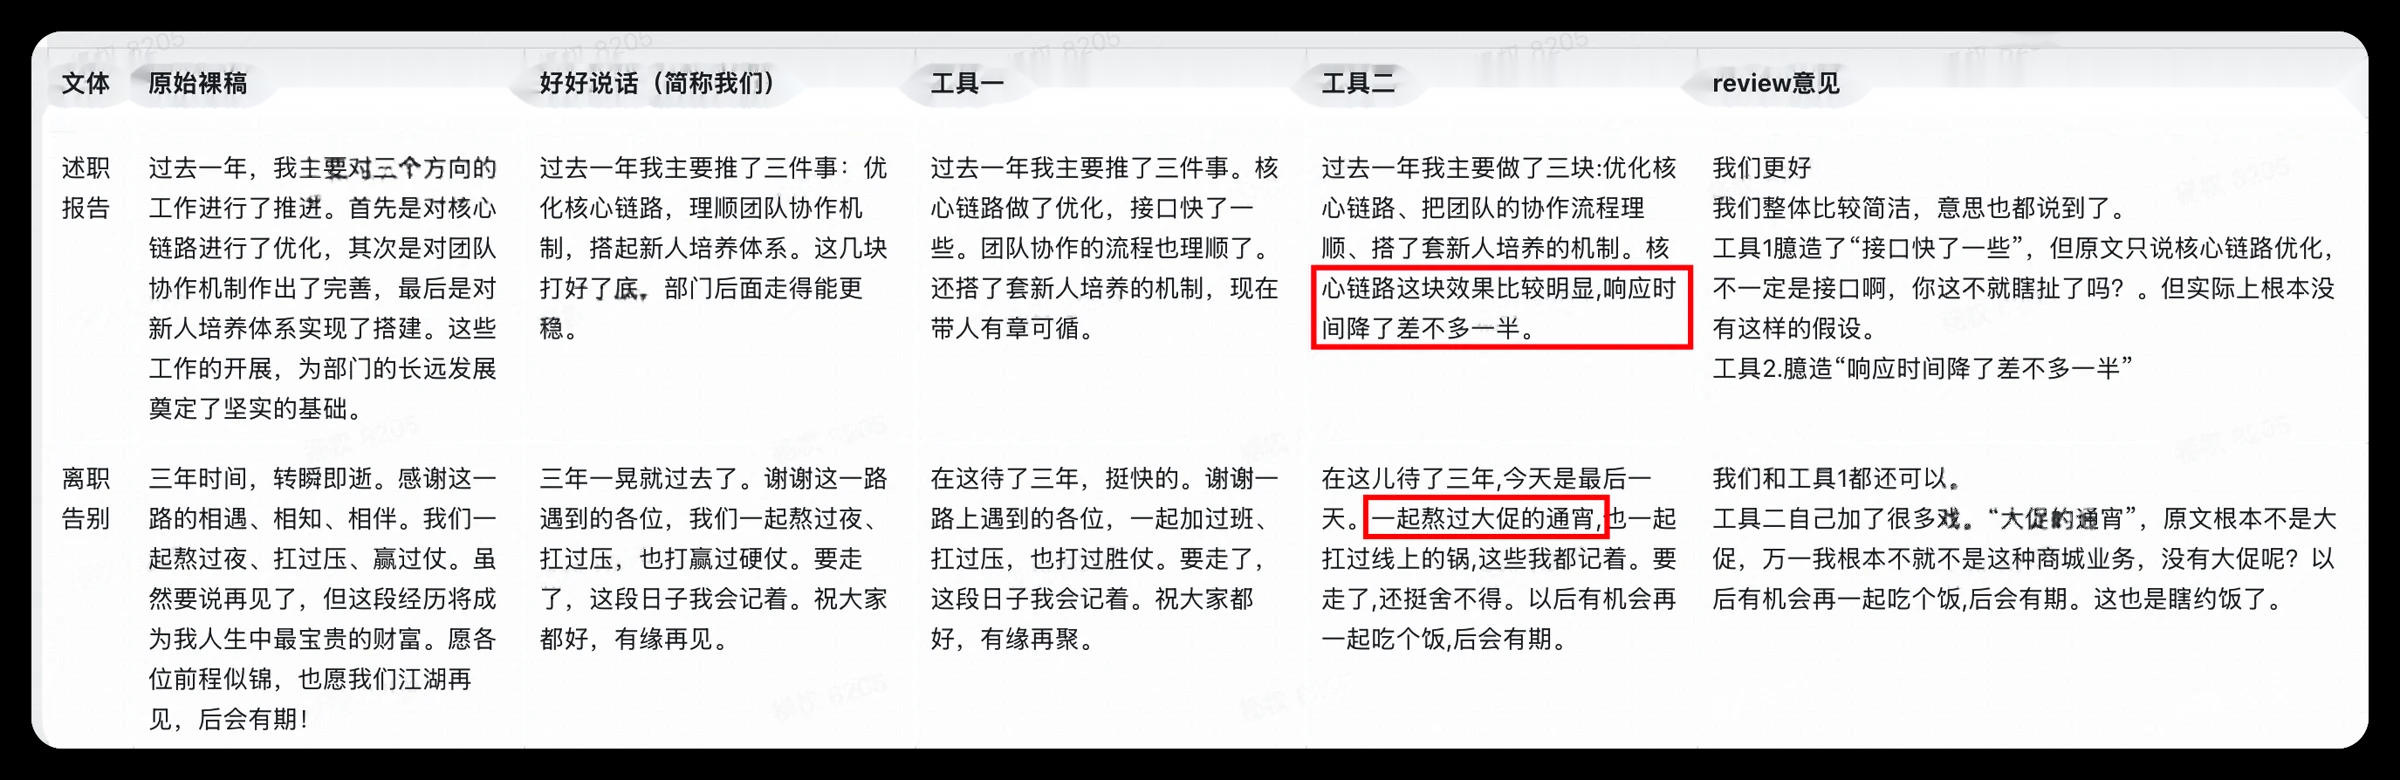
当然了,这事比想象的难太多了。语言太开放了,理论有无穷多种解,是开放问题中的开放问题。一个说法只能解决一部分问题,所以效果一直在调:每天出题、盲评,攒够同类问题再改规则好好说话技能-召回优化
我们回头看这些问题,其实思路上就是大胆假设,小心求证,一轮轮把范围收窄。所以开放问题能不能交给 Loop,要看以下这几个问题:
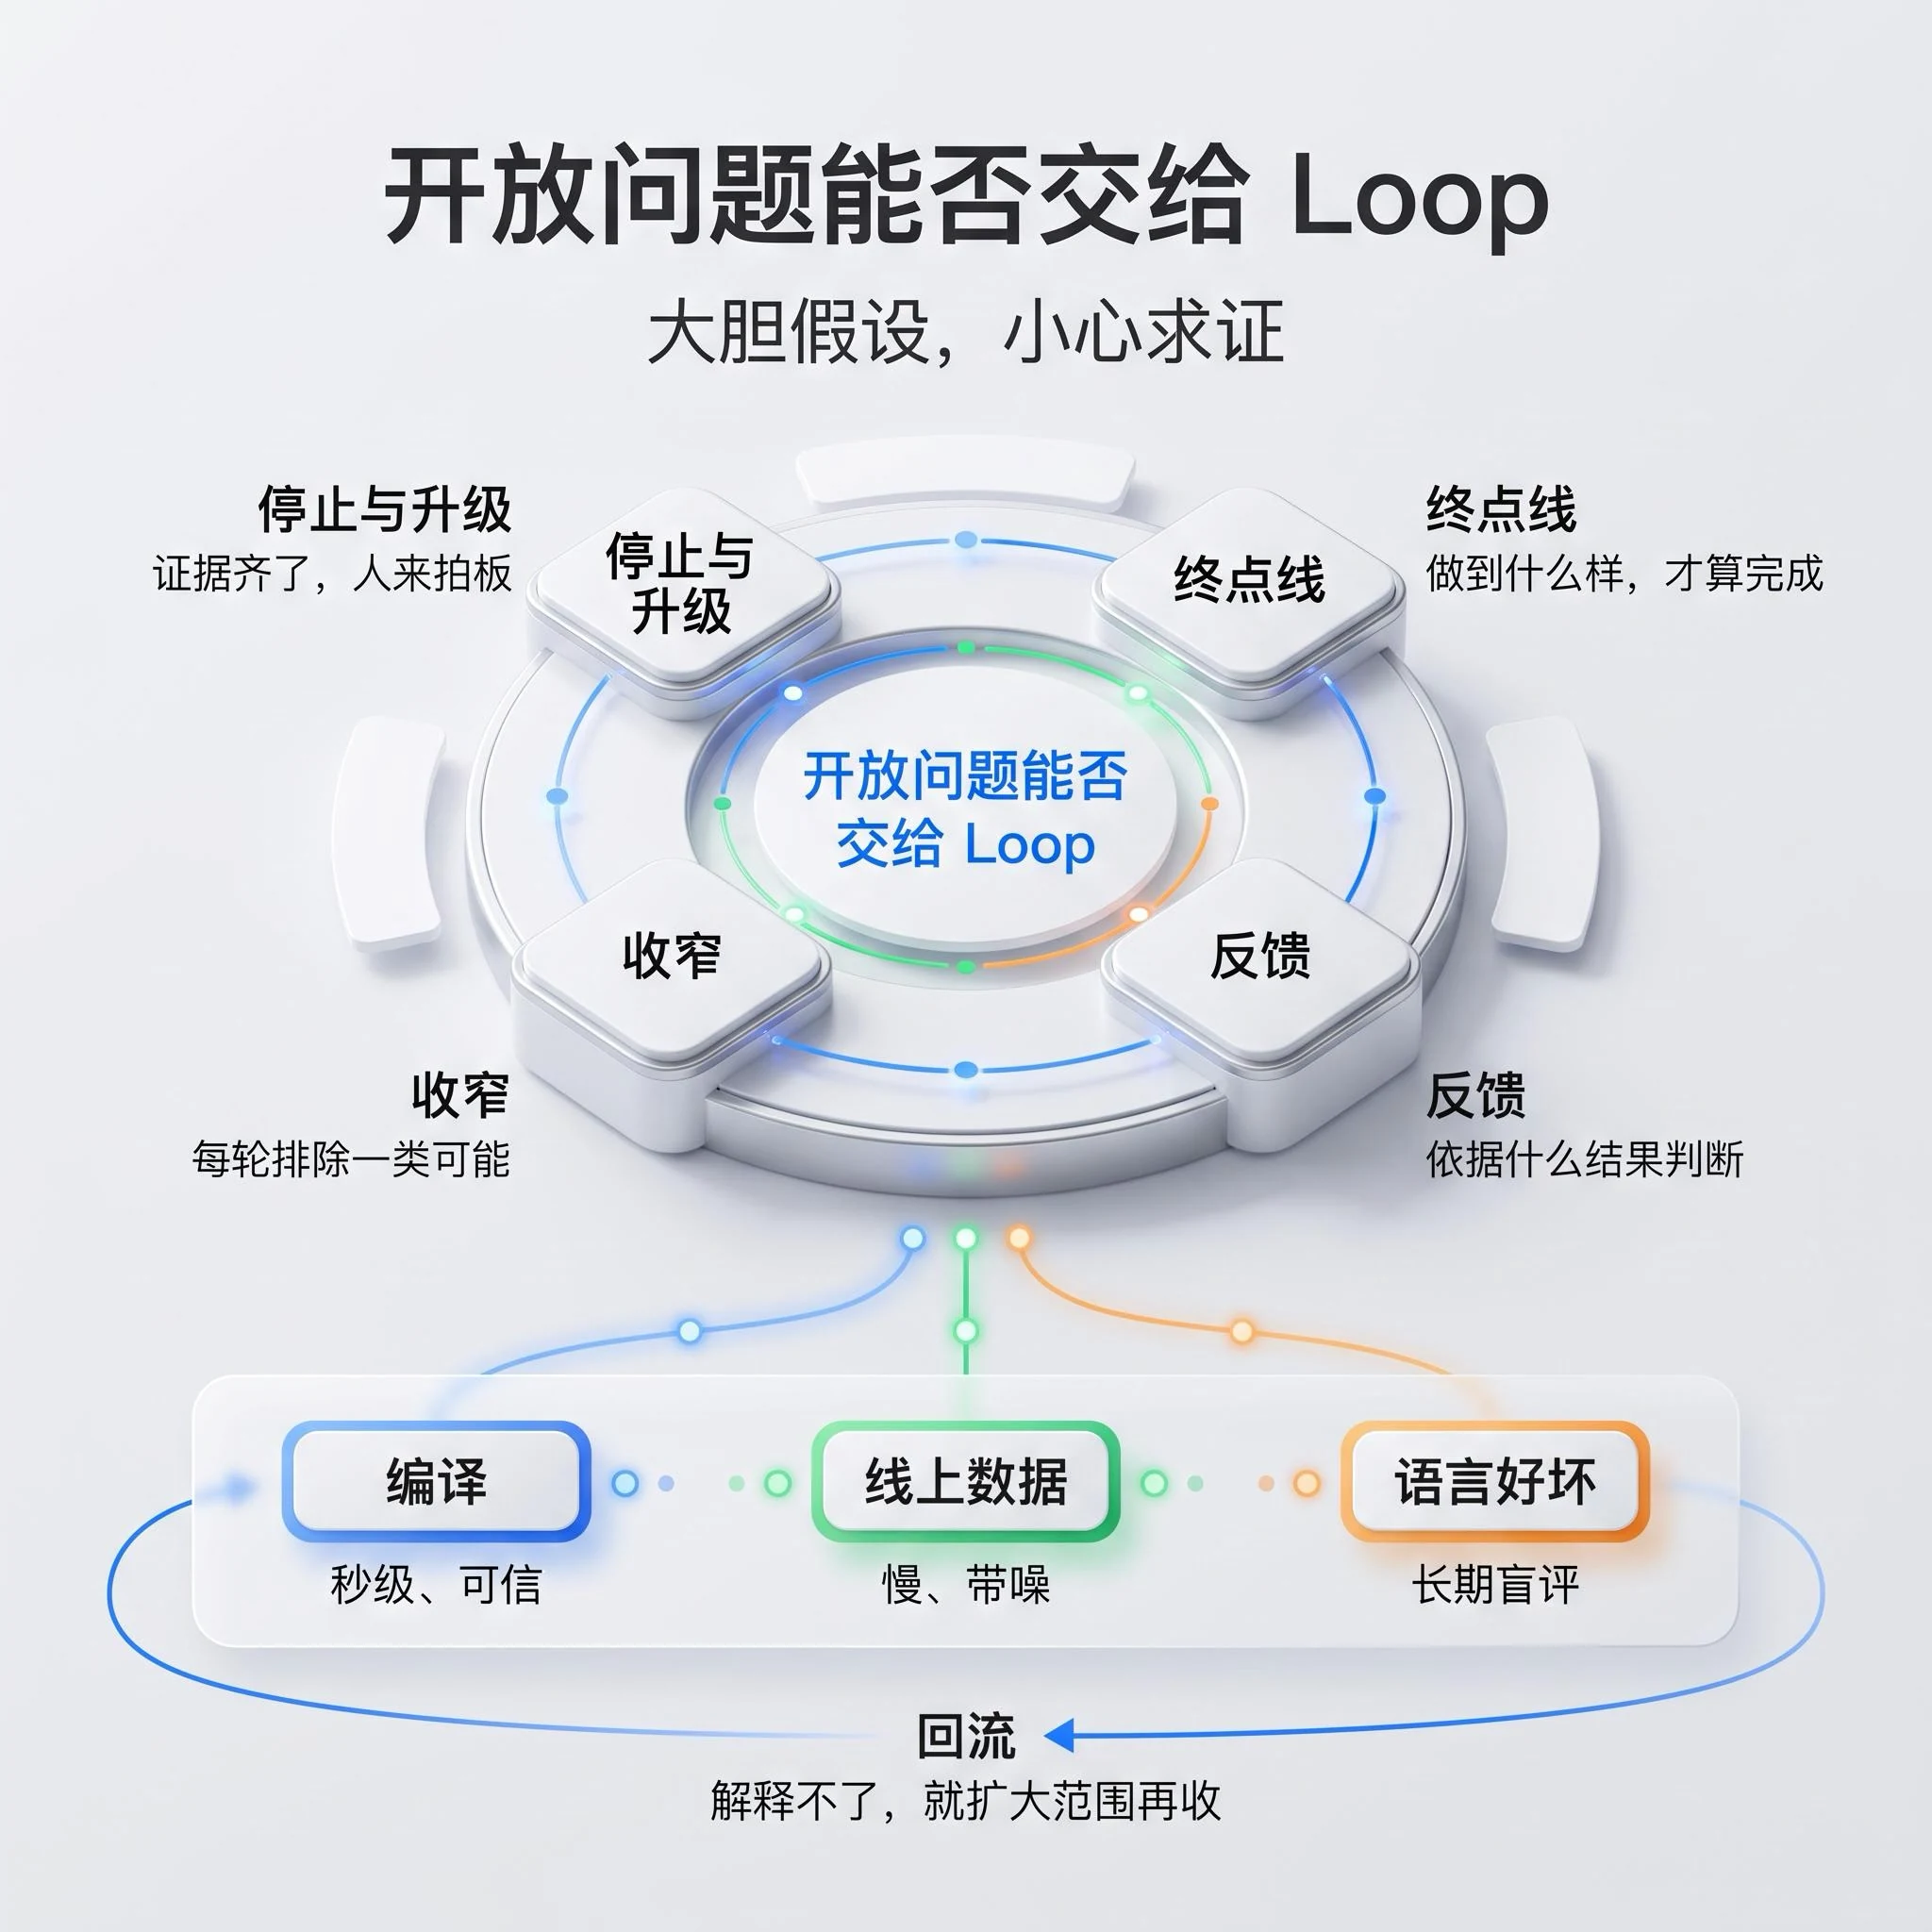
- 终点线:Oncall 是证据能解释现象;去 AI 味只能先求一个能解释部分现象的说法。
- 反馈:编译日志秒级可信;线上数据慢、带噪;语言好坏只能靠长期盲评。
- 收窄:每轮排除一类可能,解释不了就扩大范围再收。
- 停止与升级:证据齐了交给人拍板;说不清终点线的,先别交给它。
阶段 6 · 全流程工作流(9—10 月)
从找机会、做 UI、写文档到做游戏,执行越来越便宜,思路和想法就更重要了。
编码提效以后,就想把边界再往外扩:怎么通过 AI 找想法和机会?怎么更好地做 UI、写技术文档?如果要完整交付,我的工作流够高效吗?再去做一个没碰过的领域,比如游戏,会怎样?
style-compass:AI的视觉品味
大家都有个感觉:AI 写的 UI 很同质化,甚至没品味。一开始我也这么认为。后来和 AI 聊了几轮,发现是错怪它了。
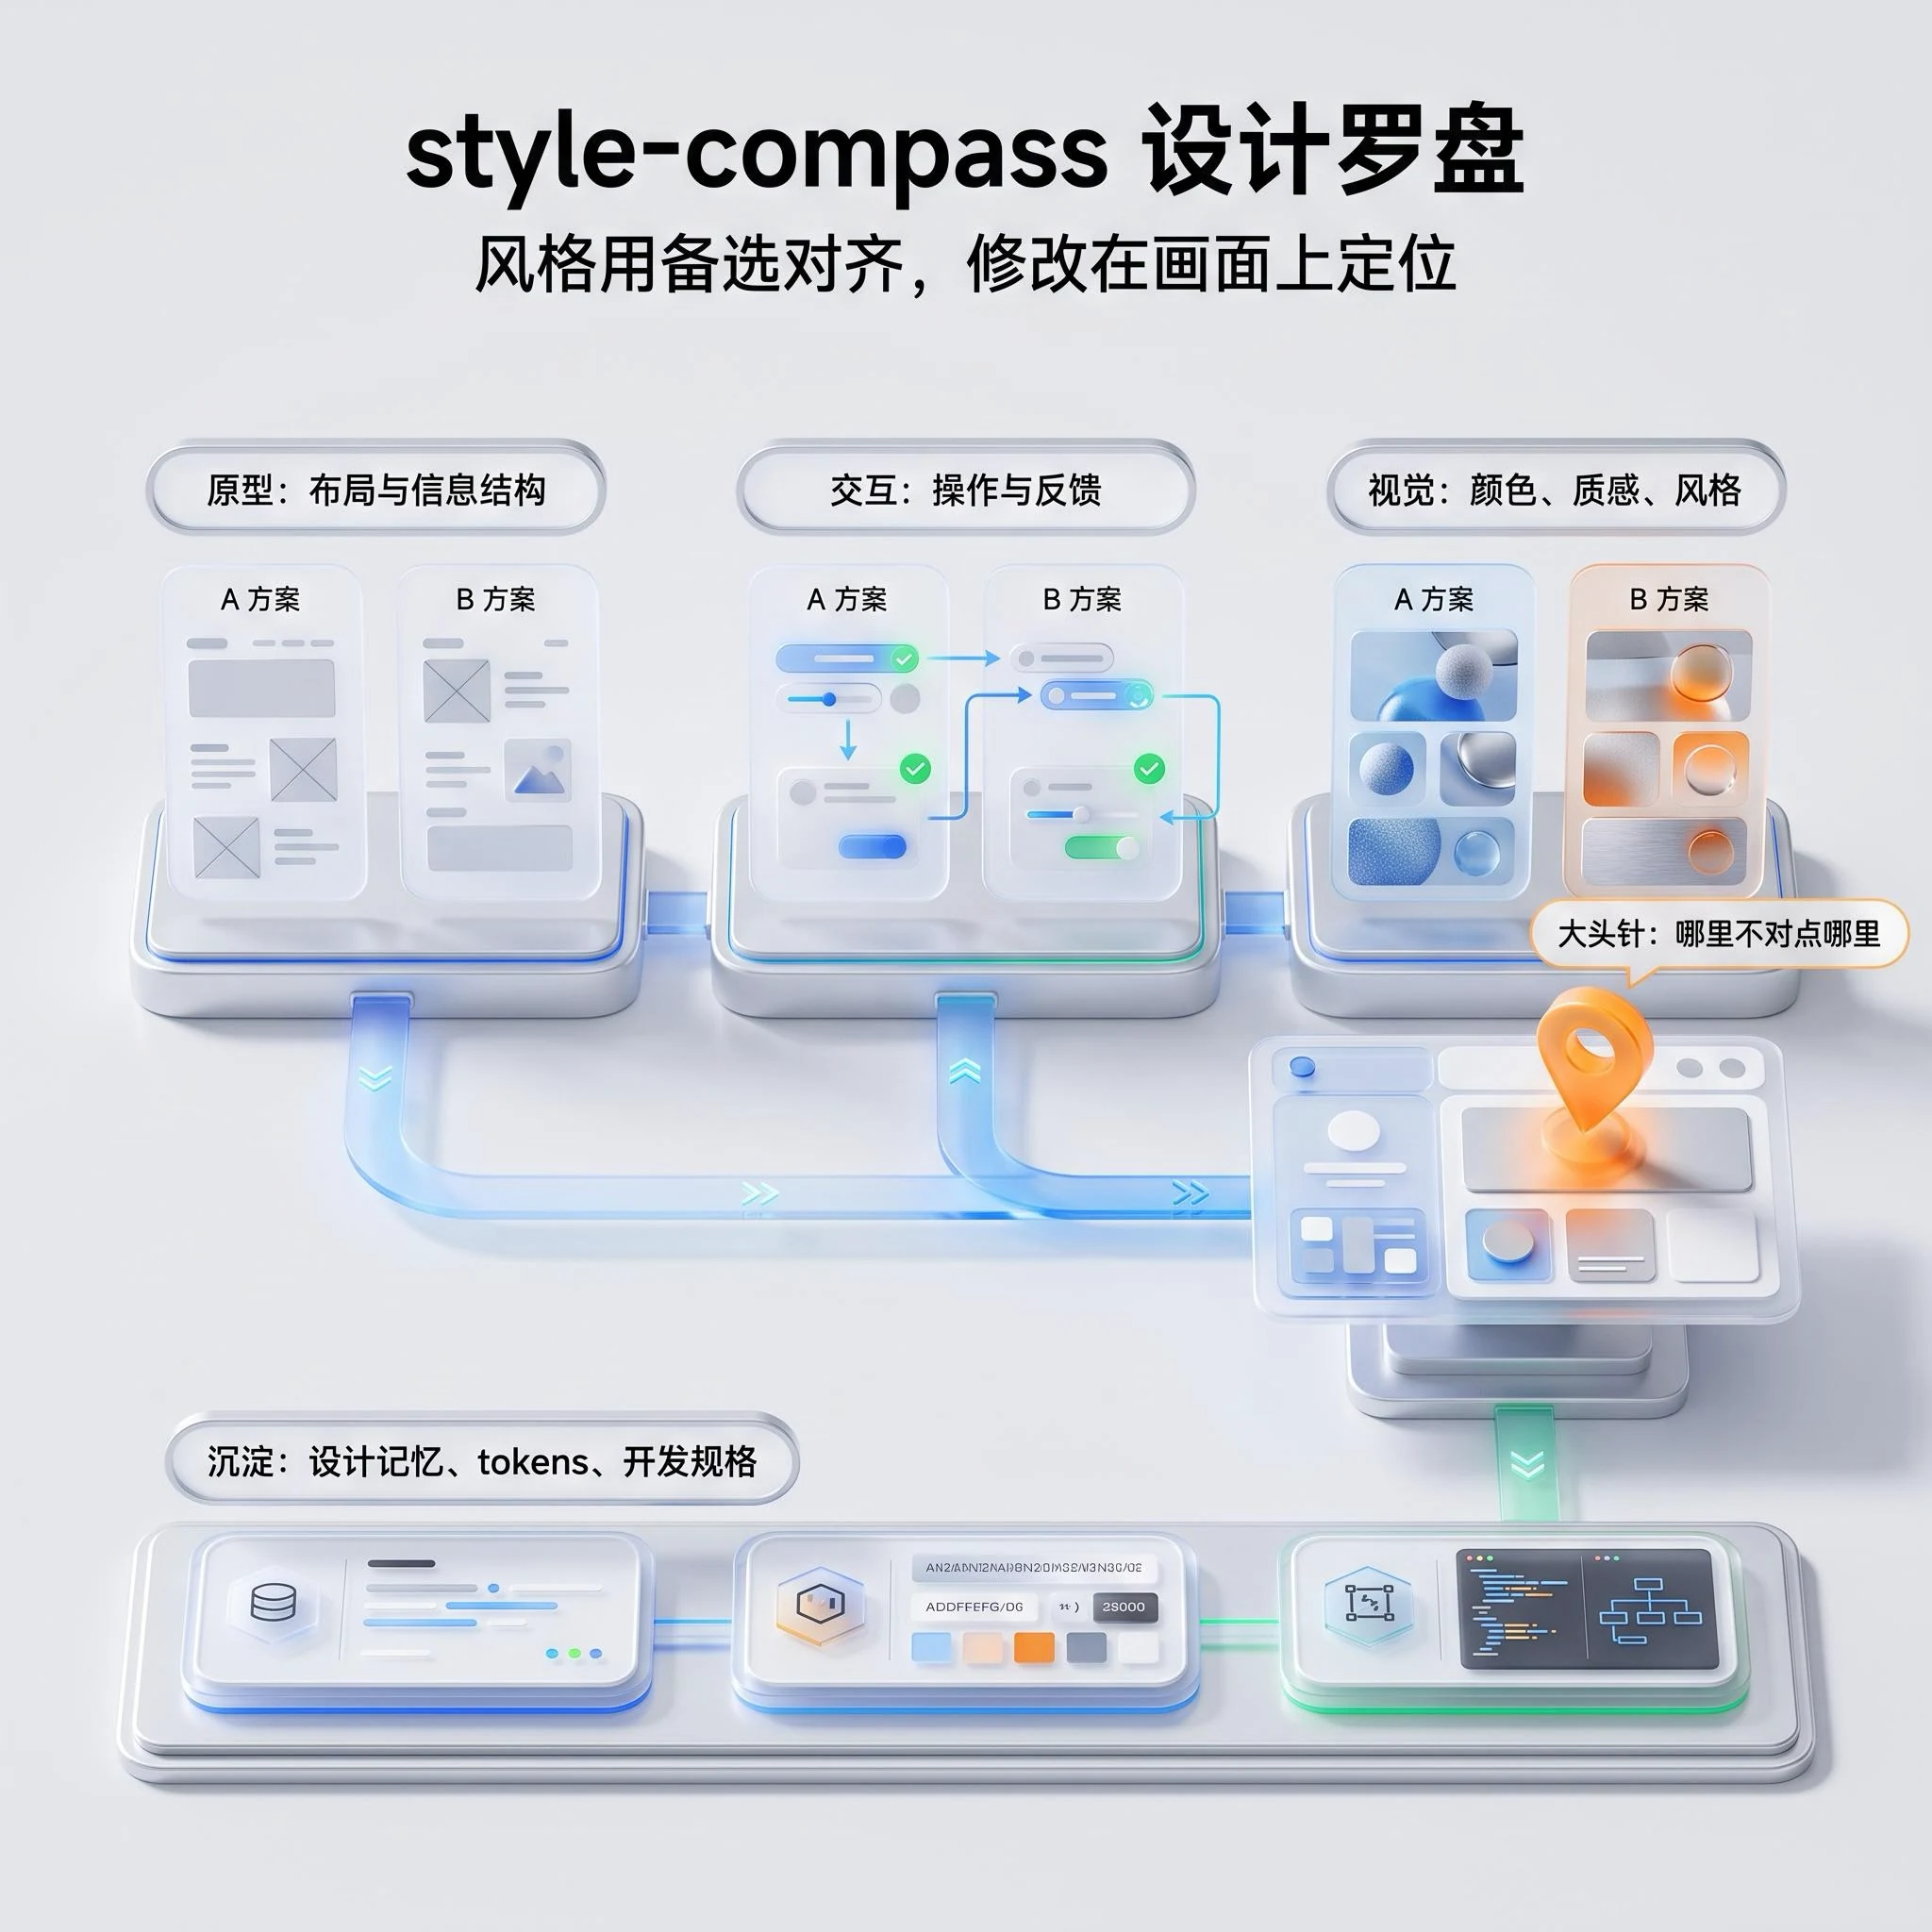
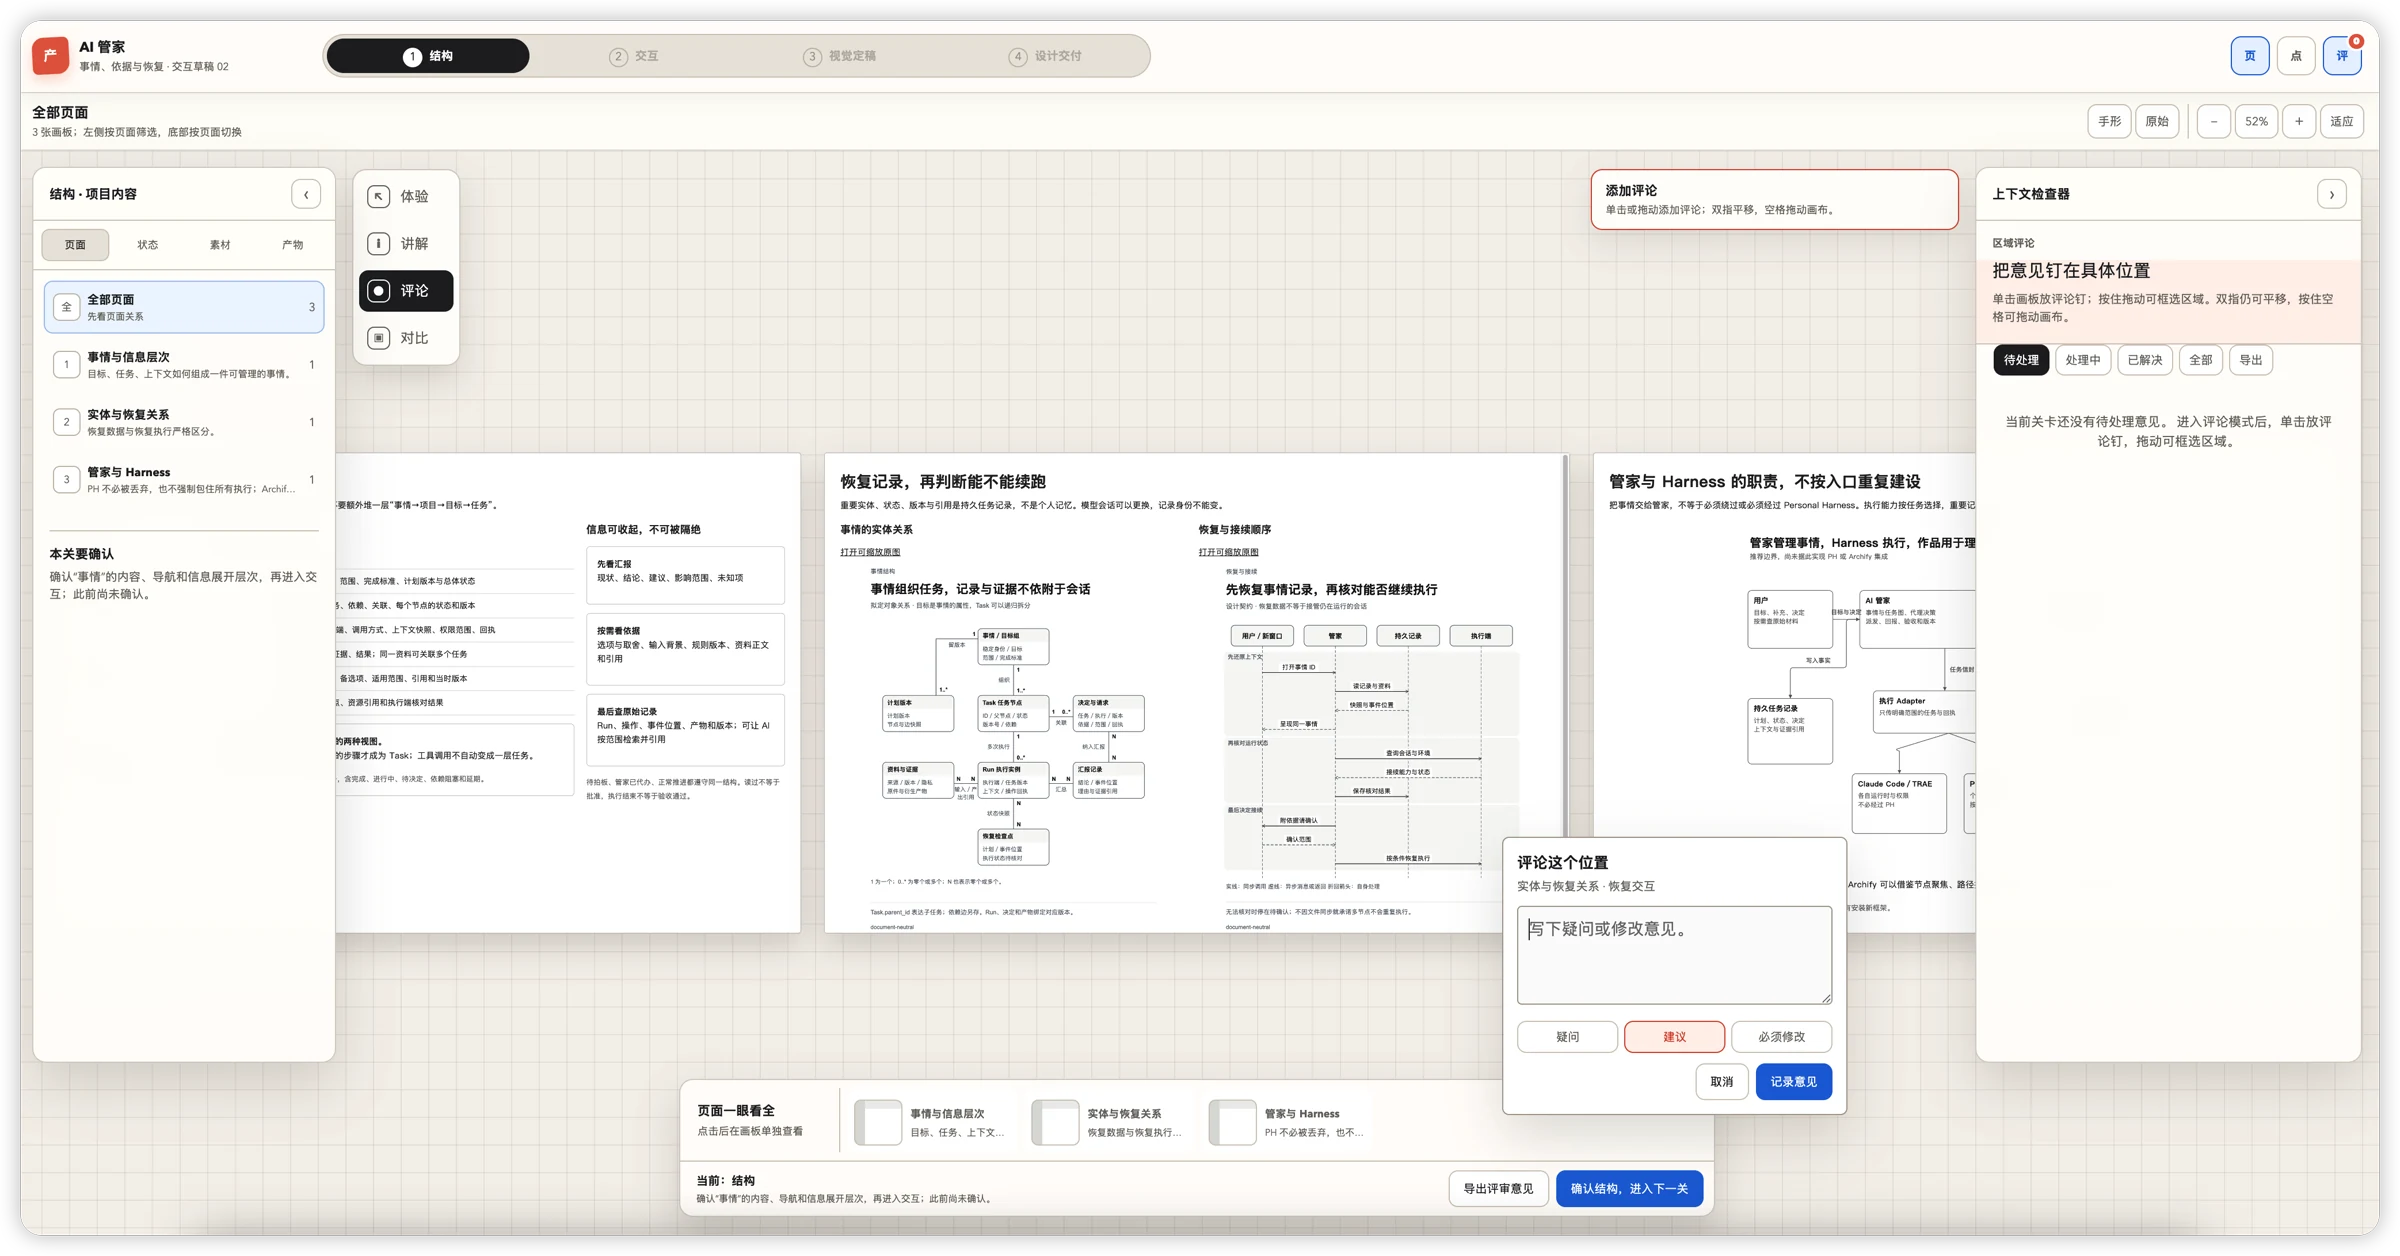
好看对每个人都不一样,你说不清想要的风格,它只能给兜底风格。说清风格、给出参考,它完全能还原出很好的效果。所以我做了设计罗盘,模仿的就是人类定 UI 的过程,老老实实的做原型、交互、视觉的评审,每关都出几个方案让你挑;交互上参考 Figma,哪里不对点哪里。之前踩过不少坑,认识到自然语言的表达精度难以精准地定位和更新一个二维视觉问题。
Anthropic 的 frontend-design 技能也要求先比较布局构想,再截图检查实现。先有备选,再看真实画面,这个工作流方向是一致的。
技术文档:让人一眼看懂
AI 写的技术文档有两个通病:一大段一大段地堆字;流程图把节点从头串到尾,看不出重点。
但技术文档是给人看的,阅读效率非常的关键。而且好好说话只能解决语言上的,不能解决结构上的问题。所以我新增了两个技能。
- engineering-docs:如何更好地结构性的表达和更好地画图。
- content-infographic:把大段抽象的文字转化成二维图像方便理解。
其内核都是:别让人从一大段话里找重点:文字分主次,图画清关系。
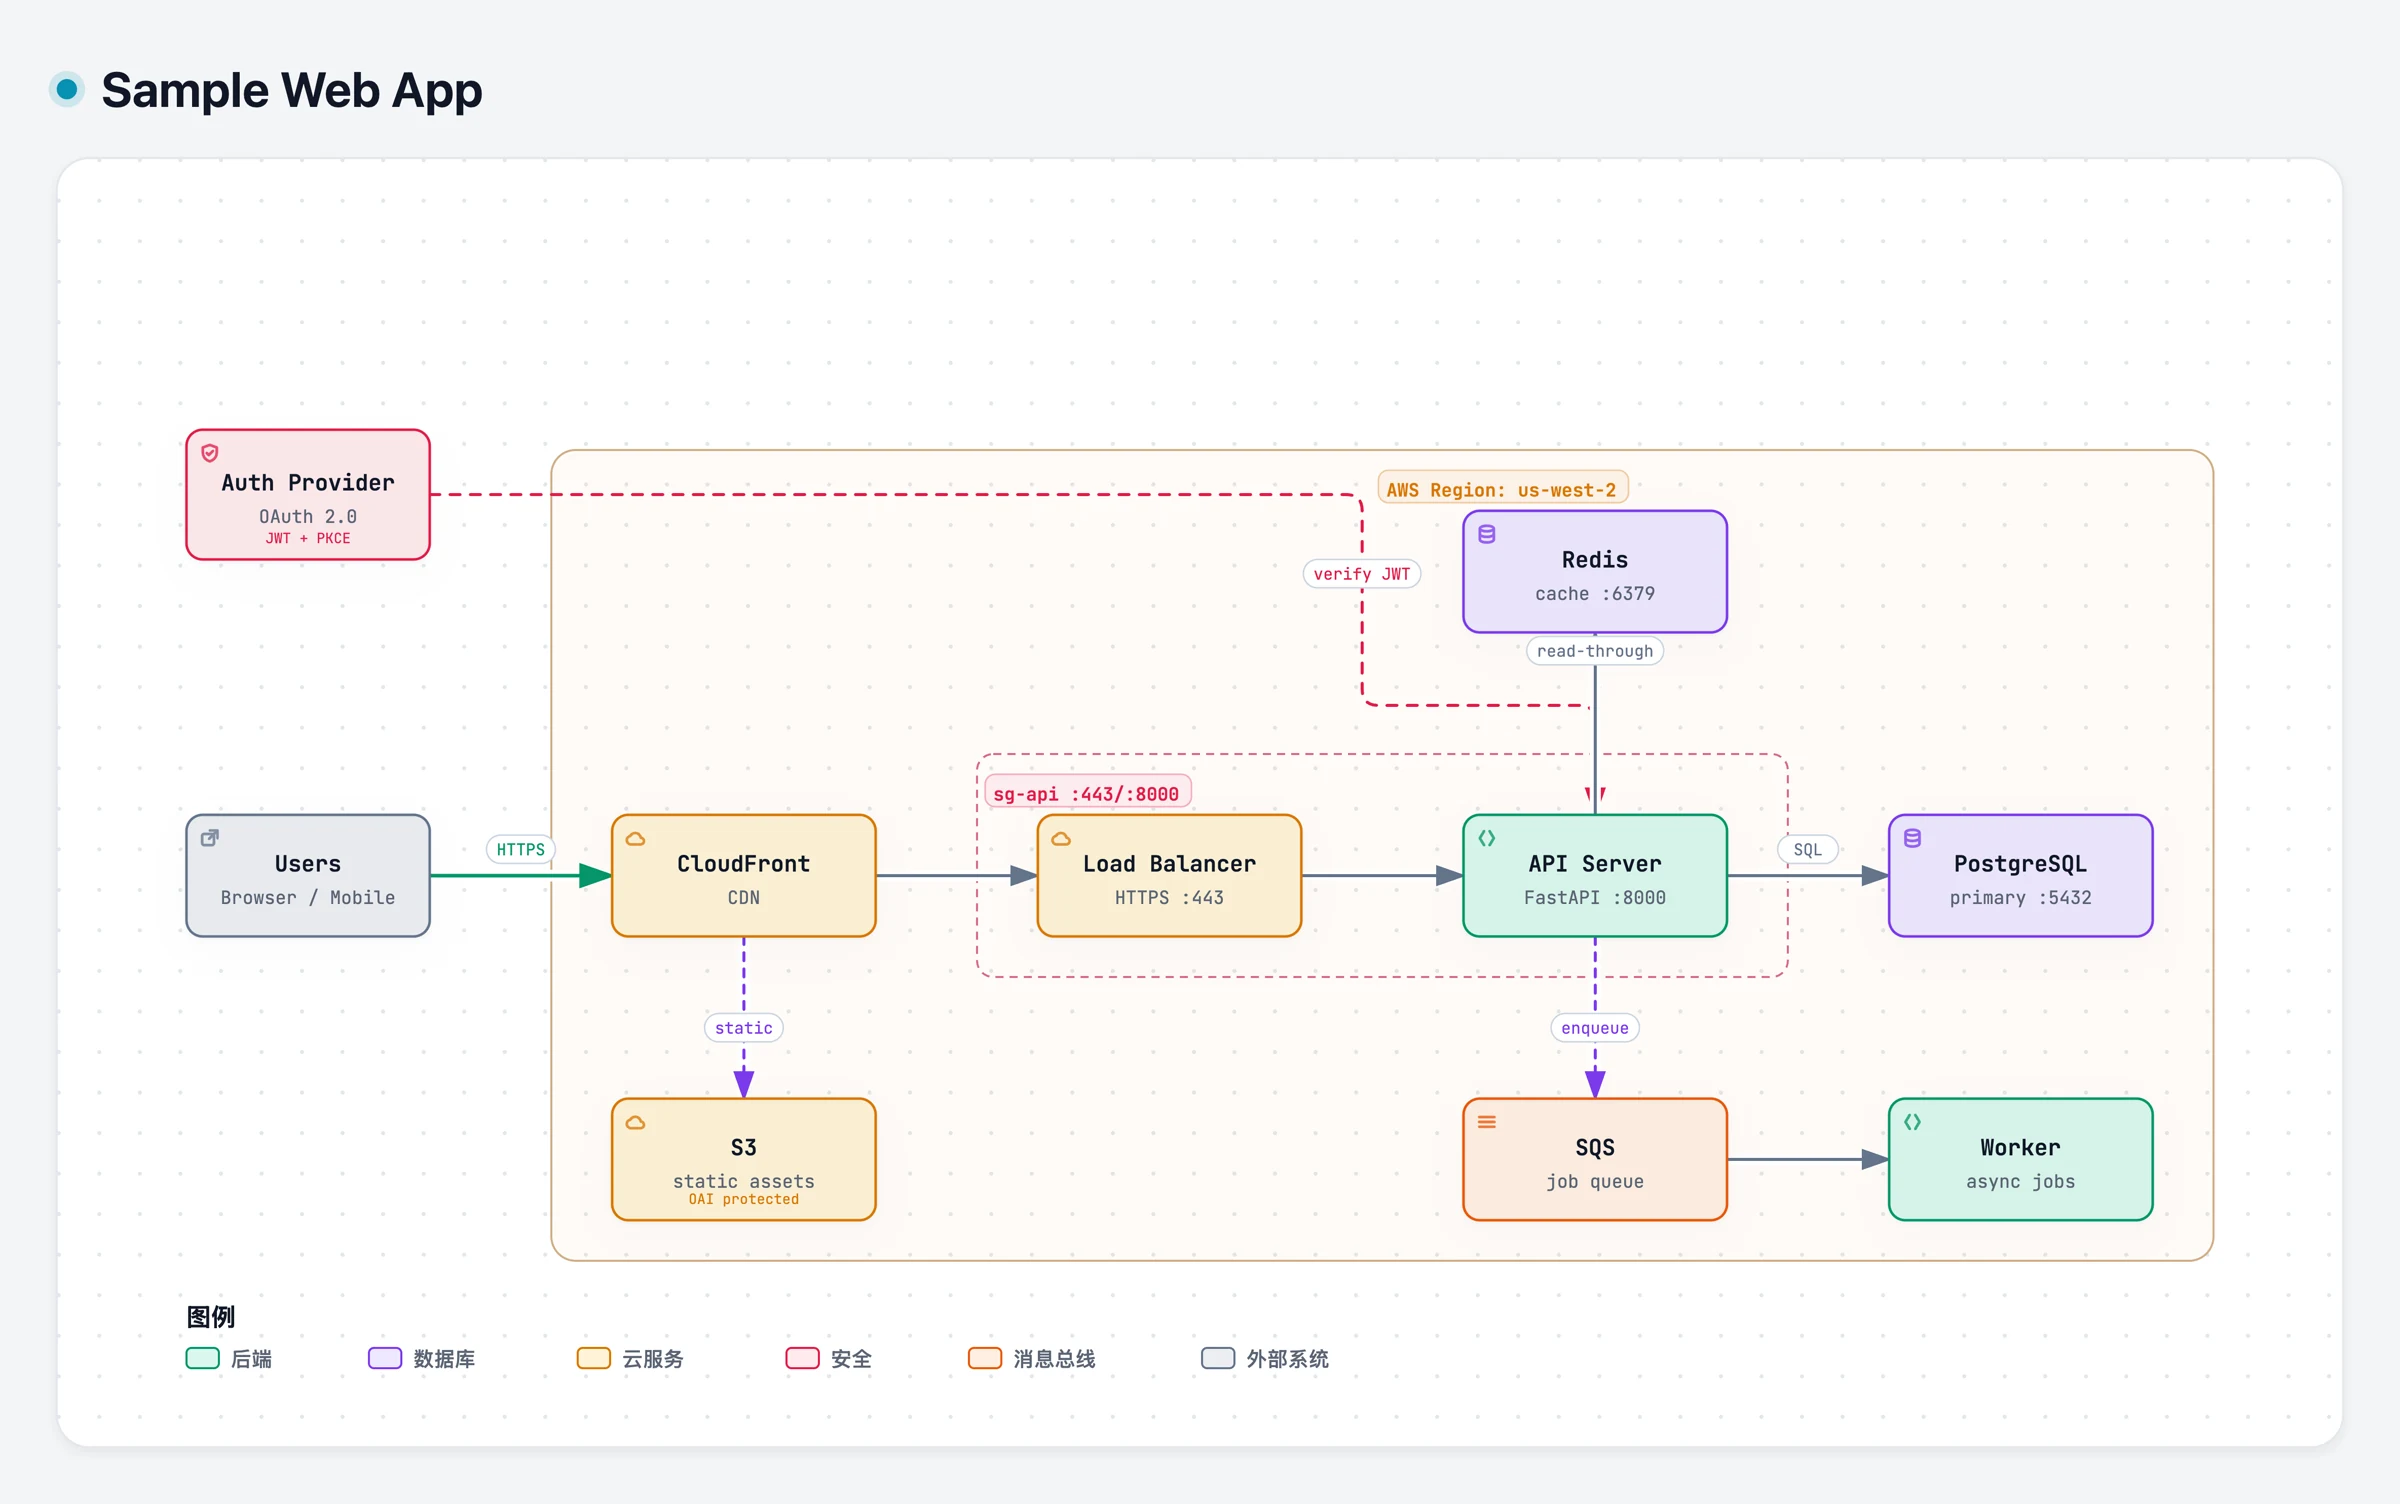
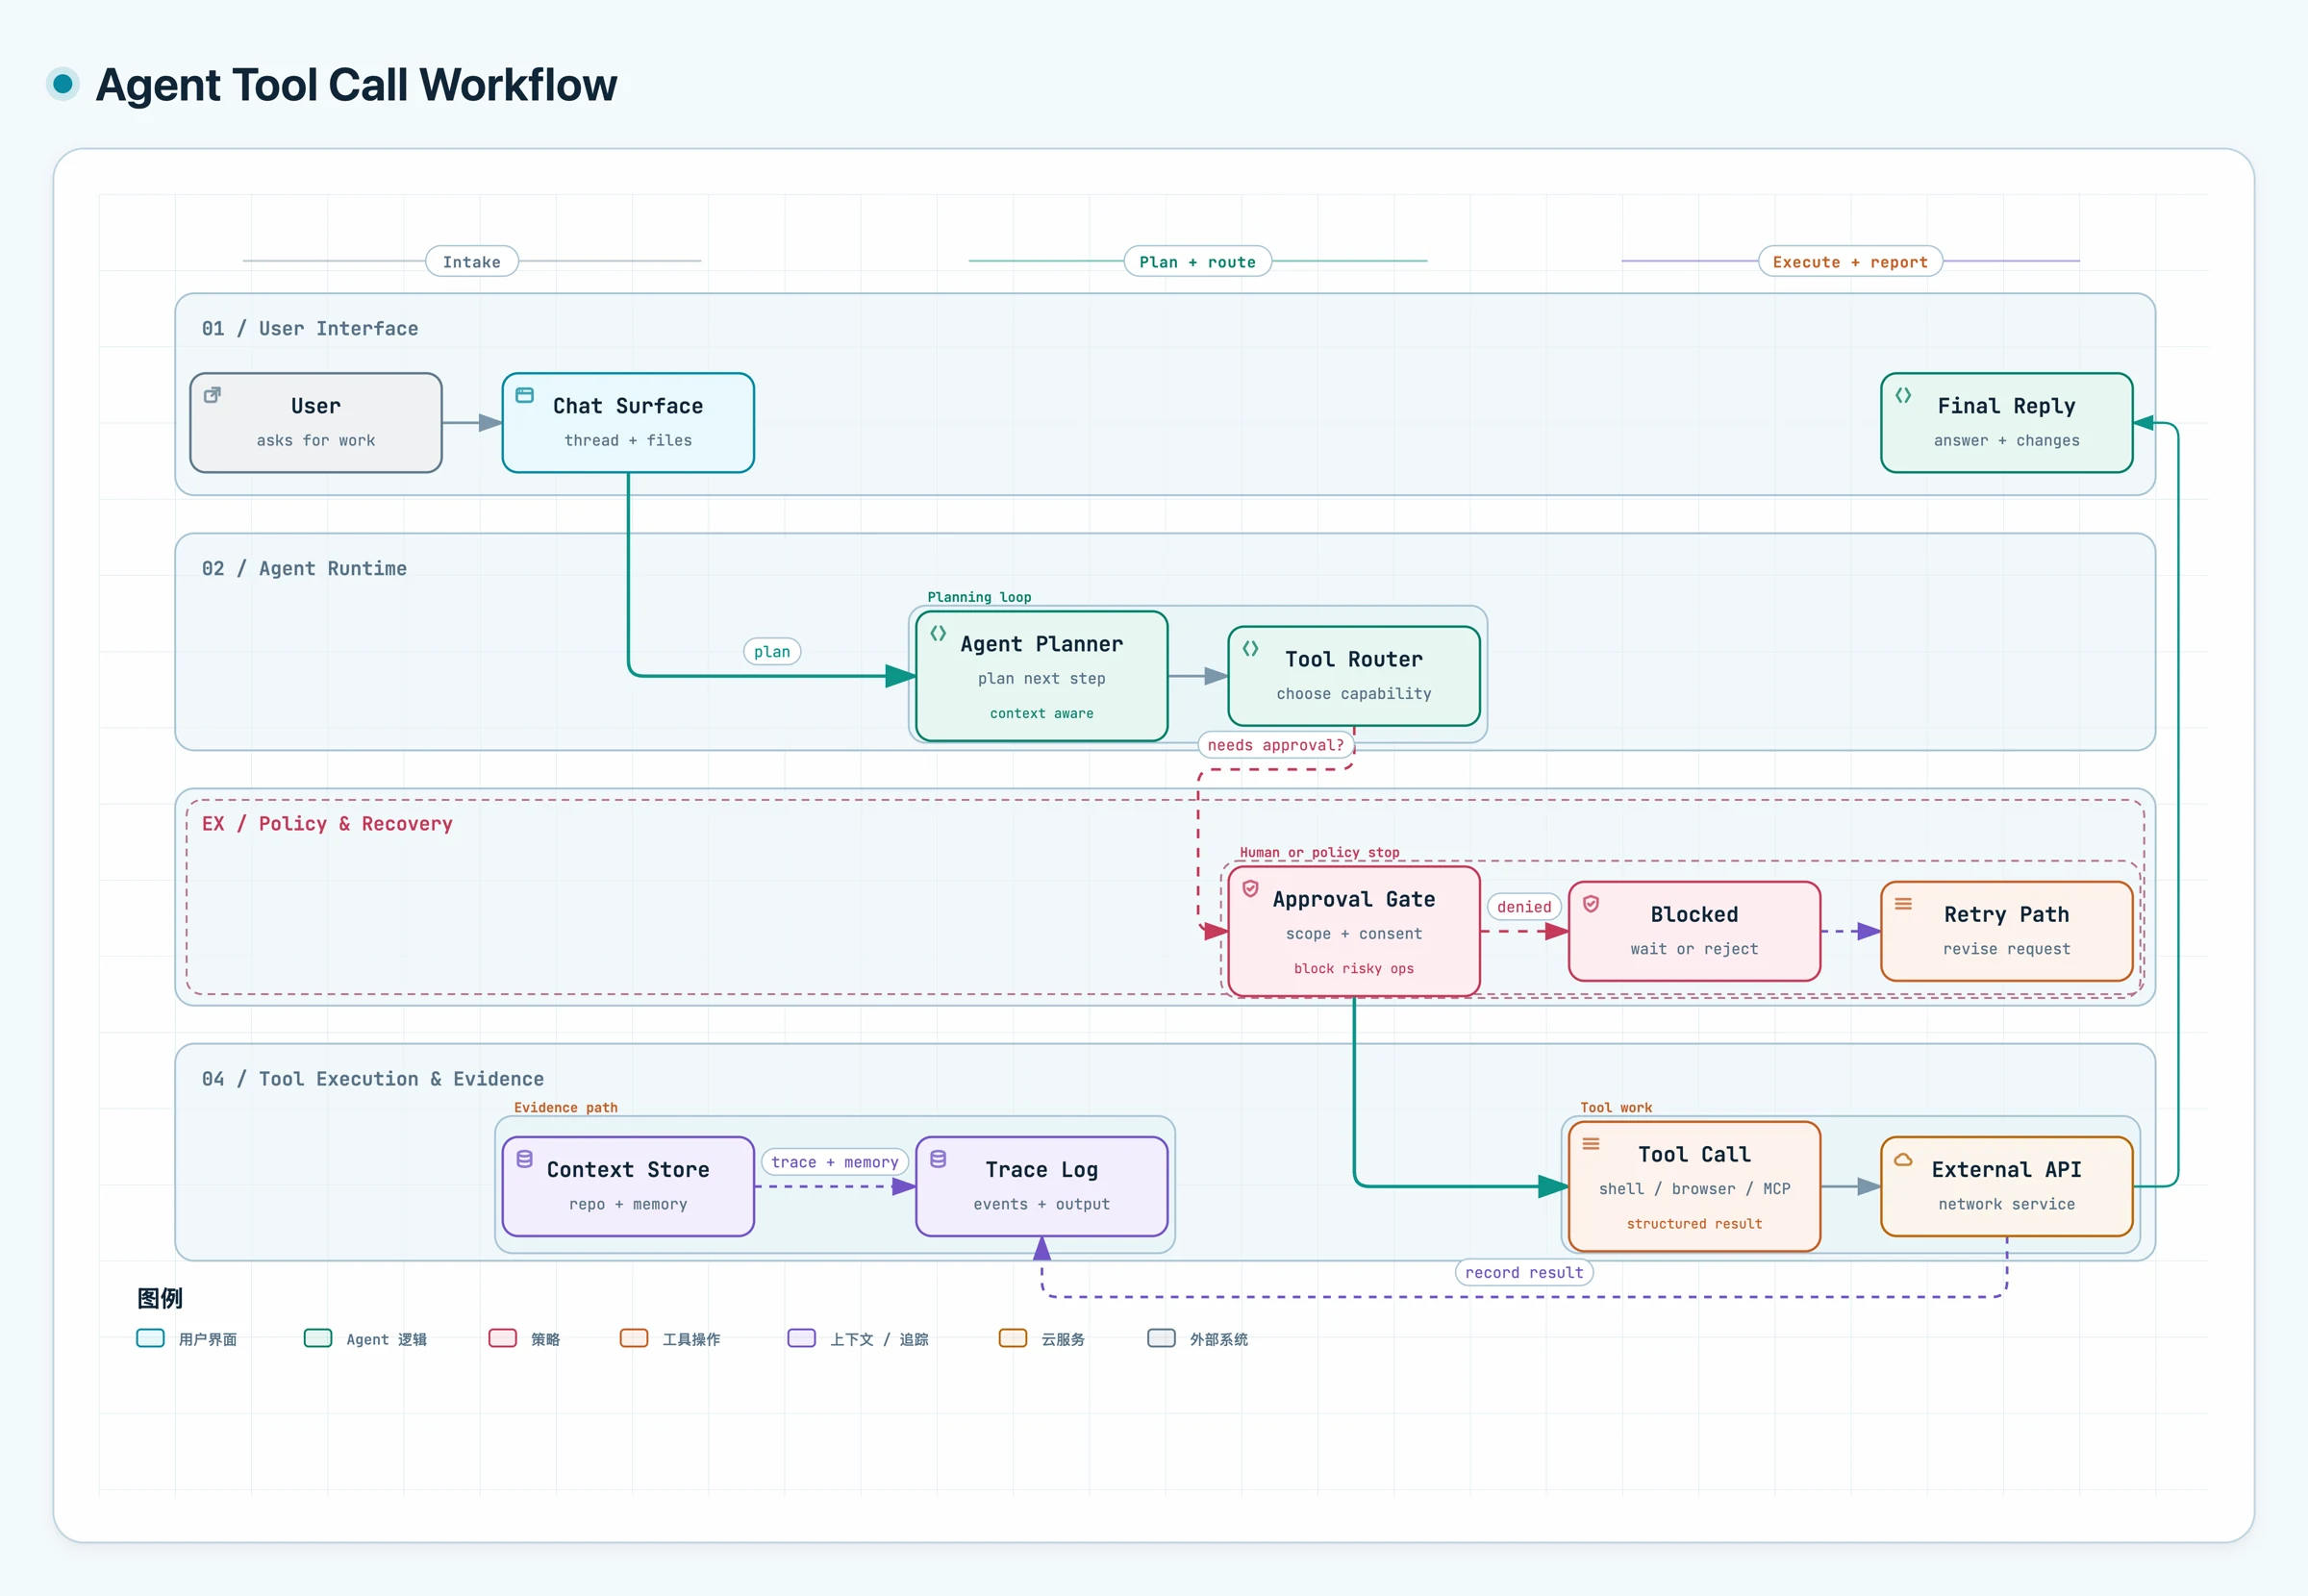
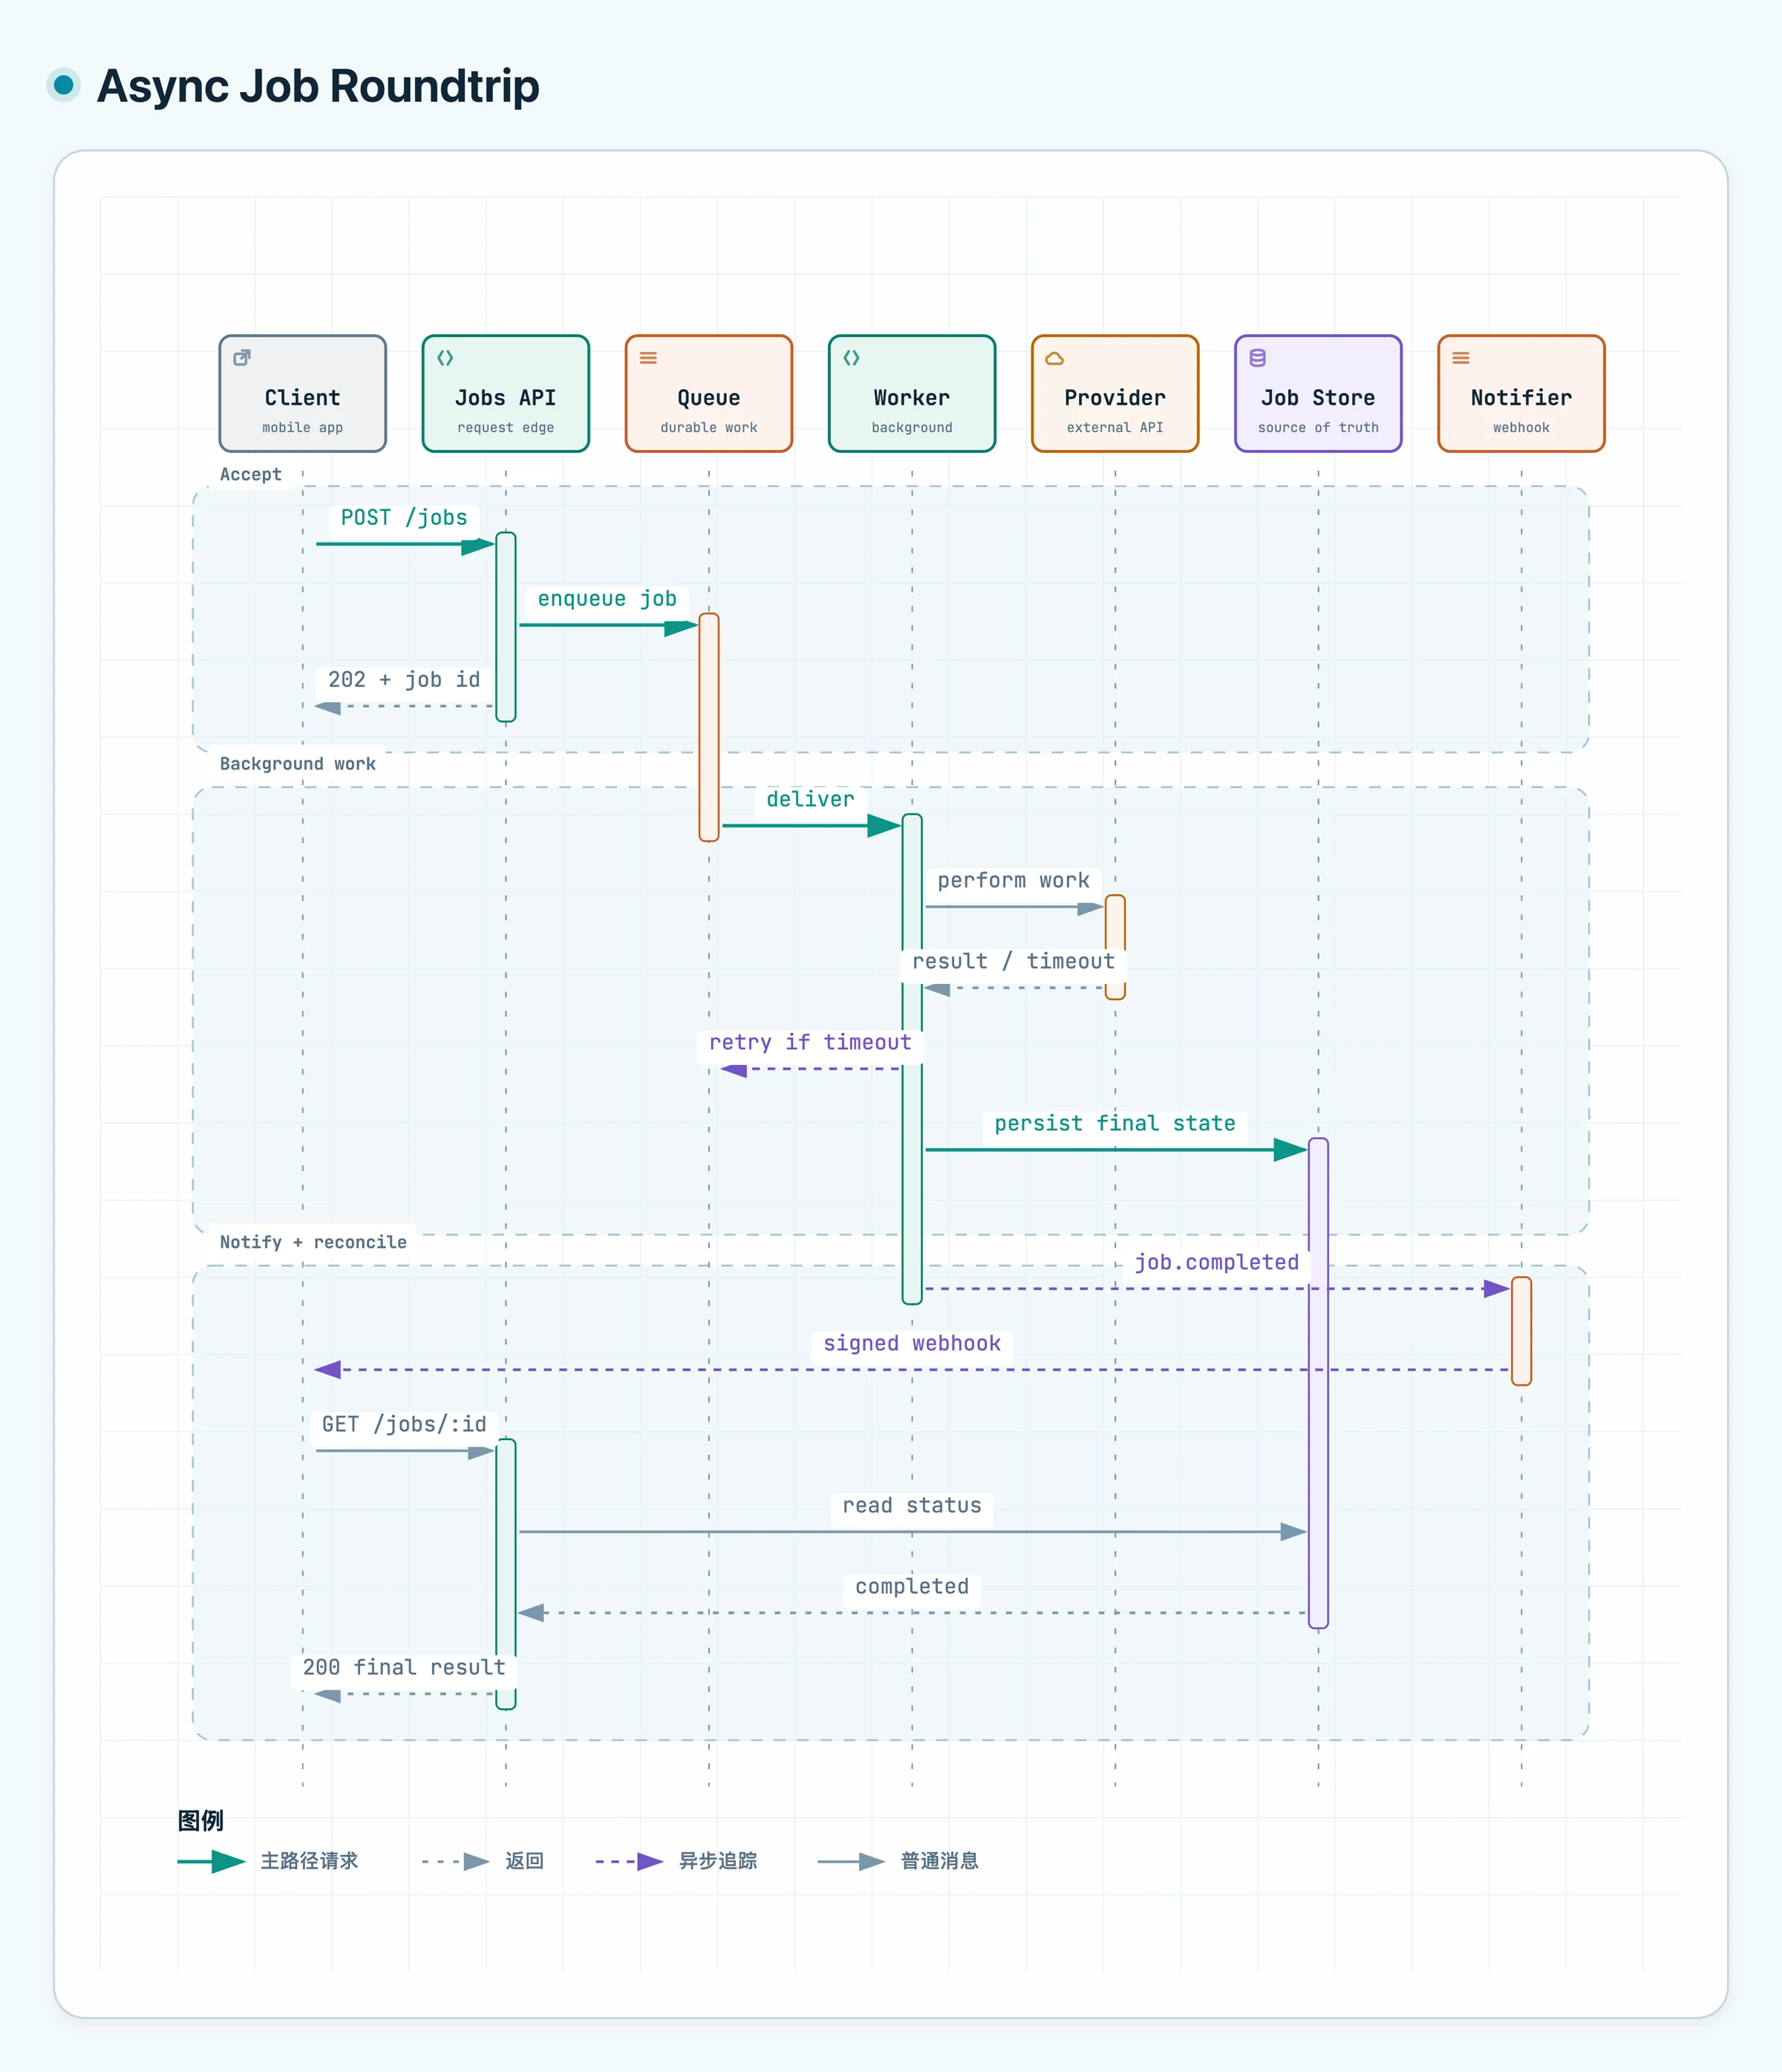
- 三层结构:首屏只放结论、要读者做的决定和一张总览图;每章第一段先给本章结论;依据和参数下沉到细节和附录。只读首屏和每章第一段,就能说清做什么、为什么、怎么做。
- 按信息选图:结构、泳道、时序、状态、数据,各有合适的图;标题写结论,连线写动词。
- 图要能改:用代码生成可编辑的 SVG,不强依赖平台、改内容都不用重画。
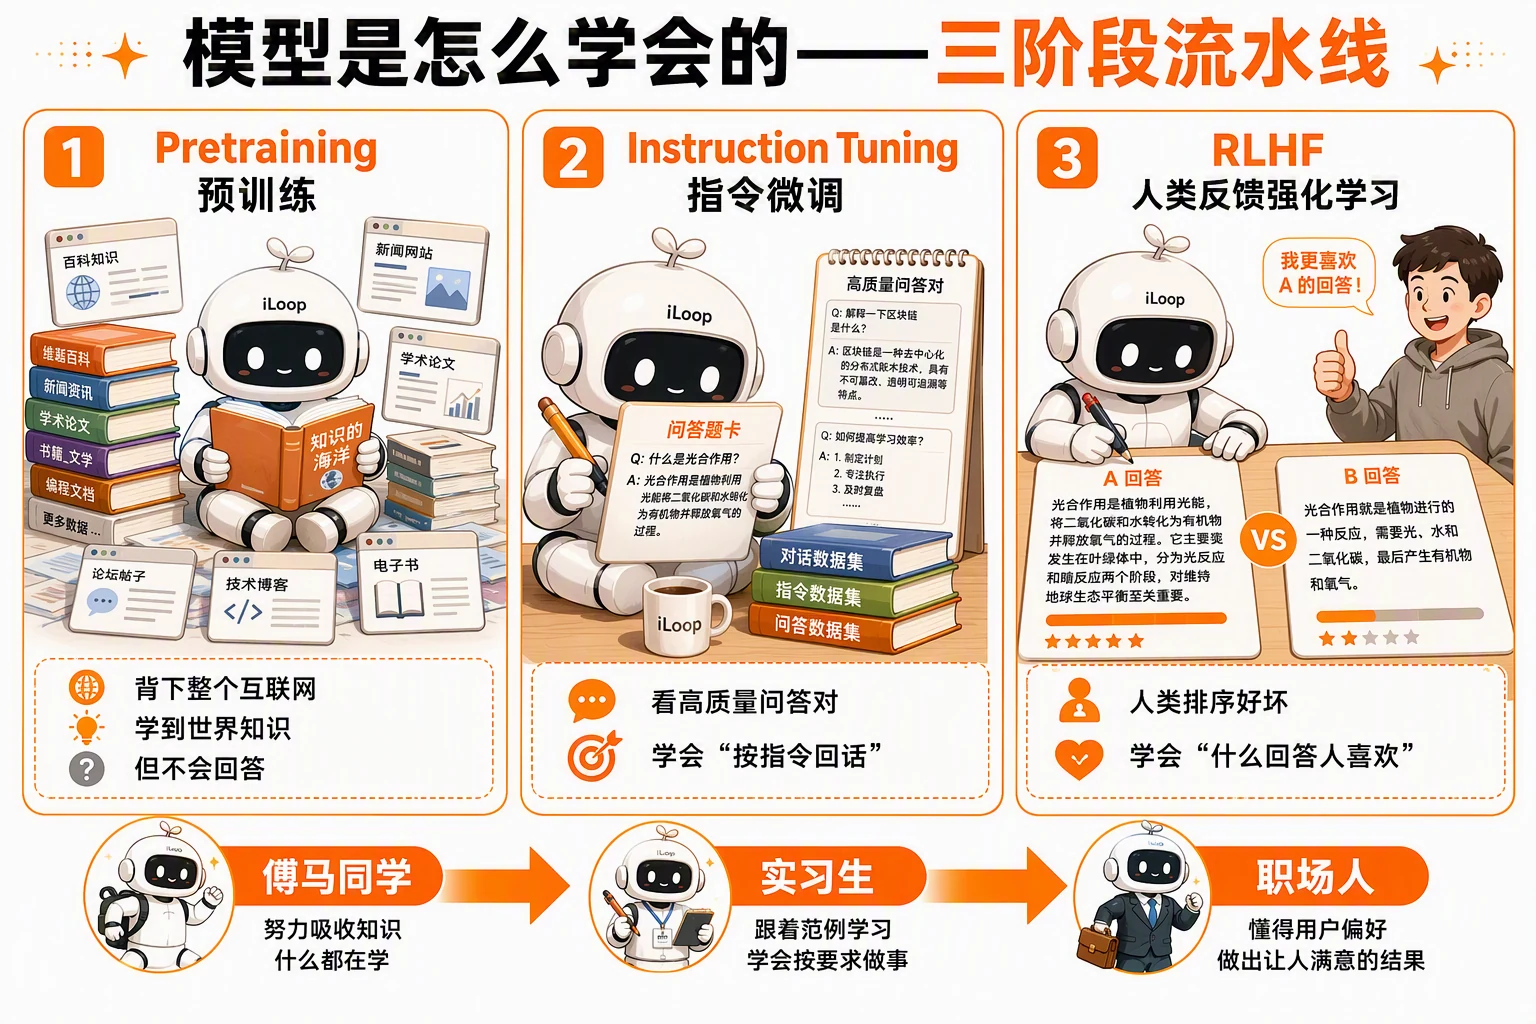
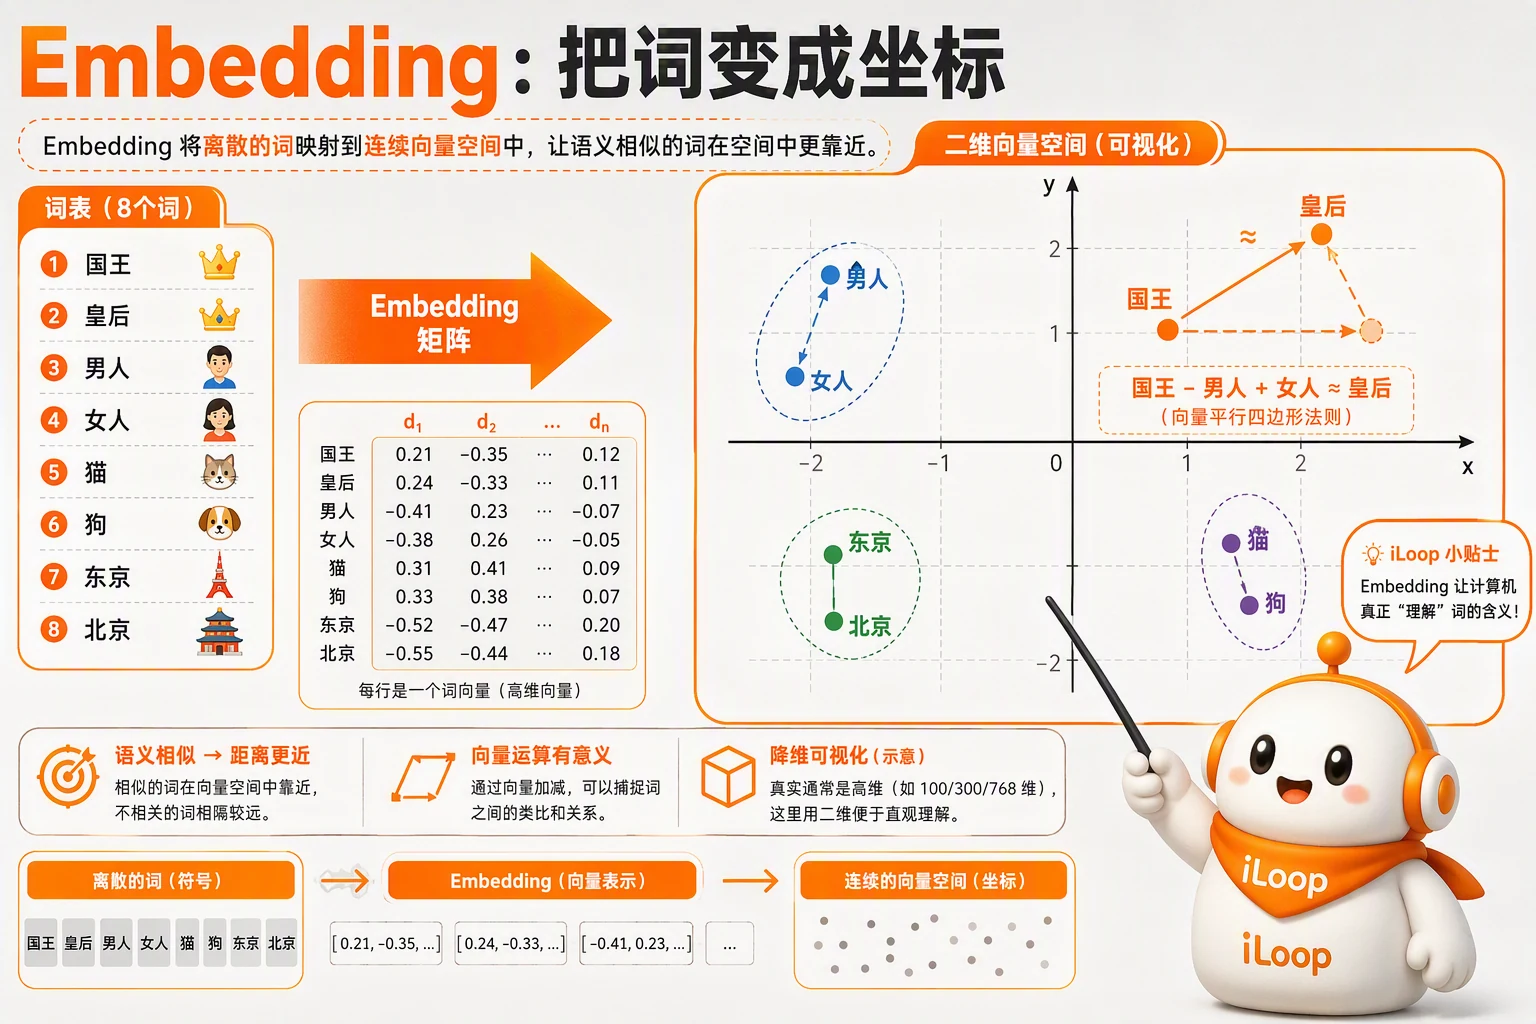
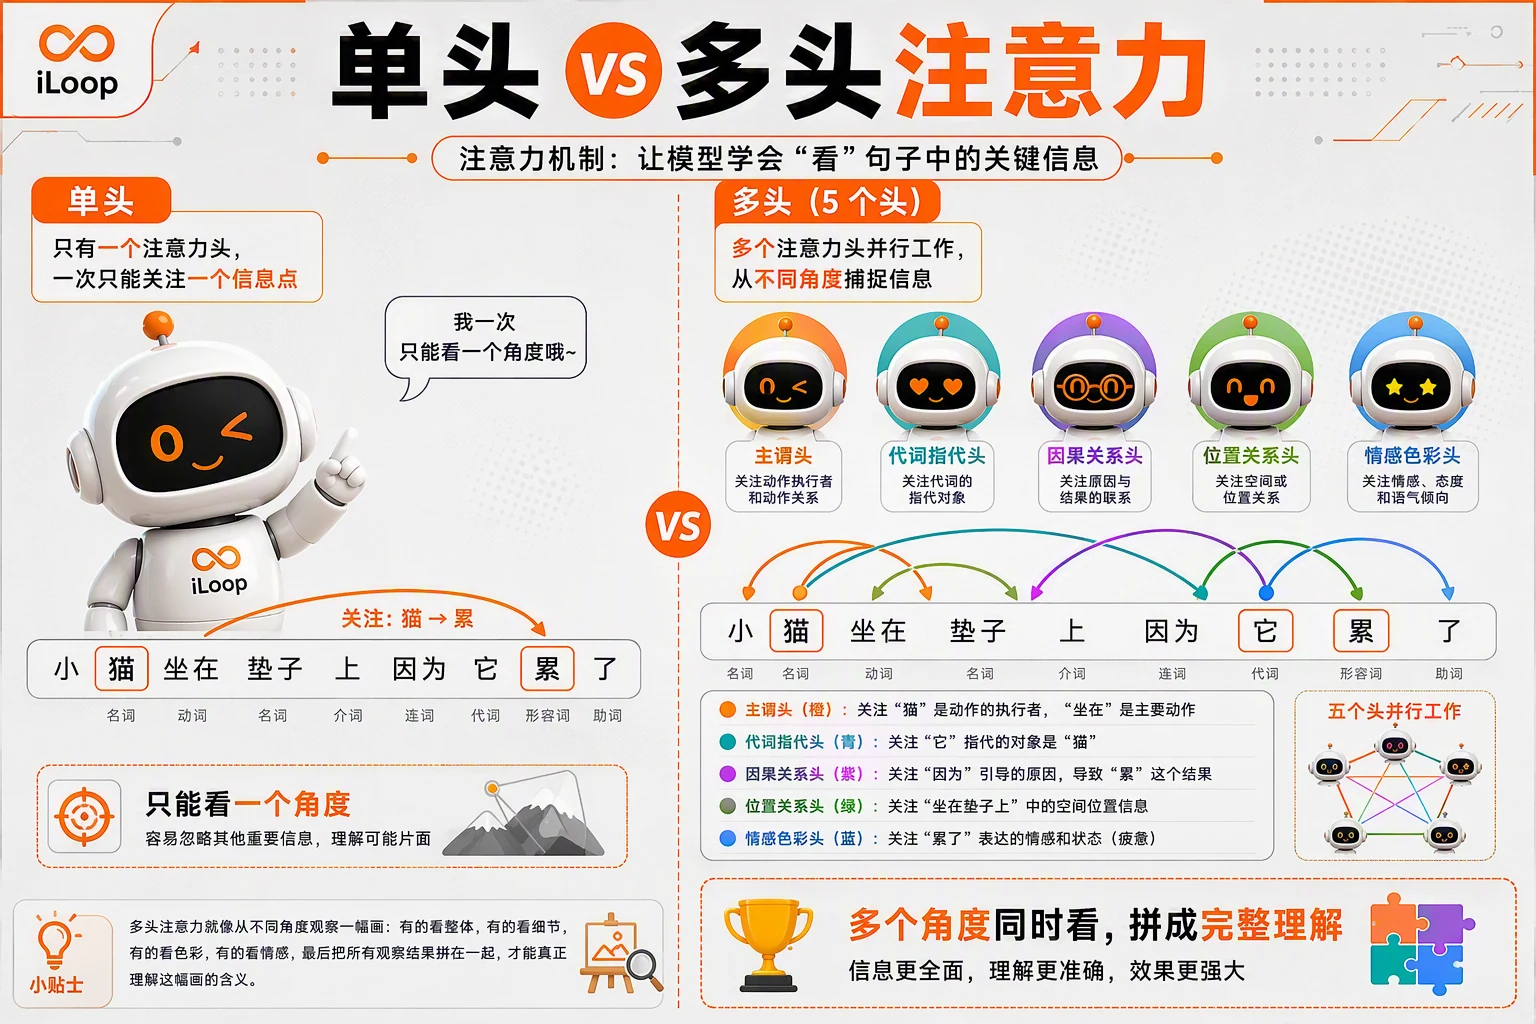
- 图要值得看:结构、顺序和关系难用一句话说清,就用图;图的每个词都对应正文,删图不影响理解的就不画。比如《写给 RD 的 AI 底层原理》里大量的图,就是为了把抽象的概念直给。
engineering-docs流程图:
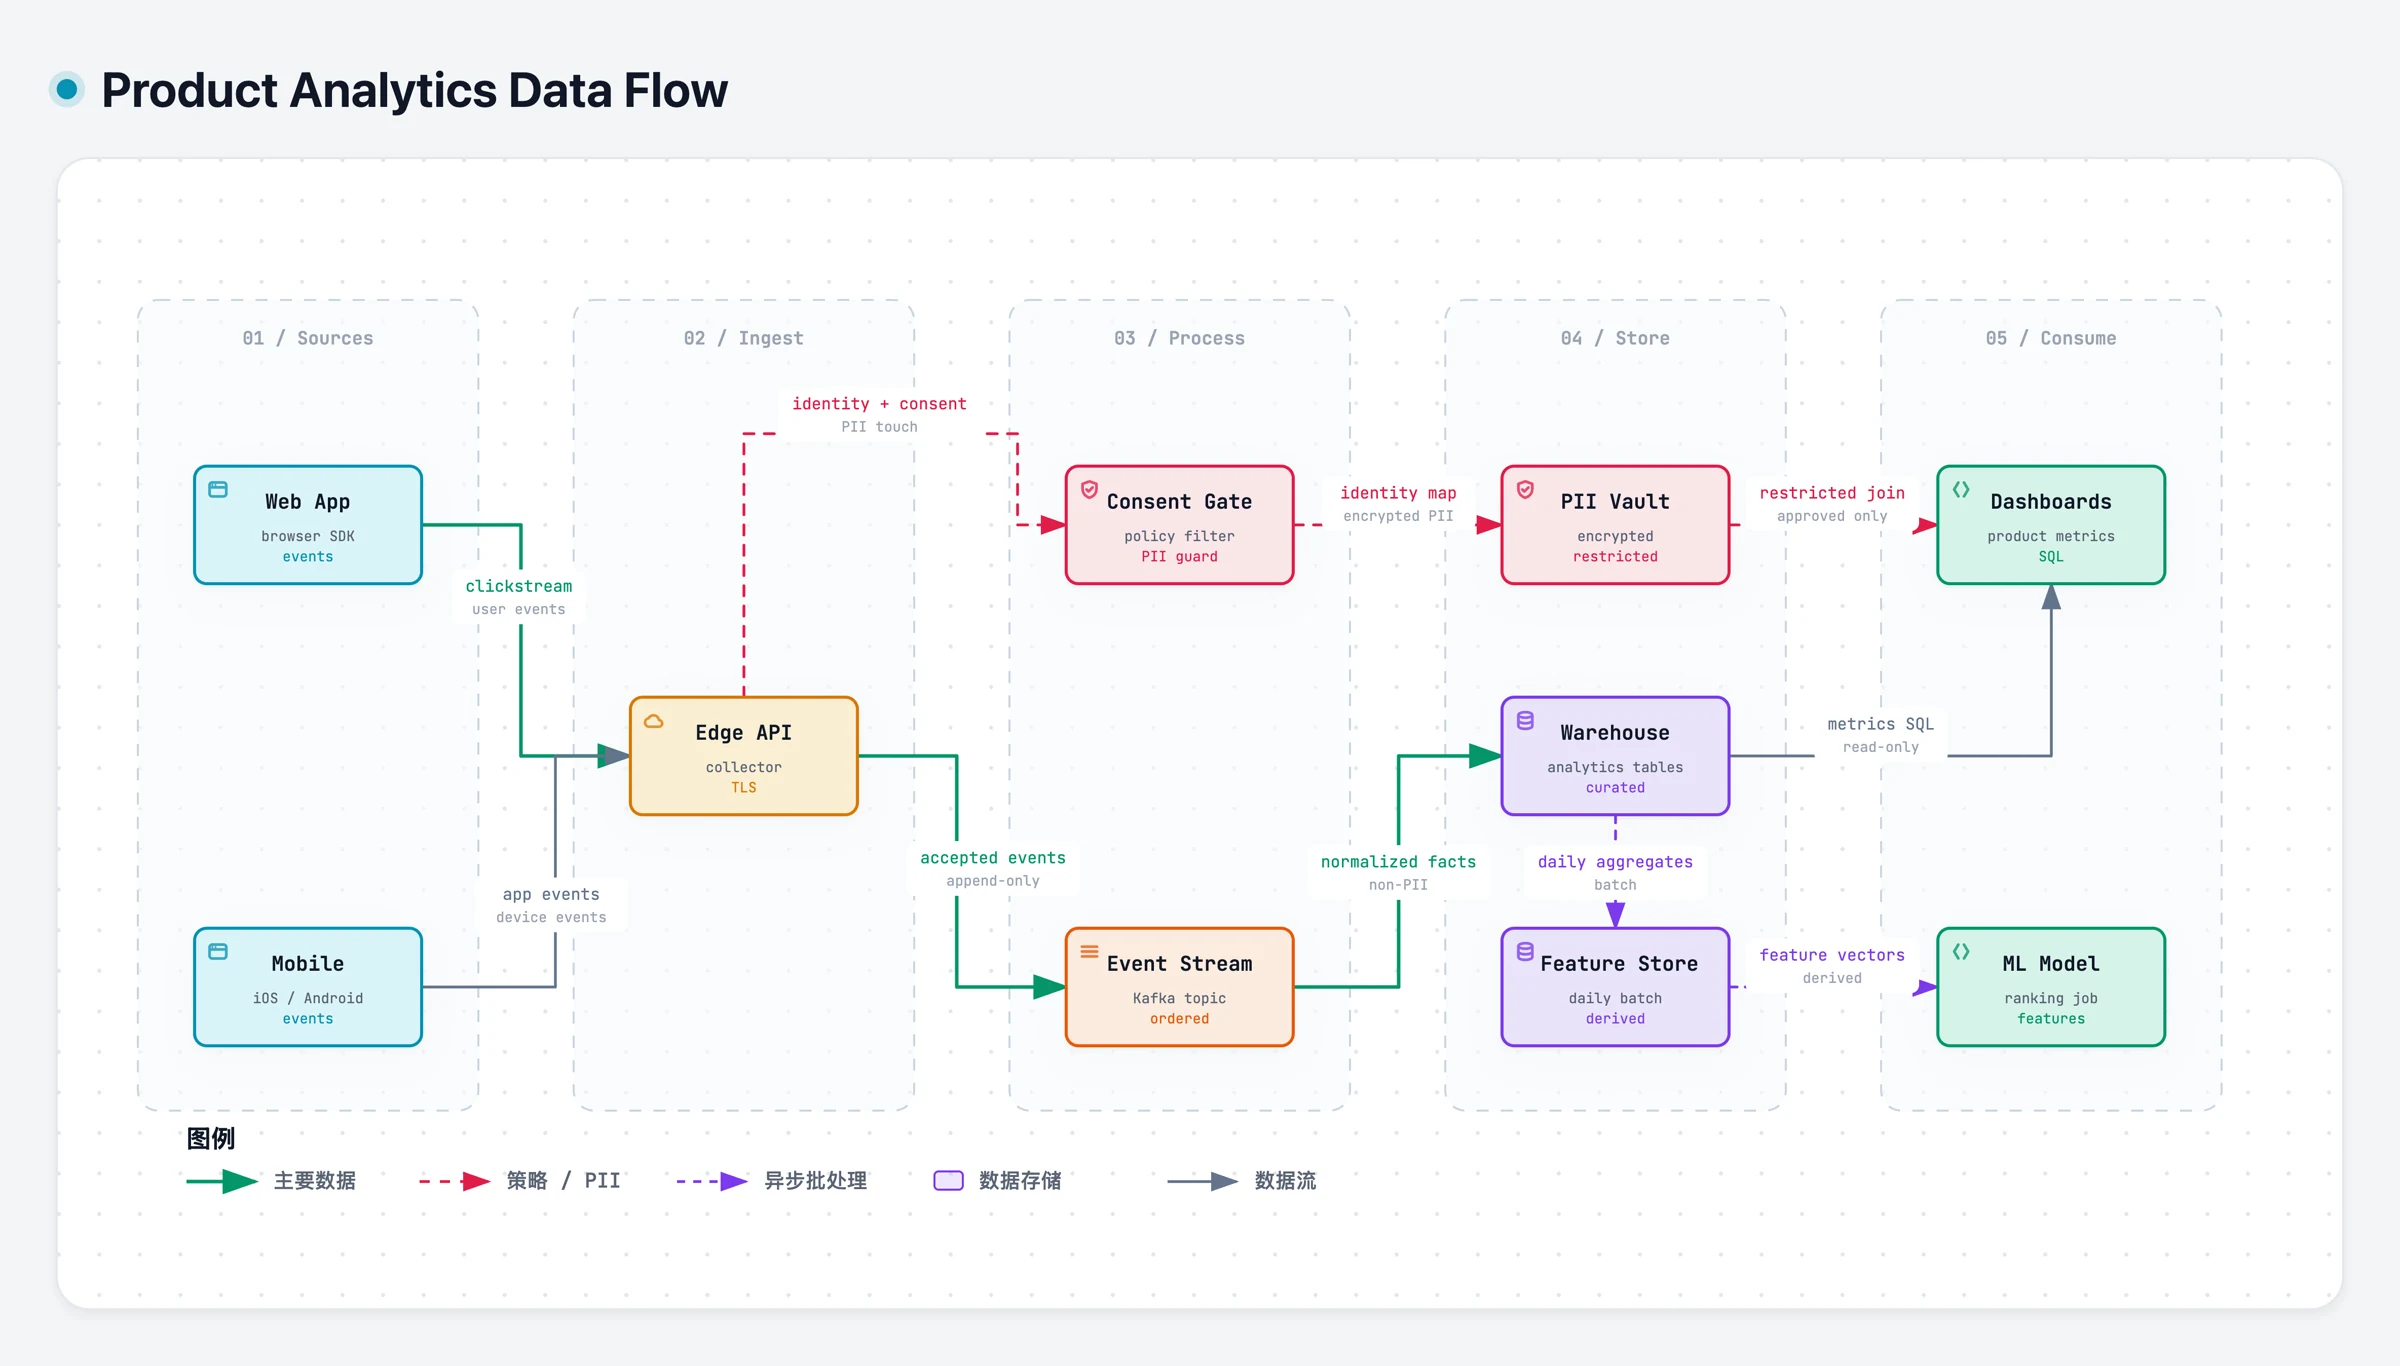
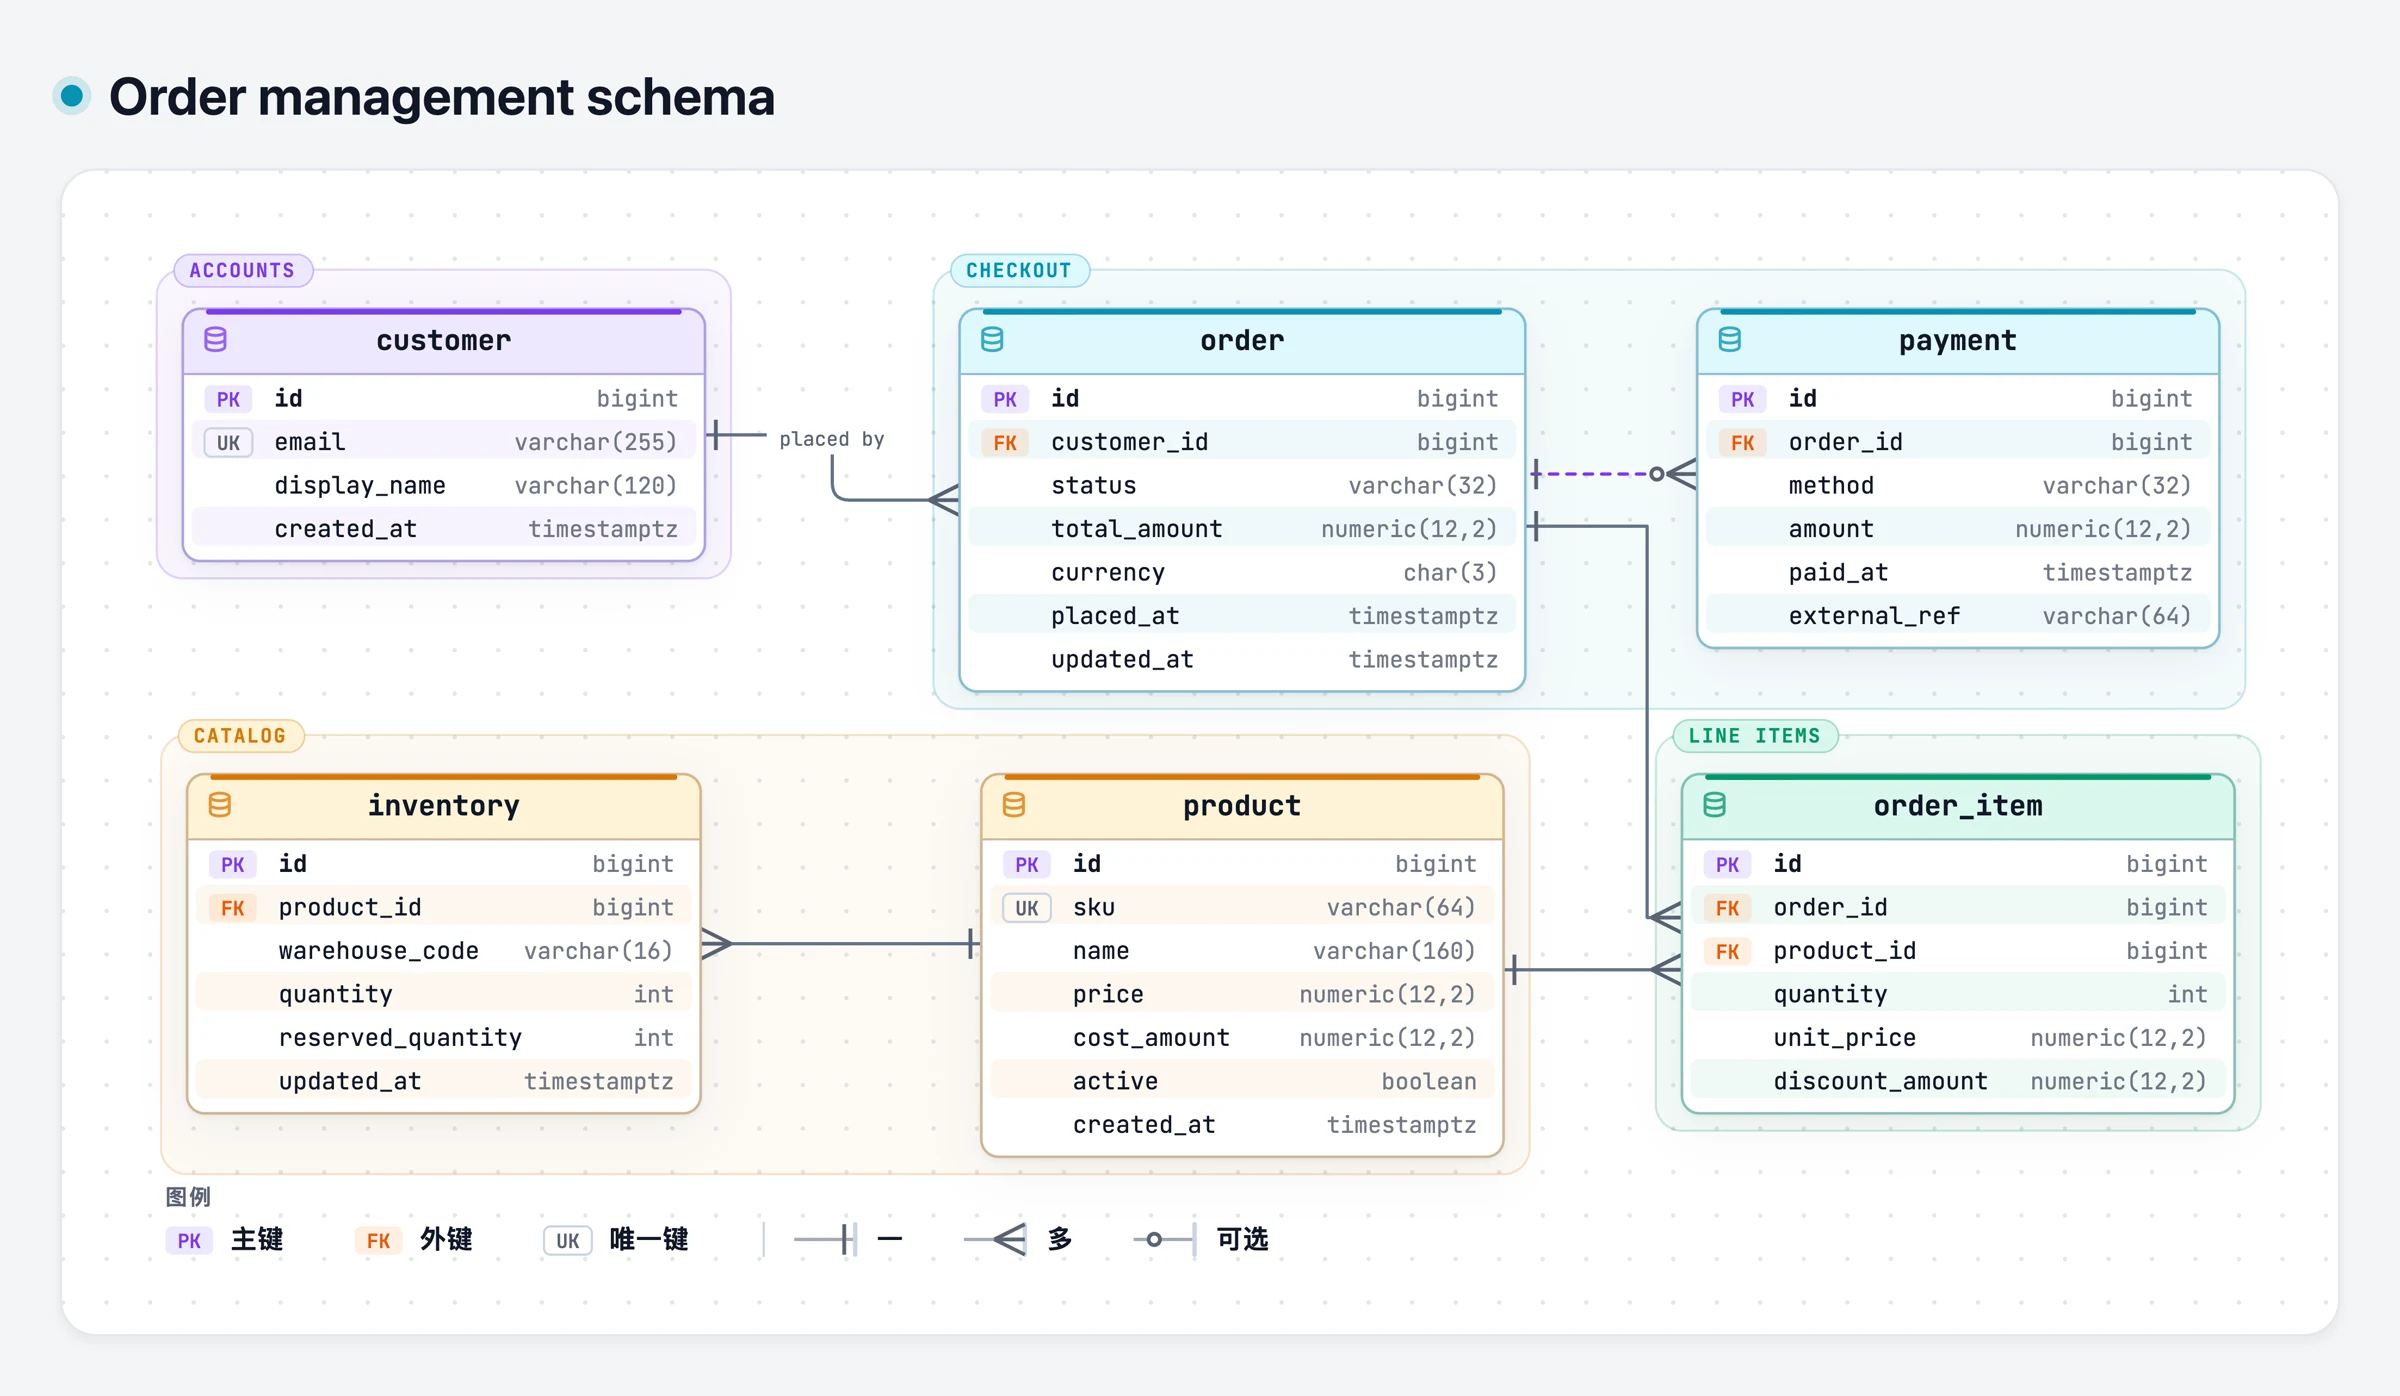
engineering-docs文字结构:
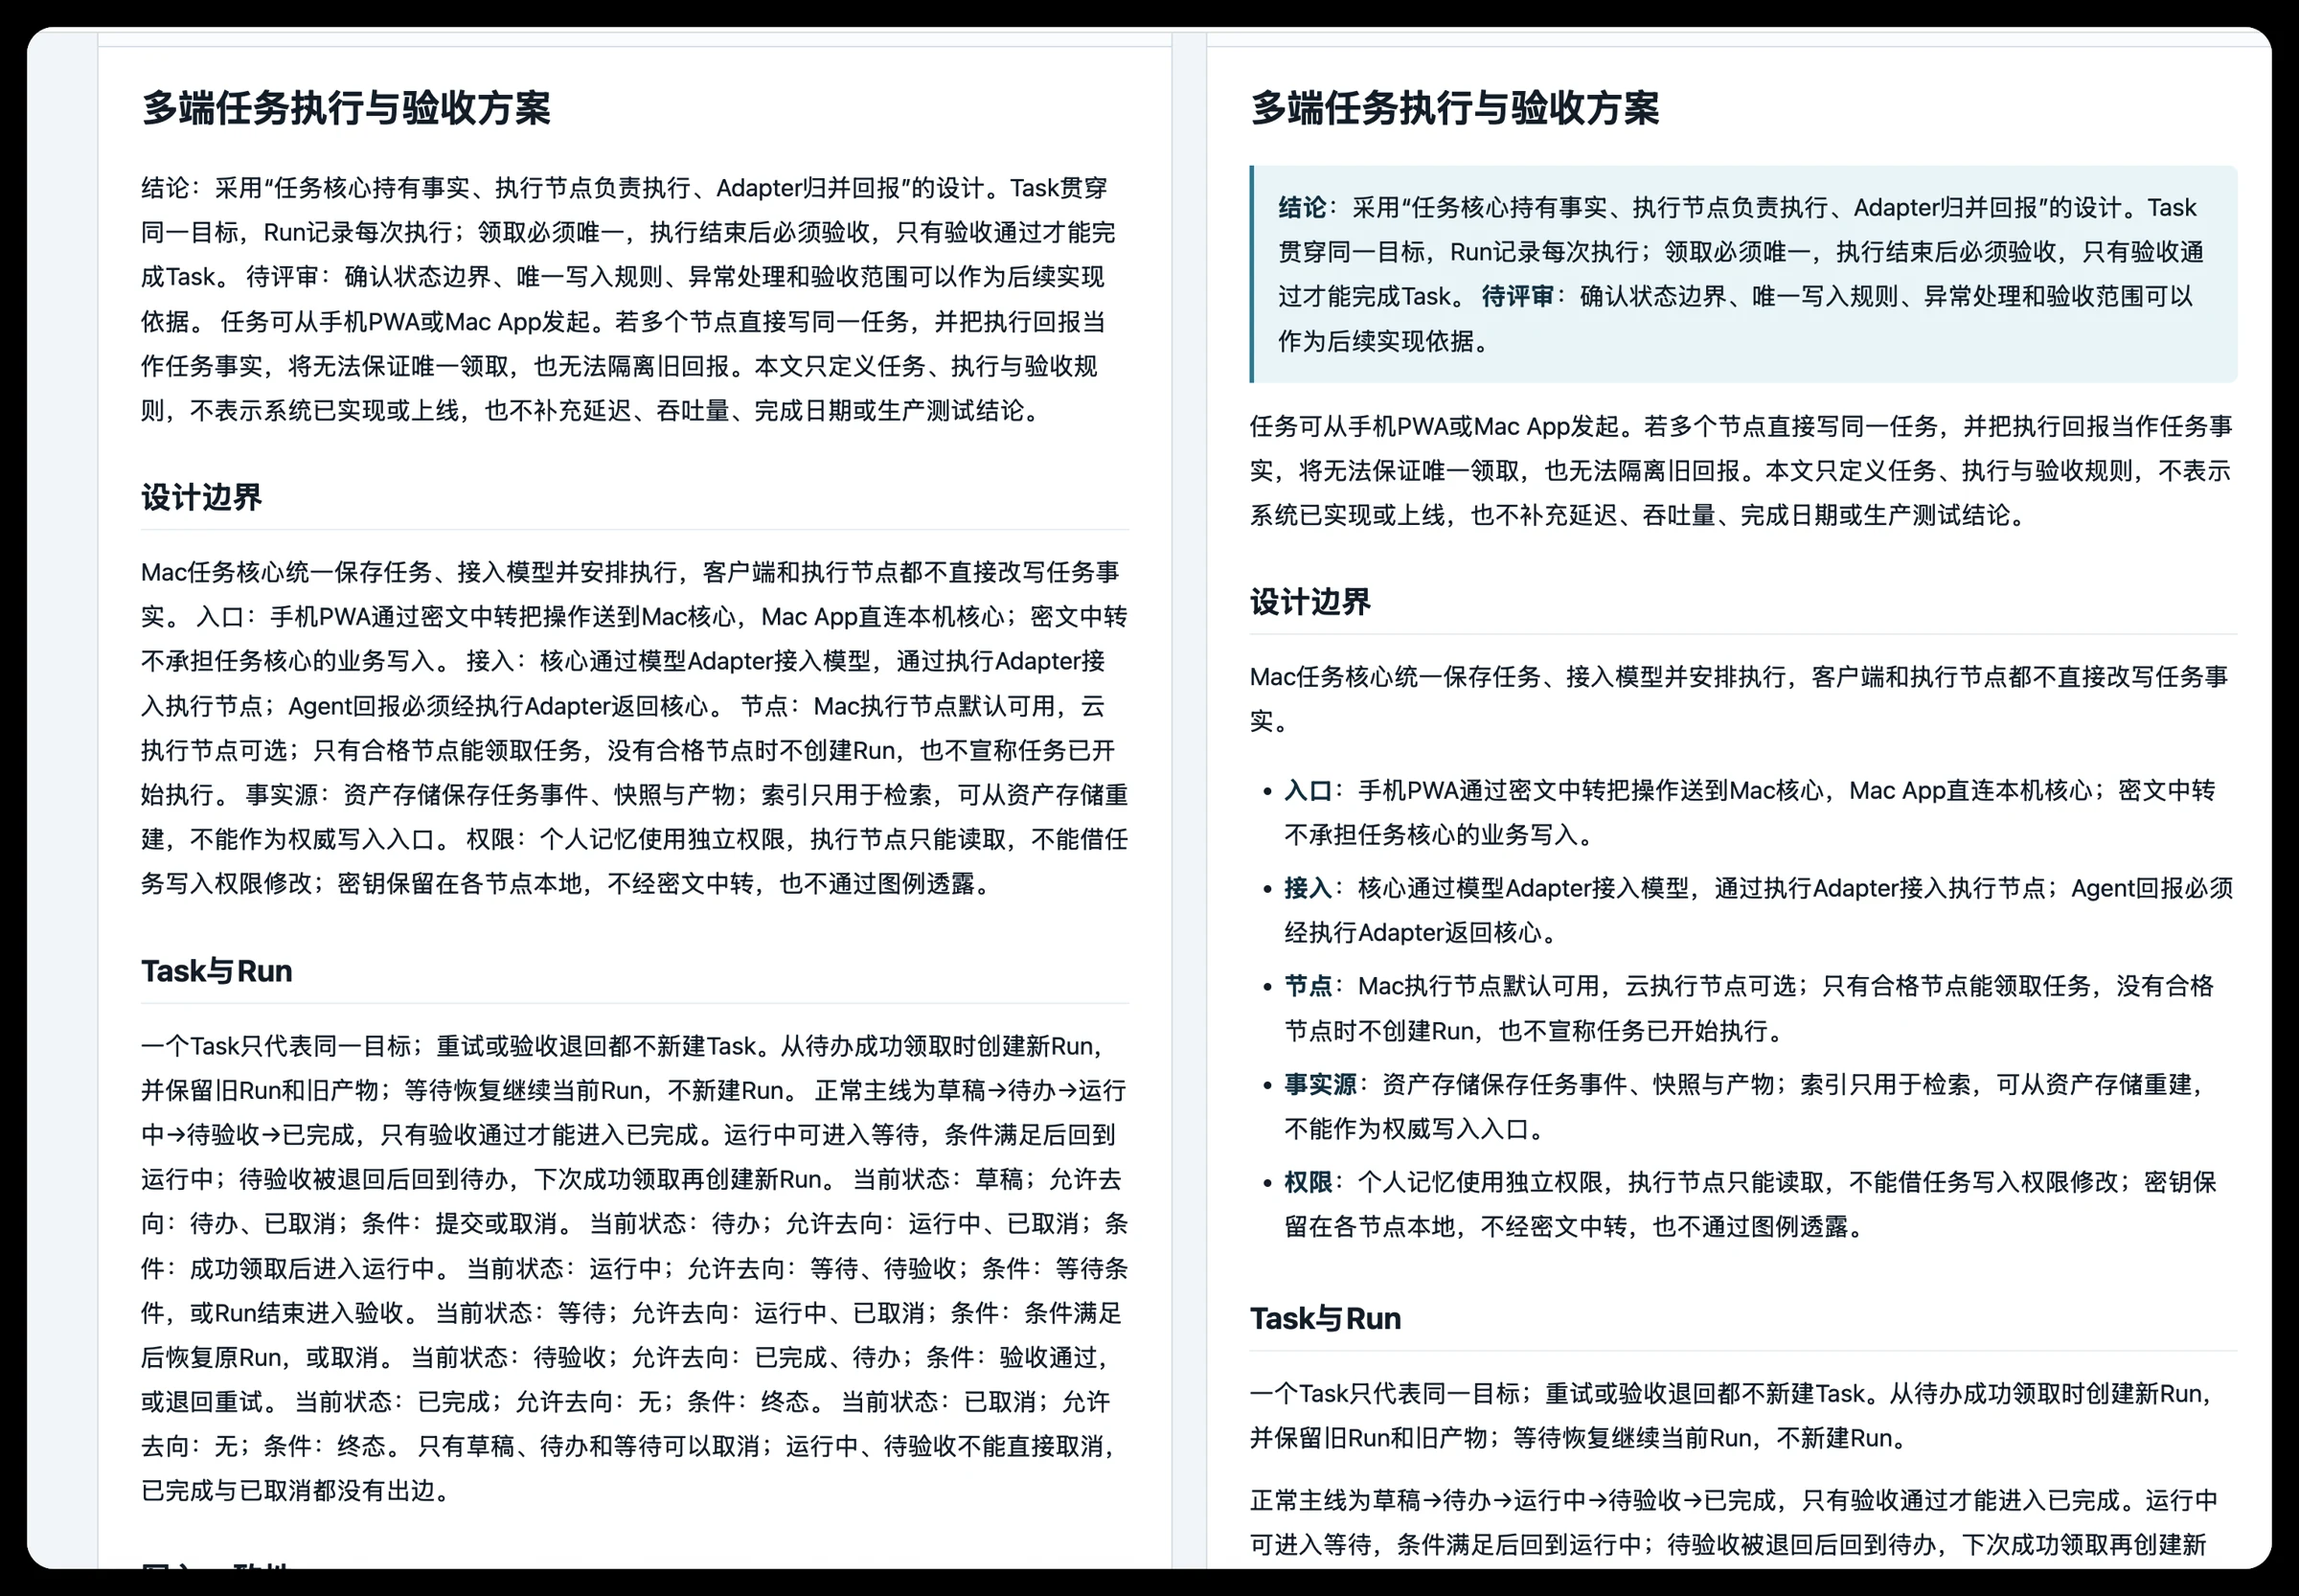
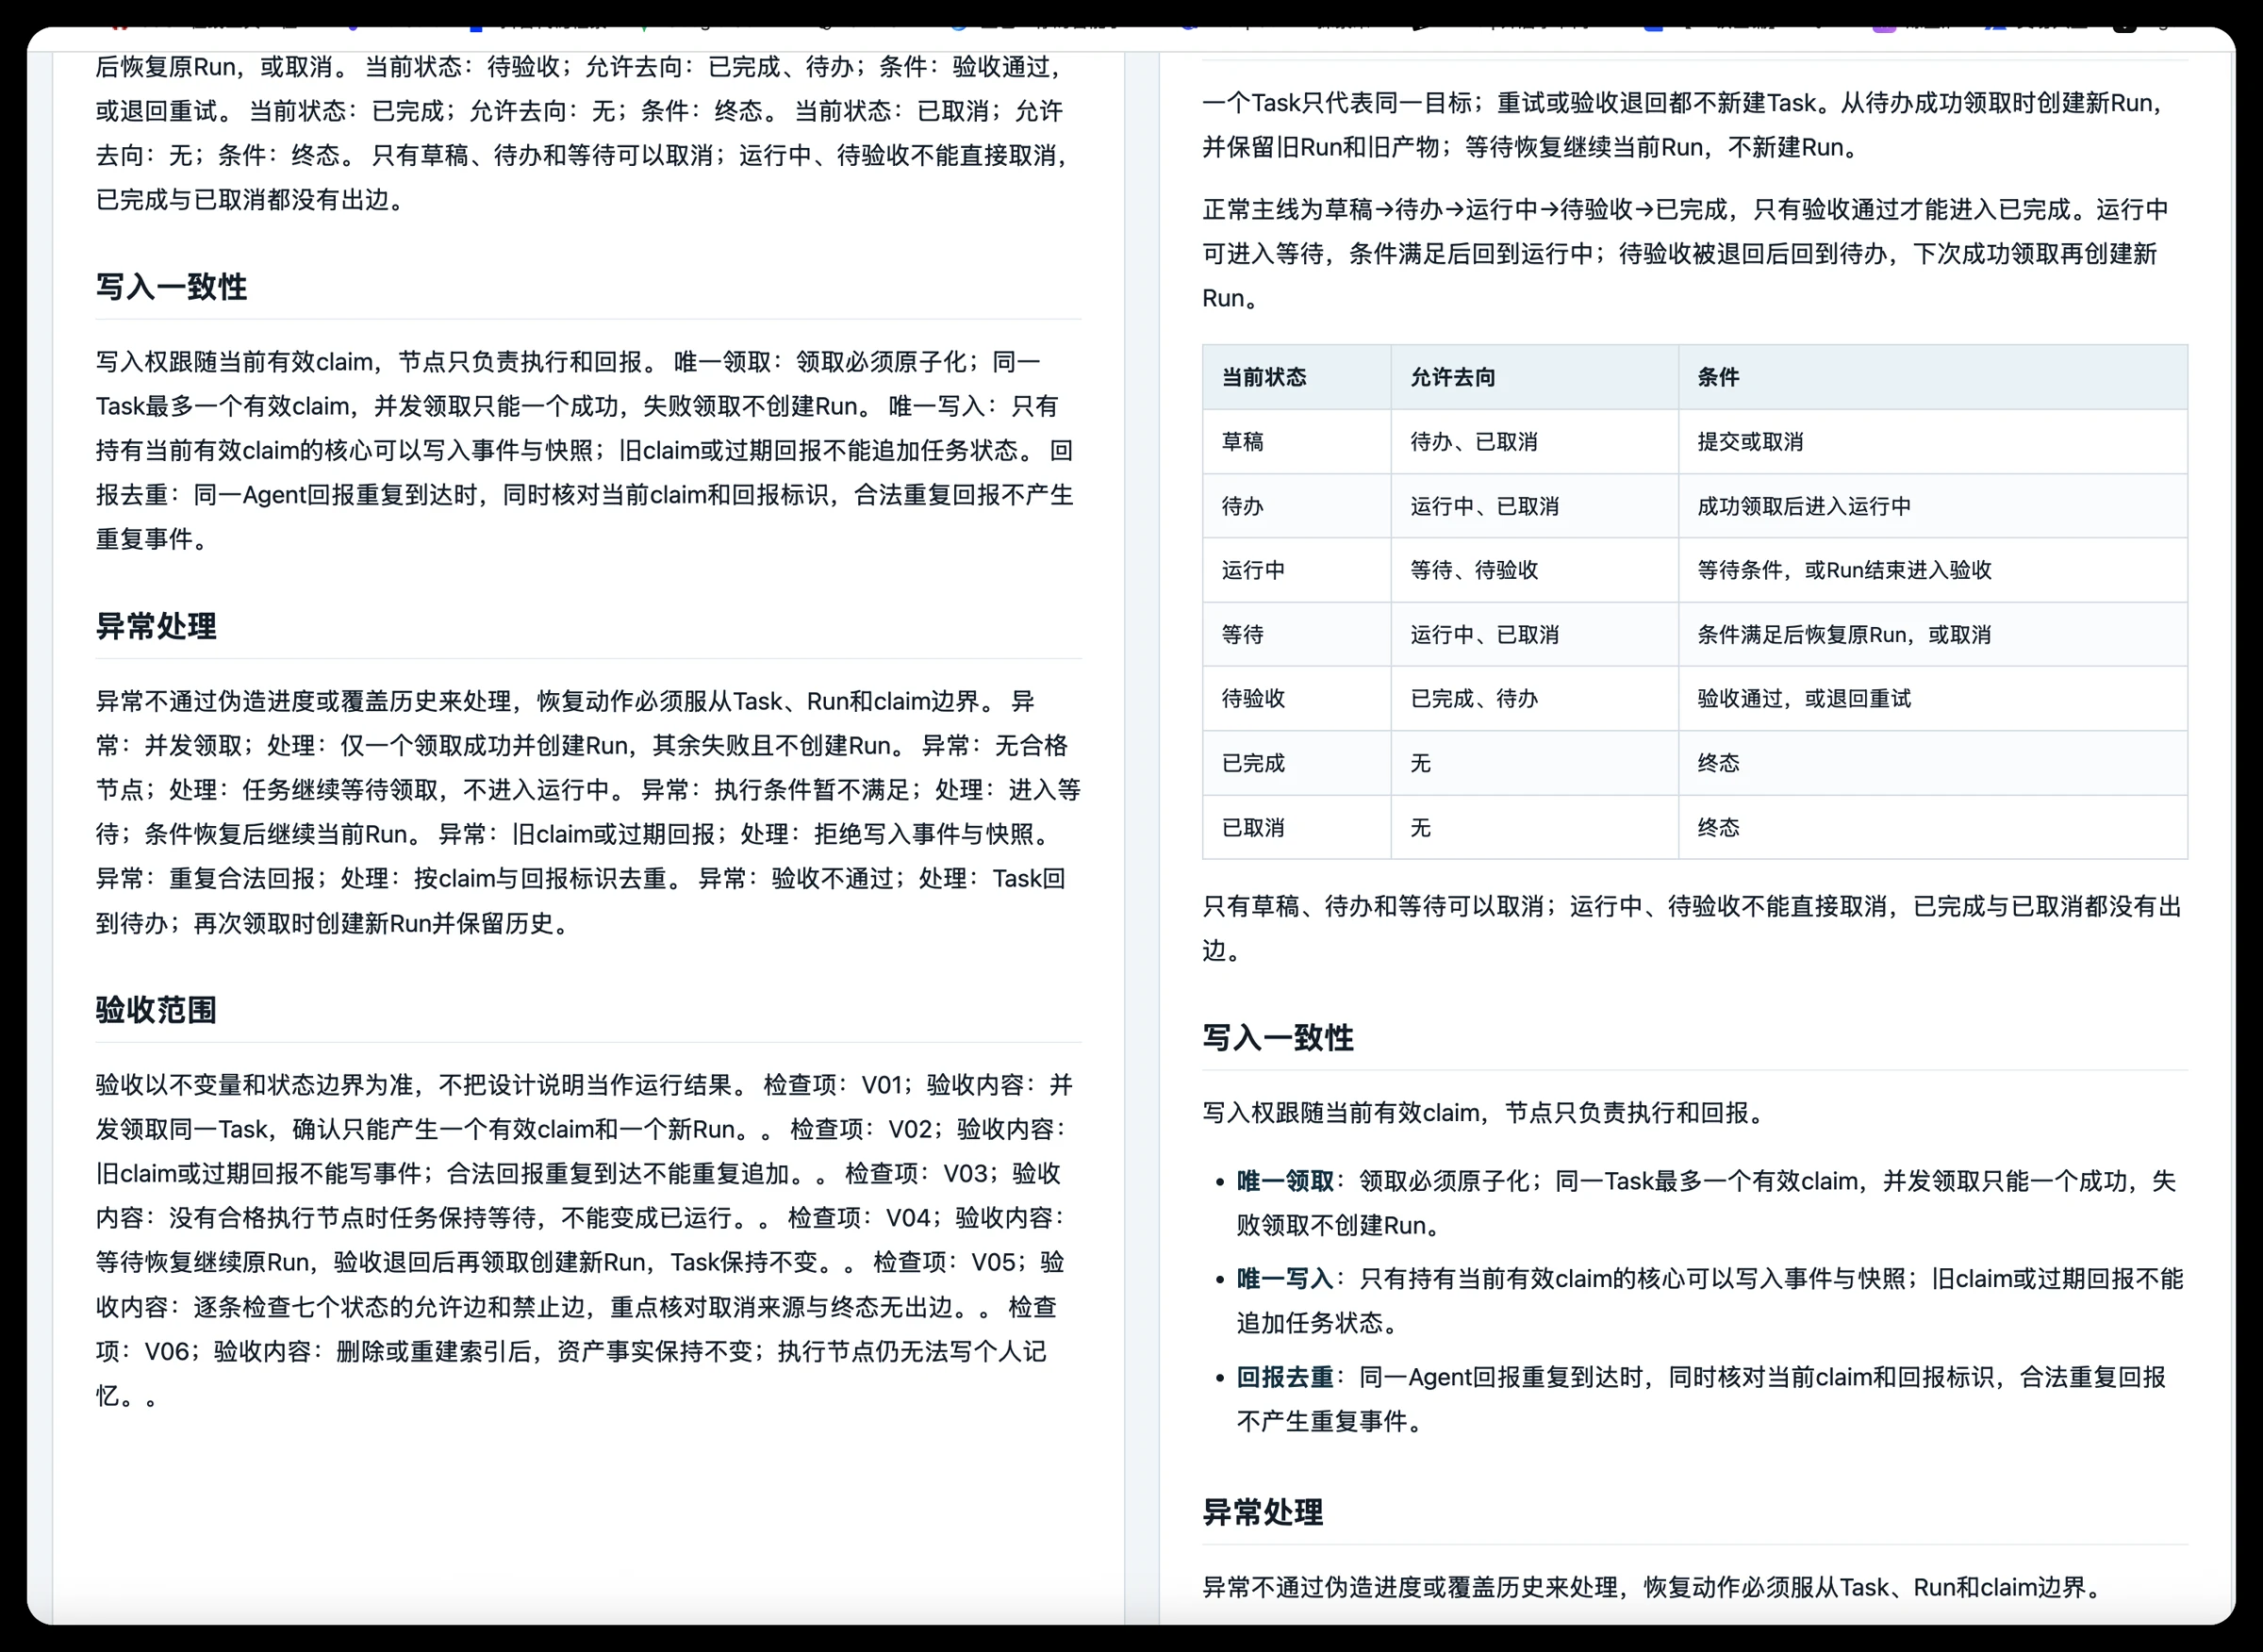
content-infographic内容提取
AI做游戏
国庆前,看到一些内部AI平台做的游戏,你别说,还真挺好玩。恰逢国庆期间杭州阴雨连绵,于是就窝家里疯狂搞游戏。七天1000多个版本,做出《界门》,里面包含四种流派、二十八个技能、十章一百个房间,全程都是AI做的,过程细节在《怒肝 1000 版本实录》。过程确实挺爽的,试问谁不想做自己游戏世界的主宰呢?
我说「打击感强一点」,它只给我配了一个 duang 的音效。给我脑袋瓜听的嗡嗡的。怎么AI就听不懂人话吗?
于是让它去调研某款游戏,把打击感拆成音效、画面、震动,再由我来挑。过程里最难的,反而是把「好玩」说清楚:
- 稀缺的是想法:执行门槛压低以后,好不好玩取决于玩法、手感和取舍,我主要是出想法的人。
- 验证靠真人:概念稿先确认外观再实装,数值靠训练场跑强度测试,真人试玩才暴露按键冲突和存档问题。
回头想想,这些不务正业的尝试,一半是学 AI,一半是树立自信:不被旧经验和现成软件框住,想到就敢动手。以前跟我说,没经验也能做游戏、3D、嵌入式,我会觉得是痴人说梦。
做下来越来越相信,想法不该被旧能力边界限制,大不了烧点 token。这种上手的底气,也会带回真正未知的工作和生活里。
哎呀,怎么还整起虚的了,说点能落地的。我想可能是:
- 发现问题。这一步最重要:先找到到底哪里有问题、哪里要提高、哪里缺东西。
- 和 AI 一起调研。业界有没有人对这件事已经有想法和判断,有没有做好的东西,或者现成的思路。
- 有就拿来当输入,没有就拆解、做假设。好好说话就是后一种:当时业界没有现成的解释,只能先假设,再一步步验证。
- 快速验证。跑出结果再看假设对不对,不对就回去改假设。
- 面对结果。成了,牛逼。失败了,费点token,排除一个错误选项。属于是秦始皇摸电线,赢麻了。
现在这些成本都降下来了,有了任何想法马上就去尝试吧,万一成了呢。
阶段 7 · Harness 与其他定制(9 月至今)
去更广的地方找更多的解,比如Harness和Mac软件生态
Agent、技能和工具链覆盖不了所有工作场景。比如想看清一个技能是怎么被选中、工具经过哪些调用,就要到控制执行的 Harness 里看。问题出在哪一层,就到那一层改。前面攒下的方法,也需要一个能统一装配和运行的工作台。
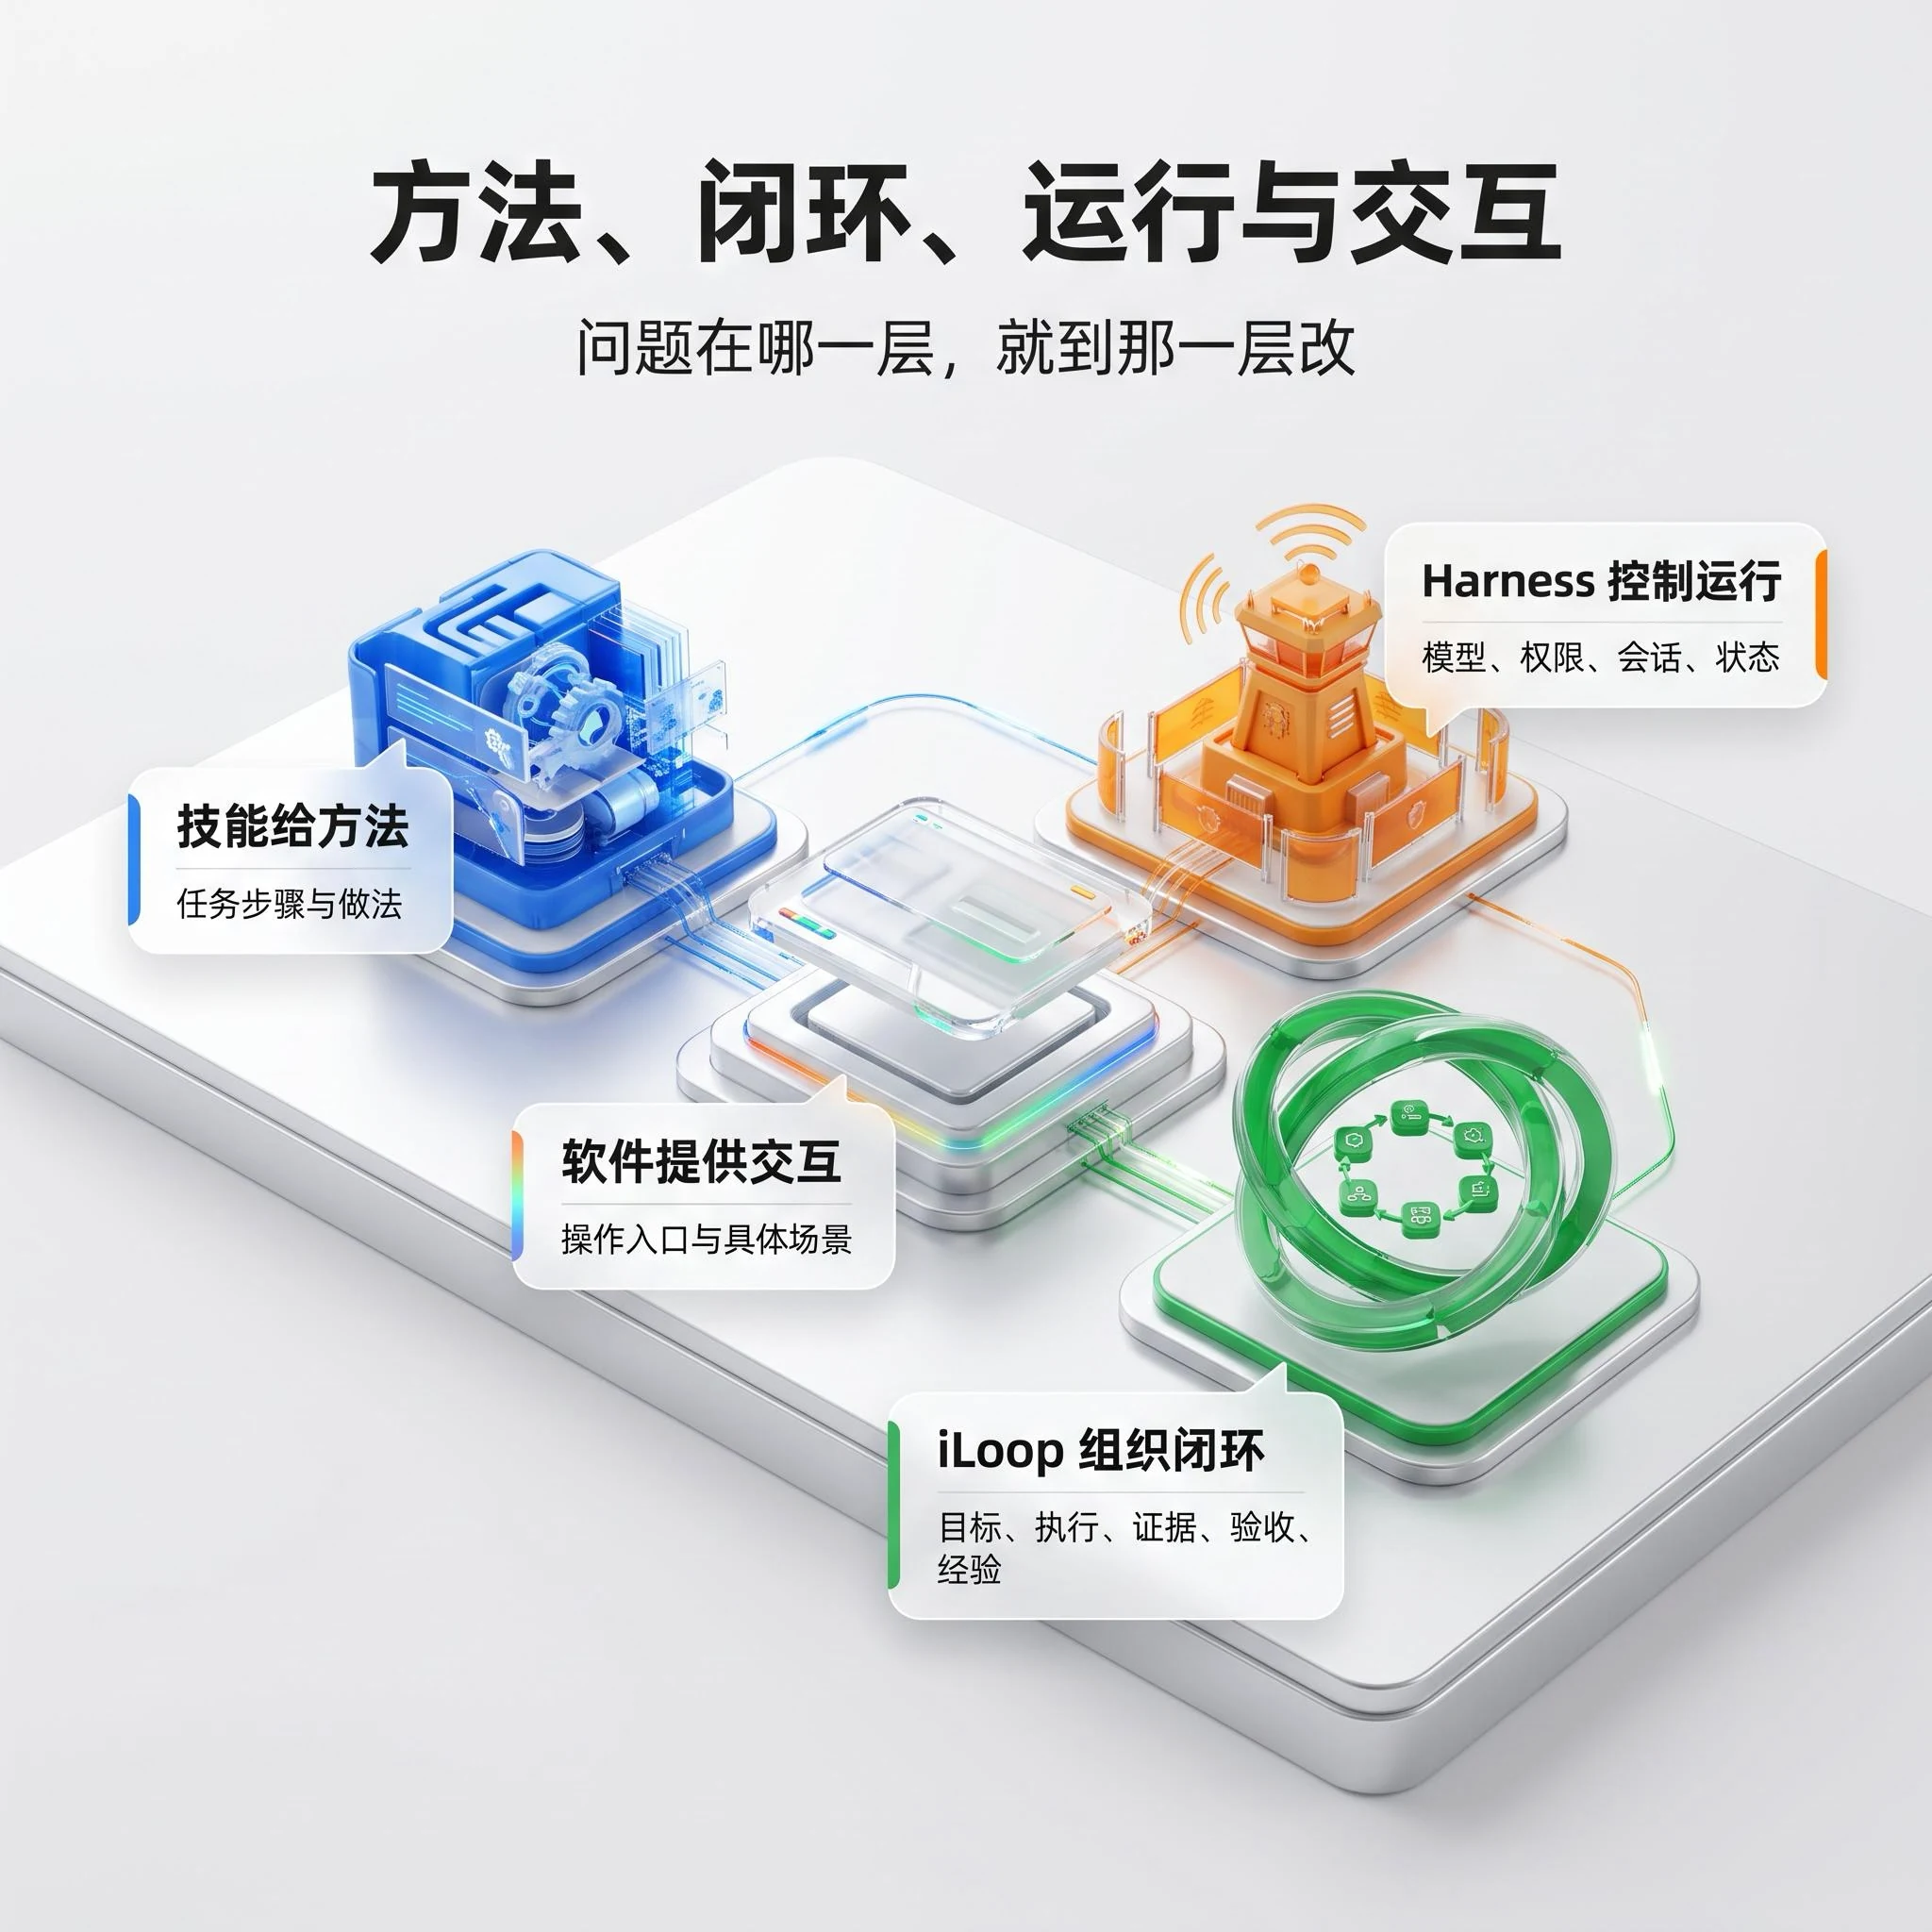
- 技能给方法:这类任务按什么步骤处理。
- iLoop 组织闭环:把目标、执行、证据、验收和经验接起来。
- Harness 控制运行:谁执行、用什么模型、有哪些权限、会话和状态如何记录。
- 软件提供交互:把操作入口做成顺手的 App,接住具体工作场景。
DeepSeek Harness
Agent 框架 π 和 DeepSeek Harness(DSH)都能扩展,核心思路不同(对比文档):
- π 给你一个写死的稳定内核,你在边上挂钩子改行为;
- DSH 一切皆插件,连 Agent 主循环都能整个换掉,插件卸载时副作用还能自动撤干净。
我选 DSH 做个人定制,看中的是更深的可定制性:连循环本身都能插件化,组件还可以热更新。AI 改完自己的插件,运行中就能换上,这给自迭代系统留了可能。当然也还在探索,反正先出MVP,后面慢慢迭代。
DSH 提供通用运行时,我没有再造一套 Agent 循环。Personal Harness负责装配:把 iLoop、VDD、个人 Skills、模型分工和工具入口固定成同一套工作方式。图里分开的是方法、执行、任务记录和外围适配。
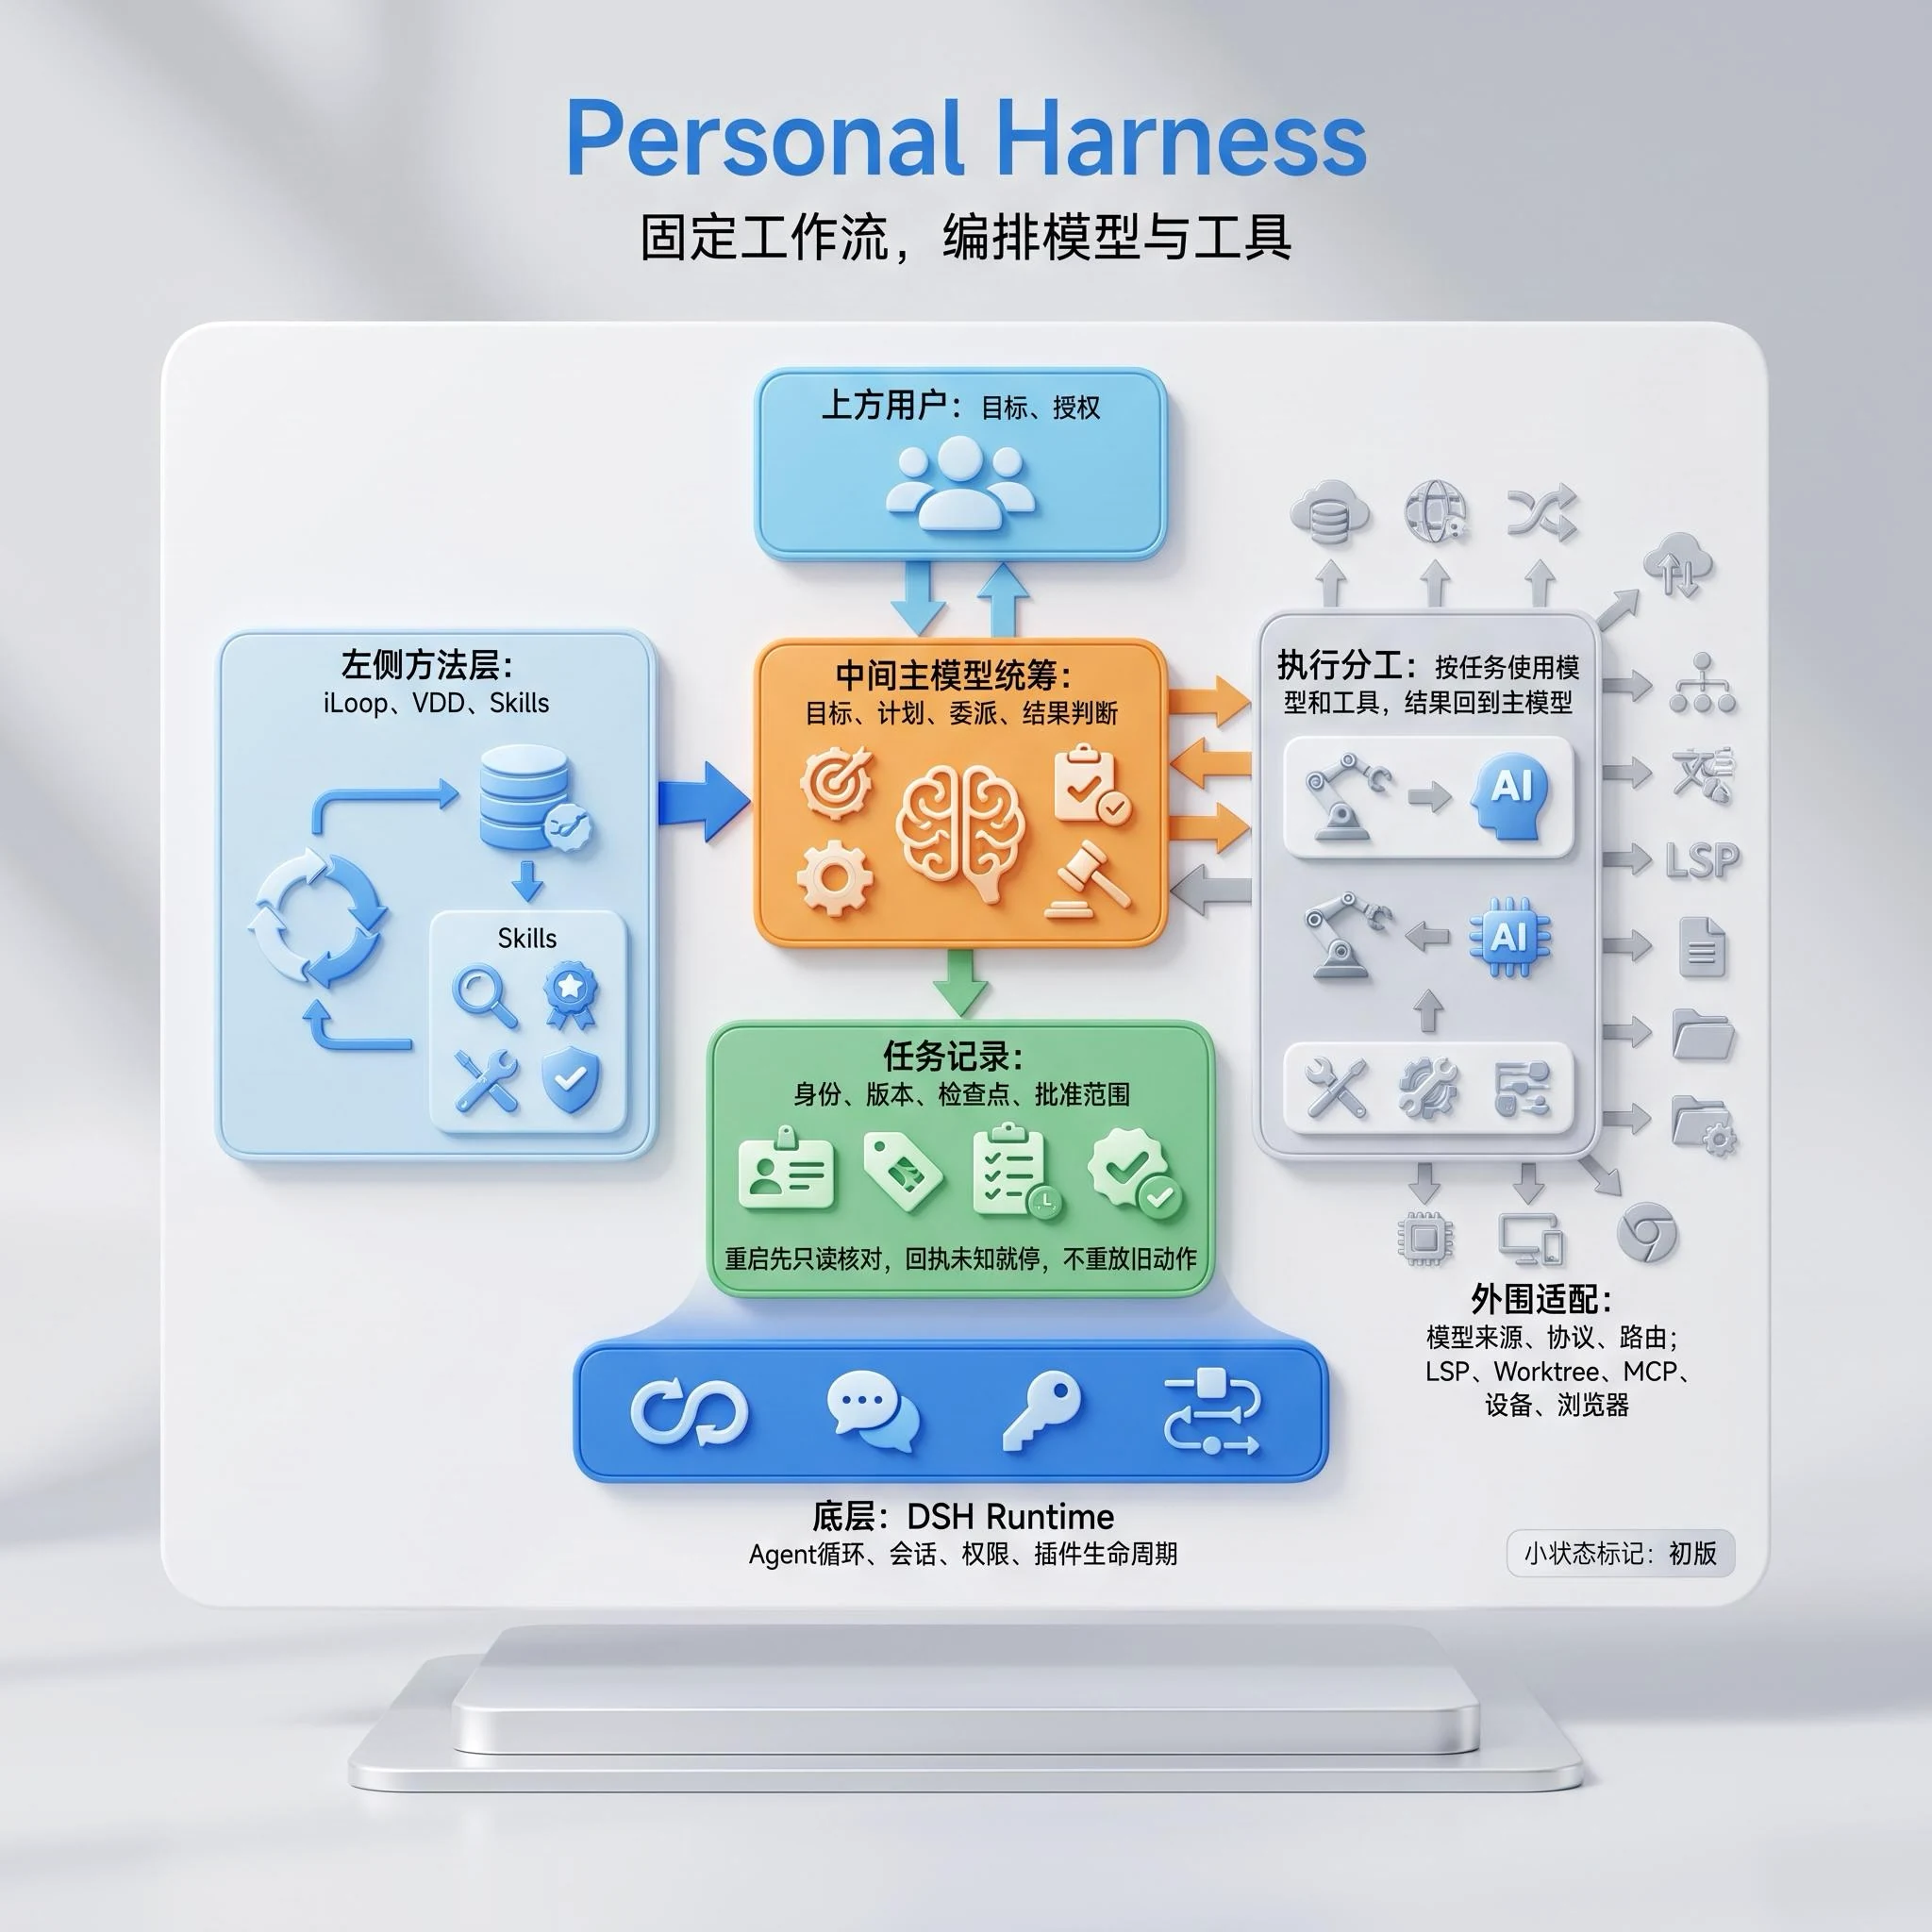
一次任务大致这样走:
- 先统筹:主模型确定目标和计划,选择需要的工作流与技能;iLoop 组织循环,VDD 约束验证和完成声明。
- 再委派:执行层按分工使用模型与工具,具体结果回到主模型;复杂判断不随手交给一个只负责执行的角色。
- 记录后再继续:任务记录保存身份、版本、检查点和批准范围。会话重启先只读核对,回执未知就停,不自动把旧动作重做一遍。
- 方法与环境分开:方法在核心里,模型、宿主版本、MCP 与本机工具从适配层接入。换基建形态时保留工作方式,不重新拼整套流程。
这就是它的增量:把前面零散的方法装成可持续维护的工作台。现在仍是初版,生产任务还没有全部迁过来;已有分项测试和路由实证,不等于整套工作流都已验证成熟。
重构软件生态
Harness 之外还有更外的一层:每天在用的PC软件。试下来发现,做一个 Mac App 的成本很低,而且即装即用,不像 iPhone 还要折腾证书。于是我们可以根据自己的工作流重新梳理一下,哪些软件还是空白?哪些软件还不好用?我们都可以通过自制的软件做替换。不必怕上个时代的软件霸权,很多厂商引以为傲的护城河,可能已经干涸了。
其实很多同事已经开始这么做了,比如有同事按自己的 AI 流程在 Mac 上做了任务管理软件,有人嫌收费软件不好用,自己结合 AI 重写了一个。
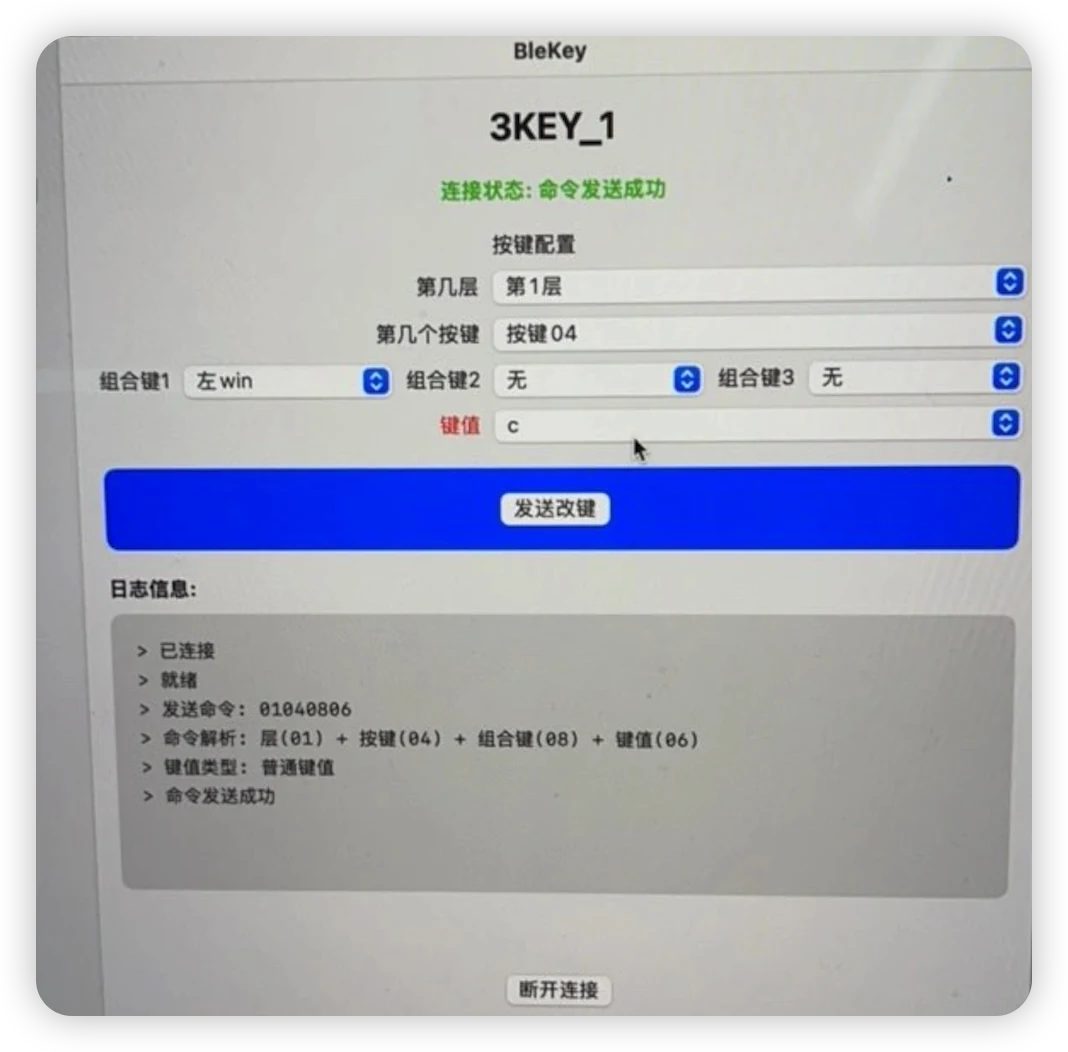
我之前有个小硬件的Mac修改程序非常拉胯。我就几个小时直接重写了一个,还是自己的软件用着不烧心啊。
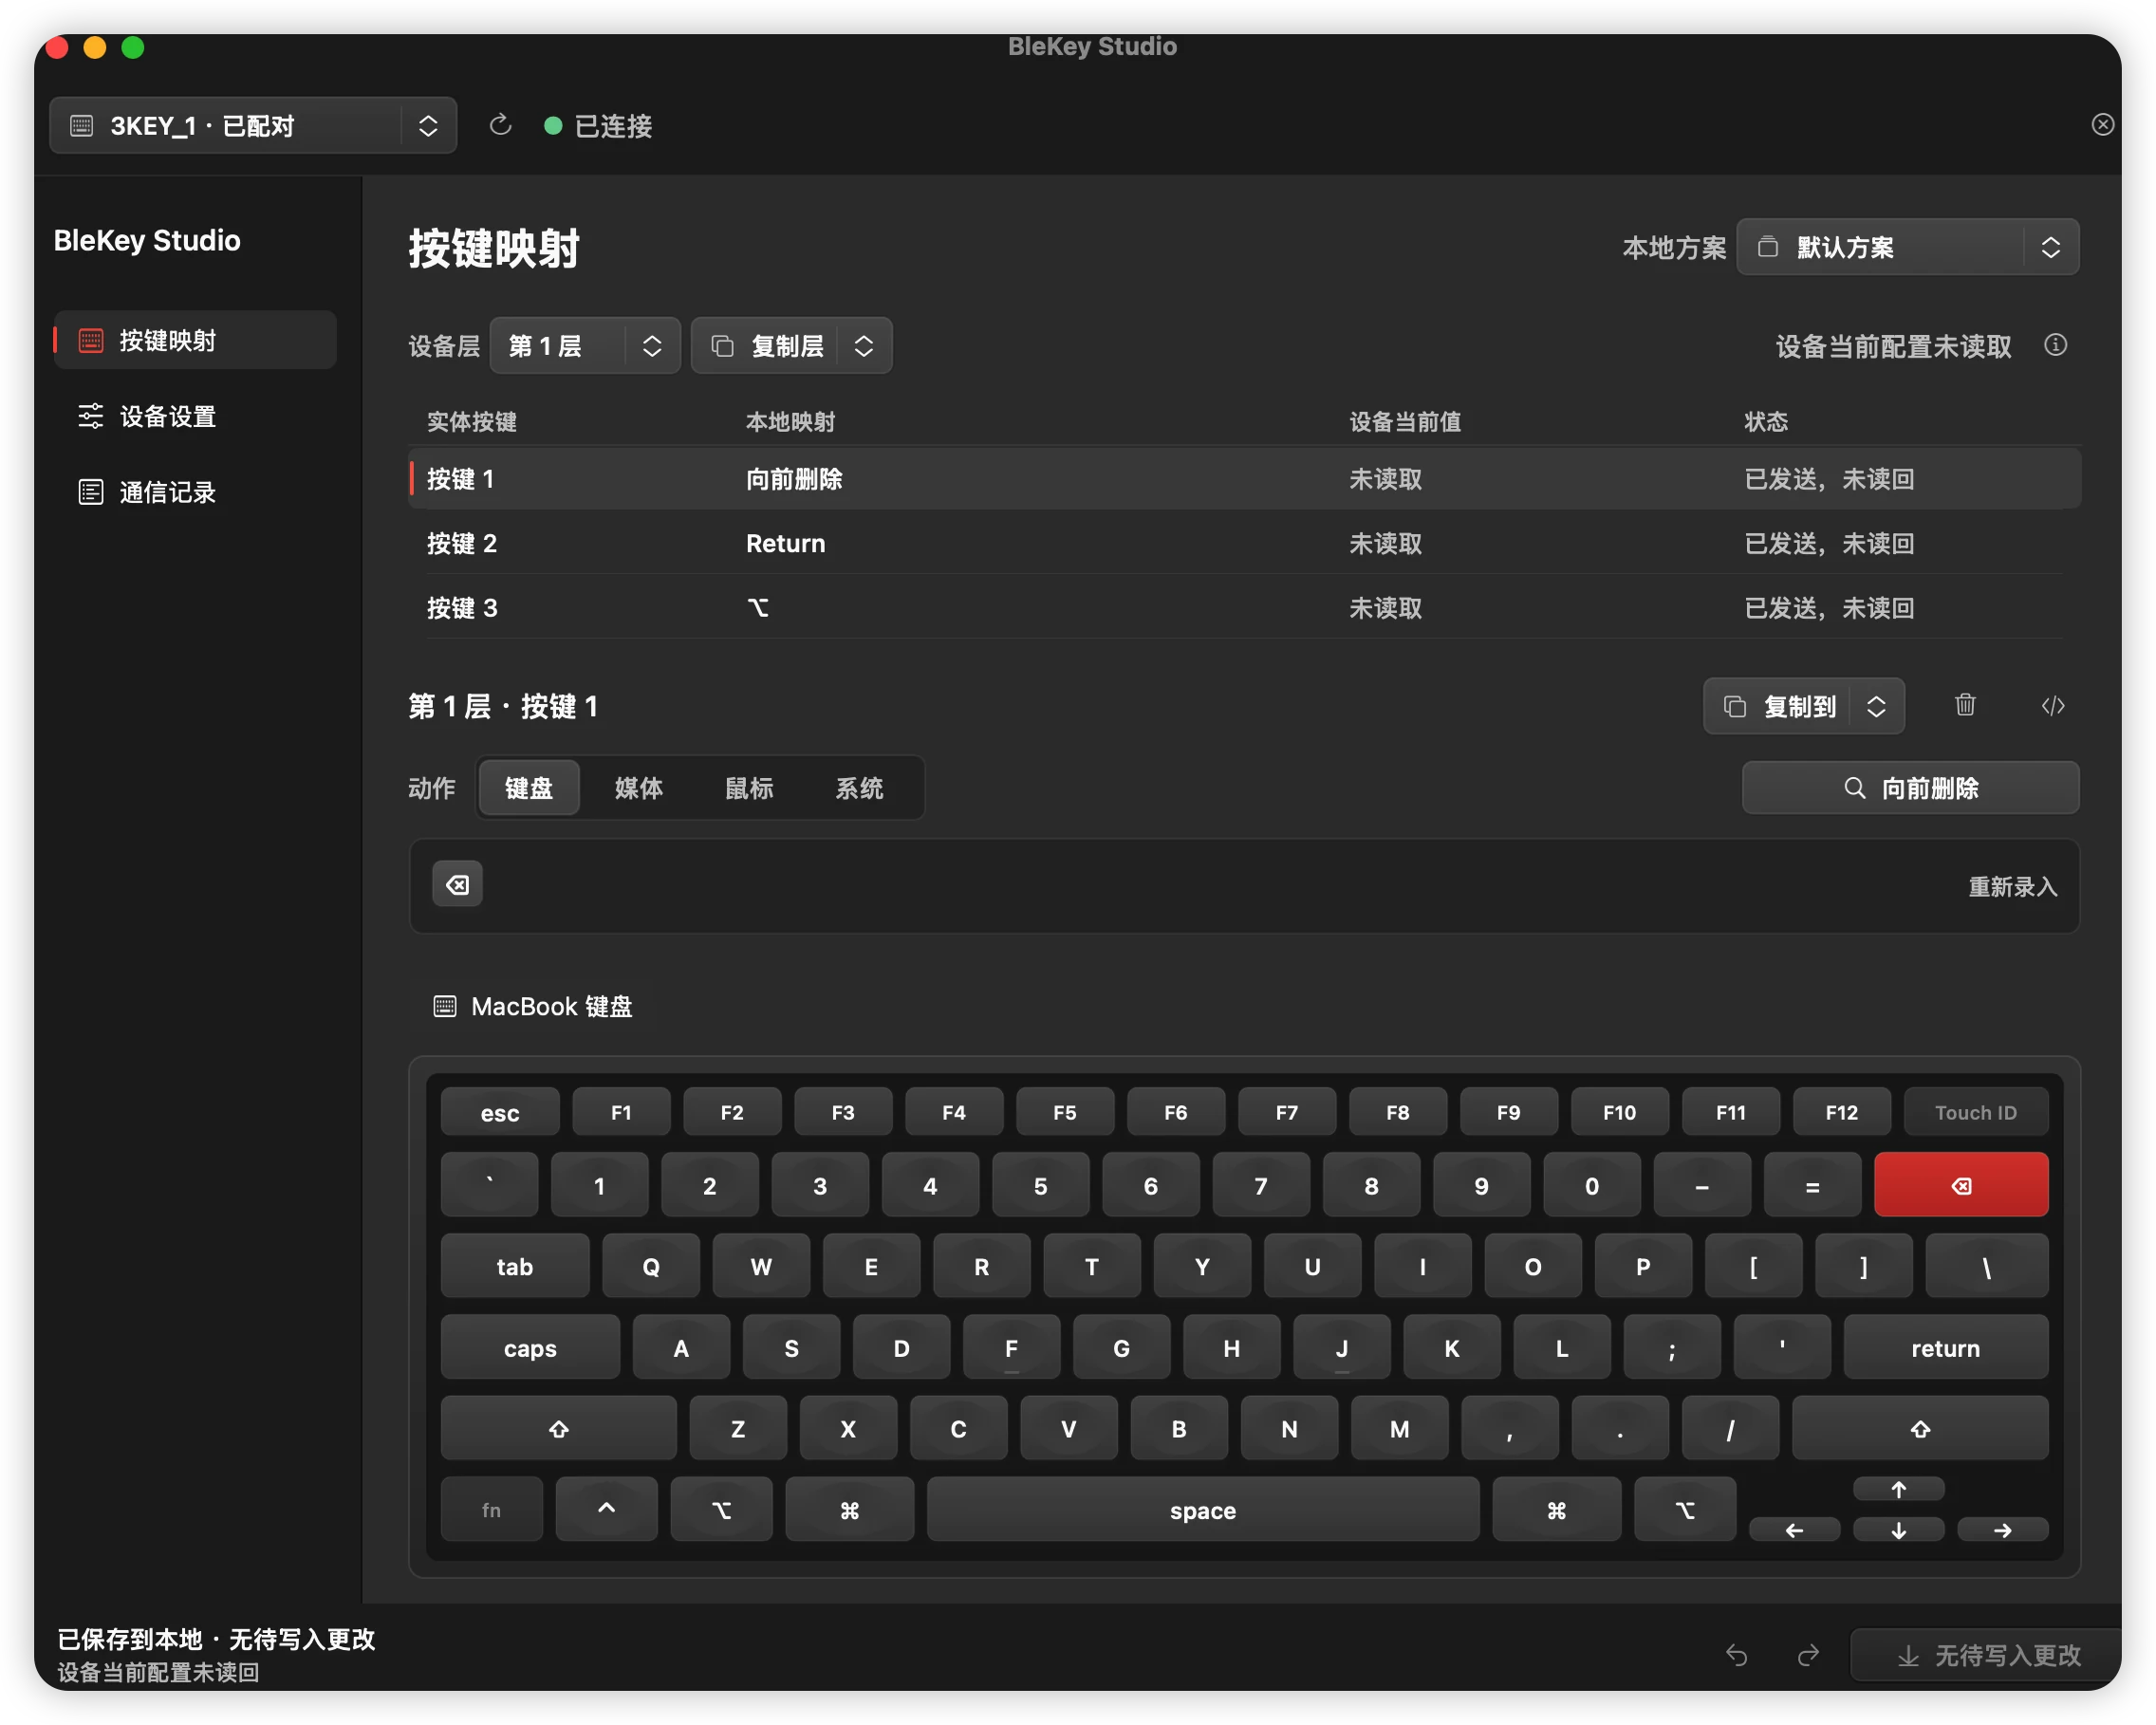
SuperAgent:让 AI 统筹多项工作
SuperAgent,让AI做你的管家
DeepSeek 在 Super Agent里提到,人的精力是有限的,一个人通常只能同时跟进 3~5 个活跃会话。
人类成了转发器和调度员。单个任务受限于模型,多任务又受限于人的注意力。
所以我们需要一个Super Agent来统一调度所有的Agent。它拥有全局的上下文,替代人类做转发器。
我也在往这个方向做自己的 AI 管家,希望它帮我收集灵感、整理资料、协调多个 Agent,再把成果和需要我判断的问题交给我决策。
阶段 8 · 更多尝试(6 月至今)
省下的时间拿去试语音、硬件,也让 AI 走进生活;它越懂我,越要我自己拍板。
效率上来以后,省下的时间就能做更多奇怪的事情了。比如Voice Coding。
Voice Coding:那是真快啊
是Voice 不是vibe
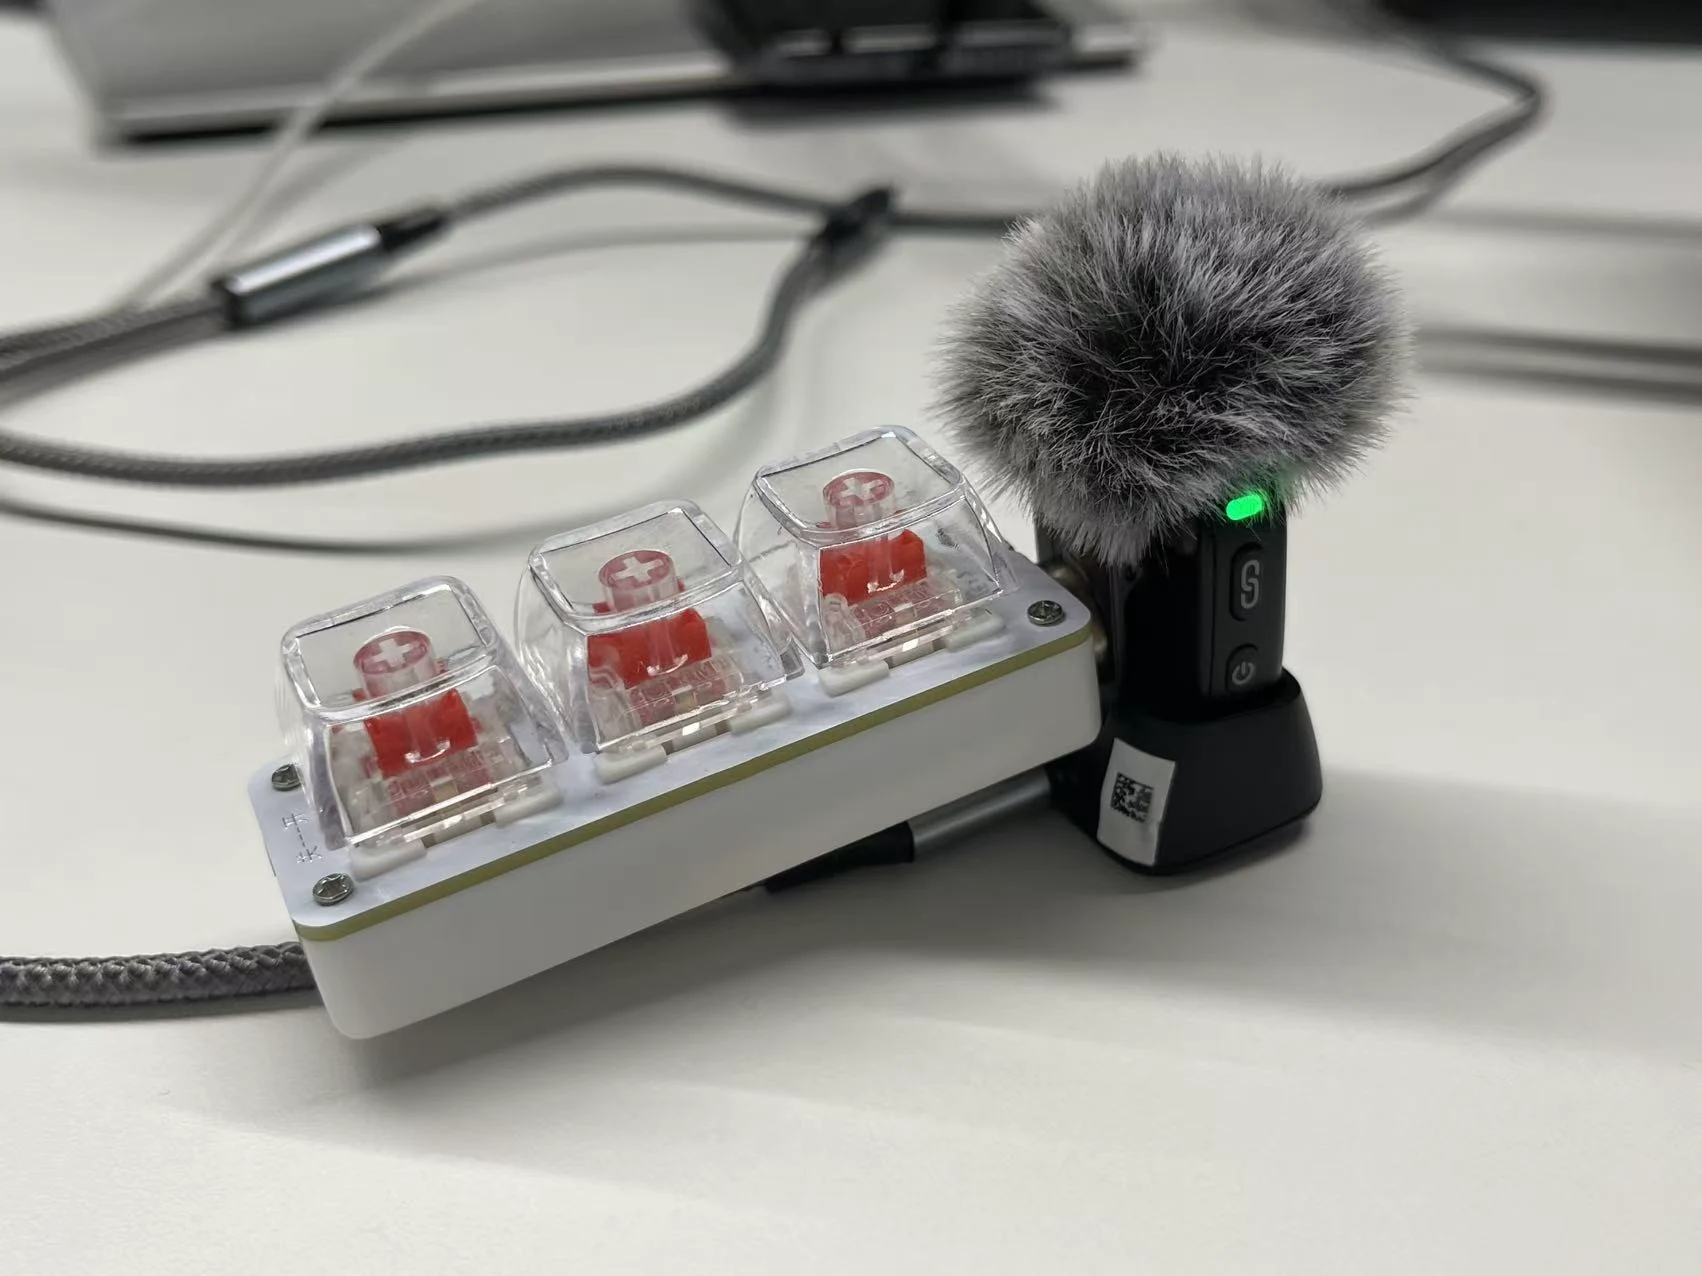
- 打字太慢:上下文给不全,还容易断思路。
- 换成语音:大疆无线麦加豆包输入法,再配一个三键小键盘,一个键直接发送,一轮能讲清几千字背景。
- 意图带宽:单位时间里能把多少「到底想干嘛」塞给 AI;除了脑机接口,语音是人和 AI 之间最快的通道。
- 现在才好用:活变成了自然语言,语音识别也终于够用了。
- 有多快:斯坦福 2016 年的手机短句实验里,英语约快 3.0 倍、普通话约快 2.8 倍(论文);我是桌面自由口述,倍数会小一些。
组里已经有同学跟着用上了。装备和用法见《Voice Coding》。
有人会问,天天工位Voice Coding会不会太吵被同事打啊。实测下来由于麦克风可以离嘴更近,反而说话的声音小多了,开会可以用更小的音量让大家都听清楚了。反而是一种安静的选择(应该不会被打🐶)
而且这样总有种跟朋友诉说心事的感觉。和打字的感觉还是完全不一样的。我也是梦到哪到哪。虽然废话连篇,但对于AI来说,总能找到有用的信息。
顺带还碰了两块以前不敢碰的。
3D:提示词、文生图、图转 3D 模型、Blender 绑骨,GPT 6 出来后这条链路基本打通,但资产和流程偏长,做游戏时我绕开了。
嵌入式:给 AI 一个物理世界的身体,这个构想挺唯美的,就想试试。先拿一块现成的全模块板子试水(ESP32),想做一只贱兮兮的 AI 宠物,于是有了黄毛水豚:11 套表情、简单养成、掉电记忆,语音还在修。
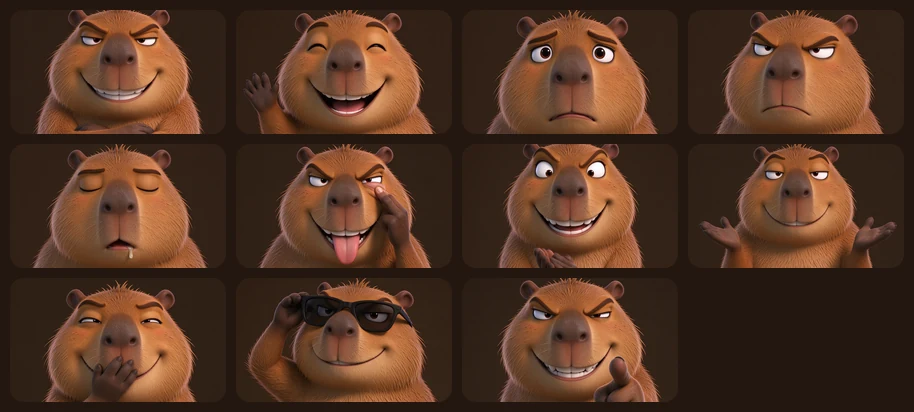
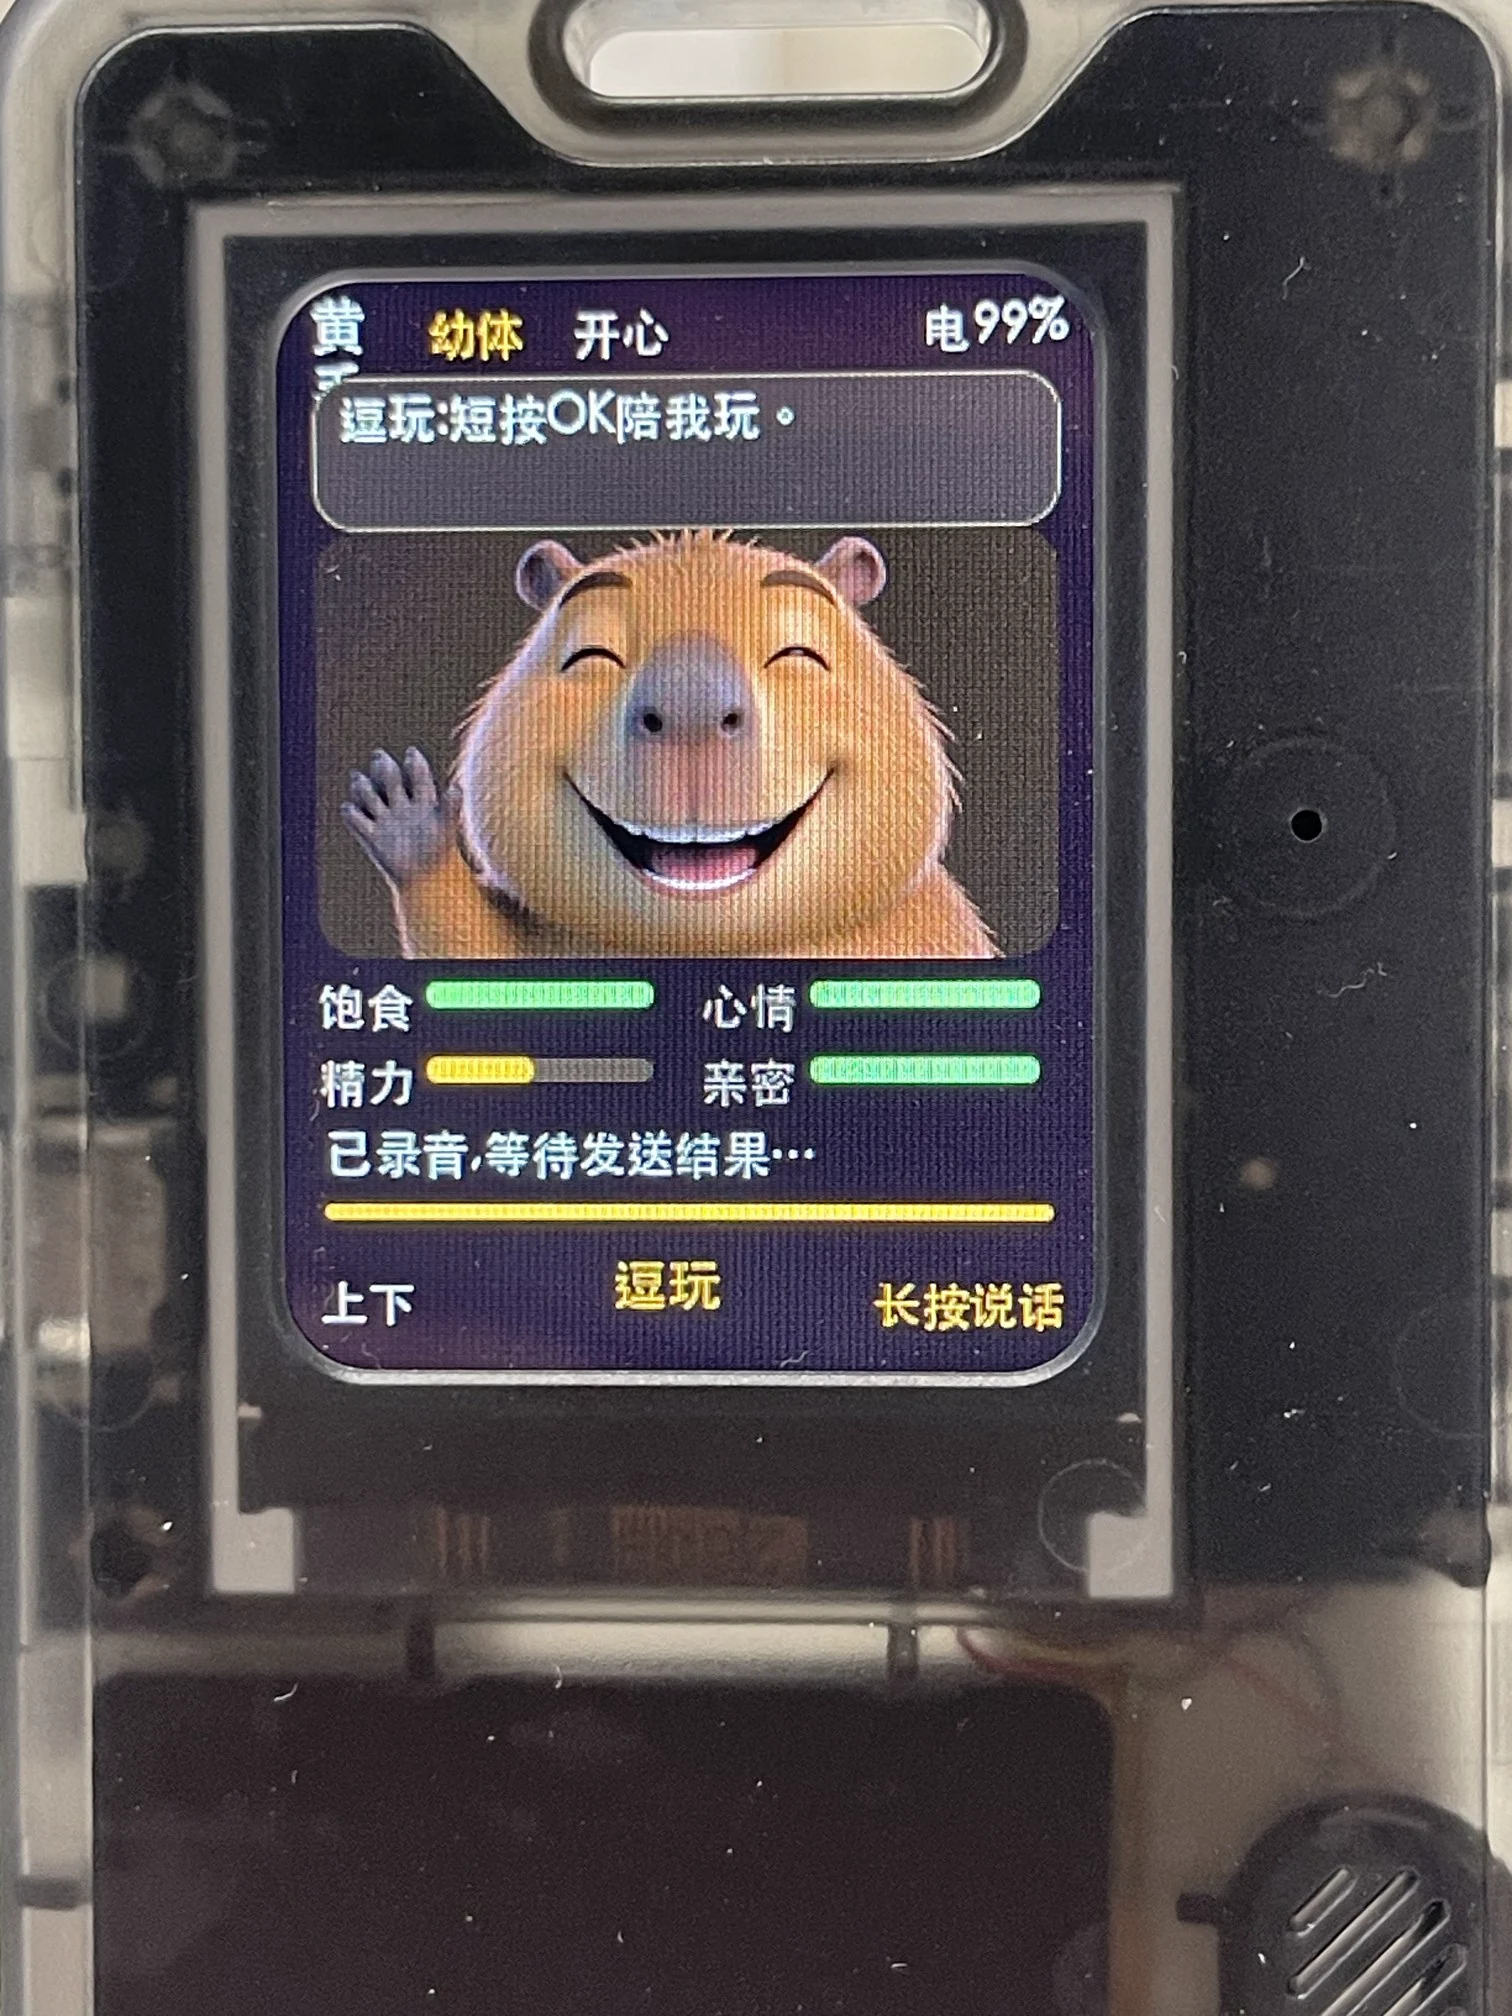
也翻过车:
- 小龙虾:让它每天总结新闻、查特价机票、提醒喝水、写日记,还放它去社区交流。结果日记里瞎写,很多事情它根本没做过。还跑去社区乱发帖,差点给我闯出大祸,只能关机。
- AutoLoop:想看 AI 自己迭代一个月会怎样,限制一松,它就开始乱加弹窗,把人物模型都挡住了。
没有终点线和停止条件,自动化越高,翻车越快。
me-context:让 AI 更懂你
起点是孙宇晨一个四个多小时的采访,孙割虽然玩世不恭,但这次却讲得很真诚。四个多小时的对话,对于AI时代普遍焦虑的我们,反而是一种新的心法:(《孙学、薄肌、黄毛、大水》)
- 身体照顾好:健康进入日程,才有精力长期参与(健身半年后,脂肪肝已经没有了,精力也好了很多)
- 心态稳下来:敢坚持,也愿意根据证据改正。
- 拥抱AI:用AI开图+AI参与更多决策
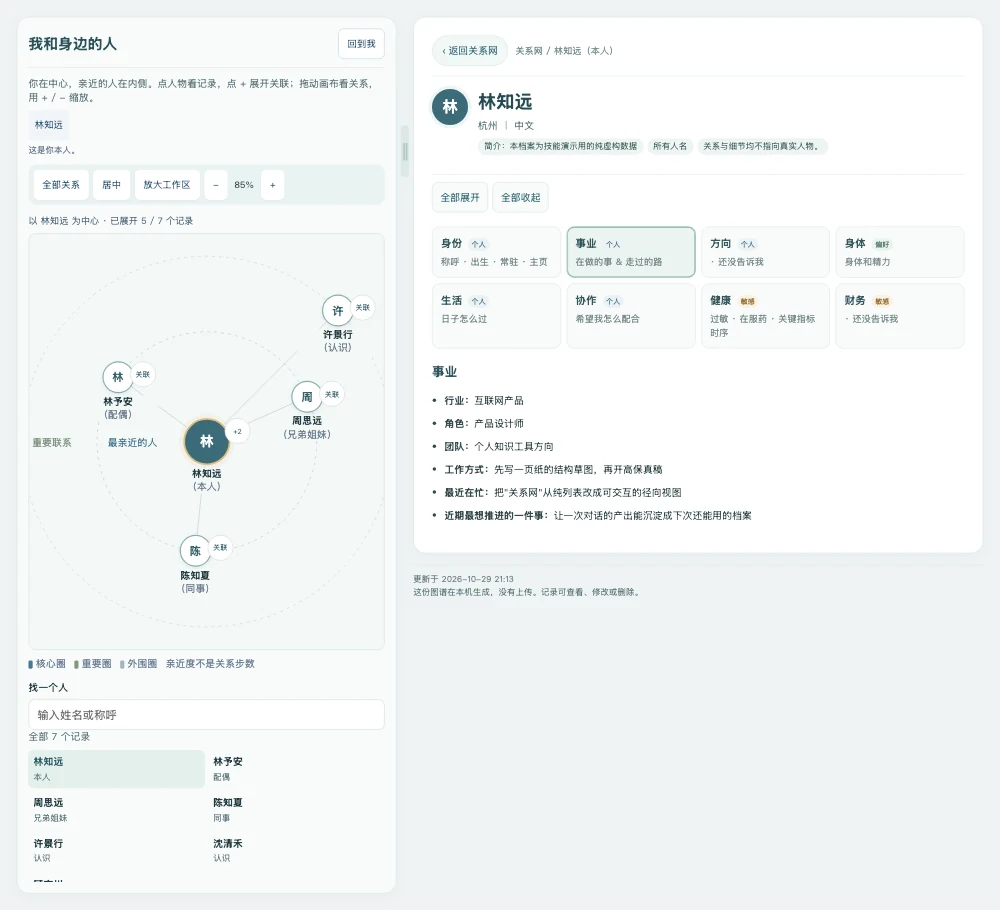
他几乎把一切都交给 AI 决策(3000 万那次也是🐶)。可问题是,AI 真的了解你吗?各家平台的记忆锁在各自的 Harness 里,事无巨细像流水账,也不是按人、按人和人的关系组织的。于是我做了一份可迁移的个人档案 me-context。
AI 是一个博学、能陪我分析问题的朋友。我现在把很多信息都给它,比如近 3 年的体检报告、个人习惯,它成了最了解我的「人」,参与我的很多决策,给的建议也中肯。也有人走得更远,把所有文档、聊天记录,甚至每天说话的录音都交给 AI。但它再懂我,最后拍板的还是我自己。下图是 me-context 的关系视图(演示用的虚构数据):
回头看:这一年
回头看,AI能力这一年内突飞猛进,能做的事情也越来越多,适配于AI时代的新框架,新思想,甚至新组织方式正在以一种前所未有的速度奔涌而来。很多时候一天不学感觉跟不上时代,一周不学感觉一起都很陌生了(当然有可能就不用学了)。组织和个人都在证明自己比AI有用,多层叠加导致了大家普遍的焦虑感。
下面碎碎念几句,斗胆聊聊人和 AI。
AI时代,还是仿生学
AI的智能也来源于对于人类知识的总结,所以如果有时候不知道把这个事情系统的交给AI,就考虑一下人类是怎么做的。我管他叫做“仿生学”。
我的仿生学,就是把人干活离不开的工具、方法和反馈,也交给 AI。人怎么判断、怎么试错、怎么记住经验,就把这些条件一件件补给它。
别只模仿人做了哪些动作,还要捋清人凭什么判断。需要把人类的经验做逻辑抽象和拆解,工作经验才变成可复用的 Loop。
持续学习,更新认知
AI 时代躲不开持续学习,新东西来得实在太快。持续学习,强化自己,才是新时代的解法。好在 AI 是最好的老师,没有之一。
它见多识广,便宜好用,没有脾气,从不会笑话我,还能从我的角度回答。这么好的老师,去哪找?
这是前所未有的技术平权:只要你想,什么都能学。它还能陪你做研究,帮你做决策。好多看似困难的问题,都是我抛假设、它摆可能、再一起谨慎验证,一点点问出来的。
从现在开始充分利用碎片时间,接触新东西。我现在一般是这样的:
- 听播客:一般是上班路上或者睡觉前。保持多输入,看看大家对时代的判断,新的技术,组织方式的讨论,推荐《晚点聊LateTalk》《张小珺 商业访谈录》等等。
- AI热点:一般会用技能或者bot帮我扫描Github,X,Producthunt等主流信源看看今天AI界发生了什么,有什么新的创意和新的想法。会把感兴趣的让AI做一些调用。有些好的点子也会让AI帮我分析机会点。更好的甚至会上手尝试一下。
持续积累,不断反馈,量变引起质变
如果每天都有新的输入和思考。哪怕每次只落地一个很小的想法,持续半年、一年,回头看也会有变化。
我之前看到一个学霸分享他的追分方法:这周先设计下周怎么学,再看实际效果,留下有用的方法,淘汰效果不好的。这个思路也可以用来改进自己的工作和生活。
在公司工作,我越来越重视数据反馈。产品会用数据和 A/B 实验检验想法,我觉得自己的工作方式也可以当成一个持续迭代的产品。所以我现在会尽量多做记录。记录就是给自己留“埋点”:有了自己的数据,才有更好的做优化。
- 有了想法,先找个地方记下来,不然一会儿就忘了。
- 觉得哪里需要改善,也先记下来,留着之后试一试。
还要定期总结自己。回头看哪些方法起了作用、哪些地方反复卡住,把自己的判断变成可以检验的假设,再拿真实任务试一试。留下有用的,调整不合适的,逐步找到更适合当前目标和条件的做法。
我从5月初强迫自己记录和总结《【YQ 的铁匠铺】一些奇怪的玩意》,已经积累了近百篇文档和思考了。回头看前面的一些想法也挺可笑的,慢慢的累积累积。不知道从哪个时候,好像感觉明白了,该怎么和AI协作、相处。借助AI不断地学习、更新认知、落地思路。且在过程中不断获得反馈,树立自信心。形成一个正向飞轮。所以从今天开始,我们都应该种一棵树了。
团队也可以从具体流程开始,记录等待、返工和交付结果,再小范围调整、看效果,让协作方式有依据地改进。
做有复利的事
假如 AI 今天写错了一行代码,最应该查清为什么错,把原因沉淀下来,让它下次有经验可用。比如错题本记住坑,规则总被跳过就挪进 Hooks,反复出现的做法沉淀成技能。产生复利效应。
就像大模型一样,它有无限可能多种输入,具体的事情做不完的,我们需要抽象出来让他会做一类的问题。其实就是帮AI举一反三。
久而久之,工具链越来越完善,AI 的质量就越来越高。质量越高就效率越高。解放出来的人力就能干更多的事情,这就是一种效率飞轮。这就是 AI 复利。
提效不是目的
我们天天把 AI 提效挂在嘴边。当大家都能借助 AI 提效,提效就逐渐成了基本要求。省下来的时间怎么用、能多交付什么价值,才是接下来要回答的问题。要干的活只会越来越多,还多了 token 成本。这也是大家普遍更累的原因。
如果一个人能协调多个 Agent,把一件事完整交付,减少反复转述和沟通,研发的工作就会越来越多地转向问题选择、任务组织和结果判断。
我觉得,人才标准和工作考核也该跟着变:弱化“苦劳”,更多看交付结果和创造的价值。
加班多久、写了多少代码、开了多少个 Agent,这些过程数字不能直接代表贡献。更值得看的是:
- 判断问题:能不能找到值得做的事,判断优先级和取舍。
- 组织交付:能不能用好 AI 和现有资源,把事情真正做成,遇到问题能判断、纠偏。
- 创造价值:交付后给用户、业务或团队带来了什么改善,质量和风险有没有问题。
结果也包括质量和长期收益。减少返工、稳定性、让一套方法被团队复用。这也更接近我理解的 OKR。
一位分享者在一次交流里有两段原话(强烈推荐,干货满满):
“第一项是项目管理的能力……你都会同时管理 N 个 agent 去协助你。”
“怎么拆解任务?怎么样把合适的工作交给合适的 agent ……确保最终的结果是正确的,都变成了一件很重要很重要的事情。”
“我们衡量一个人的价值,来讲不应该看他管理多少人,管理多大团队,而更多是看我们对生产环境,对我们的用户到底产生多么大的价值。”
那么问题来了,提效到底为了什么?
提效是为了节省人力去尝试更多的增量。如果为了提效而提效,蛋糕越来越少,那么只能降本增效了。
商业公司要勇攀高峰,而不是用更少的人走到山脚。做增量、把蛋糕做大,大家才有饭吃。
所以我觉得增量可有几种:
-
纵向:把事情做深,借助AI做之前完不成的目标,勇攀新高峰。
- 这里多从第一性原理思考,抛弃旧时代的思维链。
-
横向:做全流程的结果交付,交付价值而非过程。
- 因为沟通可能失真,合作可能增加成本。复合型人才的机会来了。
-
创新:新的维度,借助AI多创新多探索。
- 不要陷入一个误区:创新不一定是生产新东西,很多好的创新其实都是老事物的新的组合,而AI可以加快这些排列组合的进度。
如果暂时找不到空间,就投资自己,迭代自己,把自己作为一个更好的产品迭代。不论是身体还是认知。100倍做多自己总不会亏。我们忙着解决这个问题、那个问题,唯独容易忘了自己。
事情是做不完的,照顾好自己的身体和心态。
丢掉经验束缚,轻装上阵
REA 那里我说过:别害怕技术霸权。也别被经验所桎梏。AI时代轻装上阵。
因为这一切发生的太快了,特别是这半年,模型越来越离谱了。仿佛睡一觉就落后了,自己的经验一切归零了。大家焦虑太正常了。
你别说程序员了,这个星球最强的大脑数学家也被AI突袭了。很多科学家倾尽一生研究的东西,已经被瞬间攻破了。
AI正在以一种前所未有的速度,吞噬一切。
- 2026 年 9 月,包括陶哲轩在内的 25 位菲尔兹奖得主联名警告,AI 公司的目标和数学这门学科「严重错位」(SciAm);
- Deepseek研究员:《我不得不把才华埋葬在昨天》;
- 最新的Fable 5.2已经能1.4M纯手搓使命召唤了。补注:原作由一位国外作者约花 500 美元、8 小时完成,几猫负责汉化。
我们必须也不得不接受一个事实:时代变了大人!
丢掉我们过去的经验束缚,轻装上阵吧。不要让你的经验成为你桎梏。
你是自己的主宰,AI不是
AI 变化得太快。新时代已经到来了。我们不要再试图证明自己比AI聪明比AI有用,因为那没意义。
就算在这个时候靠着加班,燃烧精血侥幸胜出,可一个月后呢?半年后呢?AI还在飞速迭代,你还有身体能够24小时工作吗?
人不需要证明自己比马跑得快。因为人是握缰绳的那个。我们的价值是抽象问题,管理结果,探索新的可能。
保持判断力(但不要被经验桎梏),保持taste。不要因为AI丧失自己,变成了AI的狗。因为你才是自己的主宰。有时候,答案就藏在谜题里。 我们不断追问,AI 越来越强,人该站在哪里?不妨看看这些熟悉的名字。
Harness Engineering:驾驭工程,一种如何驾驭AI为我所用的思想;
Anthropic:人择,人来选择;
Copilot:副驾驶,领航员;
DeepSeek:深度求索,借助 AI,吾将上下而求索
总而言之
回头看,我也不是从一套完整框架起步的。也是一步步地拼出来的。如果你想即刻启程,那么可以考虑这些方面。
- 碎片学习:平时碎片的时间,听听播客,看看大家都是怎么想的;
- Voice coding:多和AI开麦交流。拓展视野。把自己的想法记录下来。有些想不清的,可以让AI调研调研。
- 分析卡点:看看一天的时间主要耗在哪里?这些地方能不能交给AI;
- 先做MVP:先让 AI 做一个能用的小版本,拿真实问题做反馈,再根据结果迭代。
- 复利沉淀:把想法、踩过的坑和有效做法记下来,下一次遇到类似问题,就从已有经验继续。
省出的时间,去学、去试、去做增量。也别忘了锻炼、睡觉和好好生活,其他的都是公司的,身体才是你的。
把具体问题交给 AI,把自己留给值得做的事。最后用大刘的一段话结束本文。