好好说话评测台:语言好坏为什么不能只交给分数
一段中文改完更顺,不代表改对了。原文的条件可能被删,术语可能换了意思,也可能多出作者没有说过的承诺。只问“哪版更像人写的”,容易把这些问题放过去。
好好说话评测先对着原文判断有没有改坏,再看表达是否改好。它既能比较一次改稿,也把反复出现的问题整理成改进写作规则的依据。
评测对象
评测比较的是原文与改稿的含义和表达,不是两版文字谁更有文采。先检查事实和用途,再检查语言。
| 结果 | 具体问题 | 说明方式 |
|---|---|---|
| 改坏了 | 丢条件、多承诺、换术语、改变程度或用途 | 对照原句与改句,指出哪条含义变了 |
| 没改好 | 病句仍在、新添别扭表达,或没毛病也改 | 引用具体文字,解释问题,不只写“不自然” |
| 合格或不确定 | 未发现上述问题,或原句有真实歧义 | 允许没问题;有歧义就说明争议,不硬排高低 |
早期统一分在五十条历史材料中,给原样不改的“改写”平均94.5分,二十七条排第一。这个反例说明:没命中正则、没改动文字,并不能量出语言质量,所以总分不再作为裁决。
逐句对照
沿用原有的感谢信示例:“感谢您的来信”被改成“收到”。两句都短,区别在于原句承担了感谢和礼貌,改句只剩接收信息。
| 检查 | 在这个例子中怎么看 |
|---|---|
| 原文用途 | 这是感谢信,礼貌表达服务于文体,不是随便多写的客套 |
| 含义变化 | “感谢”被删除。若它承担必要礼貌,改后文体受损 |
| 问题记录 | 保留两句原文与理由,归入删功能性信息;不只记“短版不好” |
这是一项讲解示例,不是当日评测结果。同样一句客套放在私人聊天里,可能不需要保留;评测必须先认清用途,不能看到某个句式就一律判错。
各版先去掉来源、打乱顺序,再分别对着原文判断。这样比较不会因知道哪版出自当前技能而偏袒,也不会把某种个人文风当成合格标准。
规则改进
一次差错只够留下判例,还不能变成所有文章的新规则。继续沿感谢信这个例子看:要改的应是“误删承担礼貌的表达”,不是“所有客套永远保留”。
- 归并同类问题:看不同题中是否反复删掉必要礼貌,区分偶发改坏和稳定缺口。
- 提出有限修法:限定文体和触发条件,只改这类问题,不给所有场合加同一禁令。
- 用新题比较:现用版与候选处理同一批未用于写规则的题,再匿名对原文核对。
- 检查误伤:感谢信改善之外,还看私人聊天和干净稿是否被保留了多余话,不能只验证有利例子。
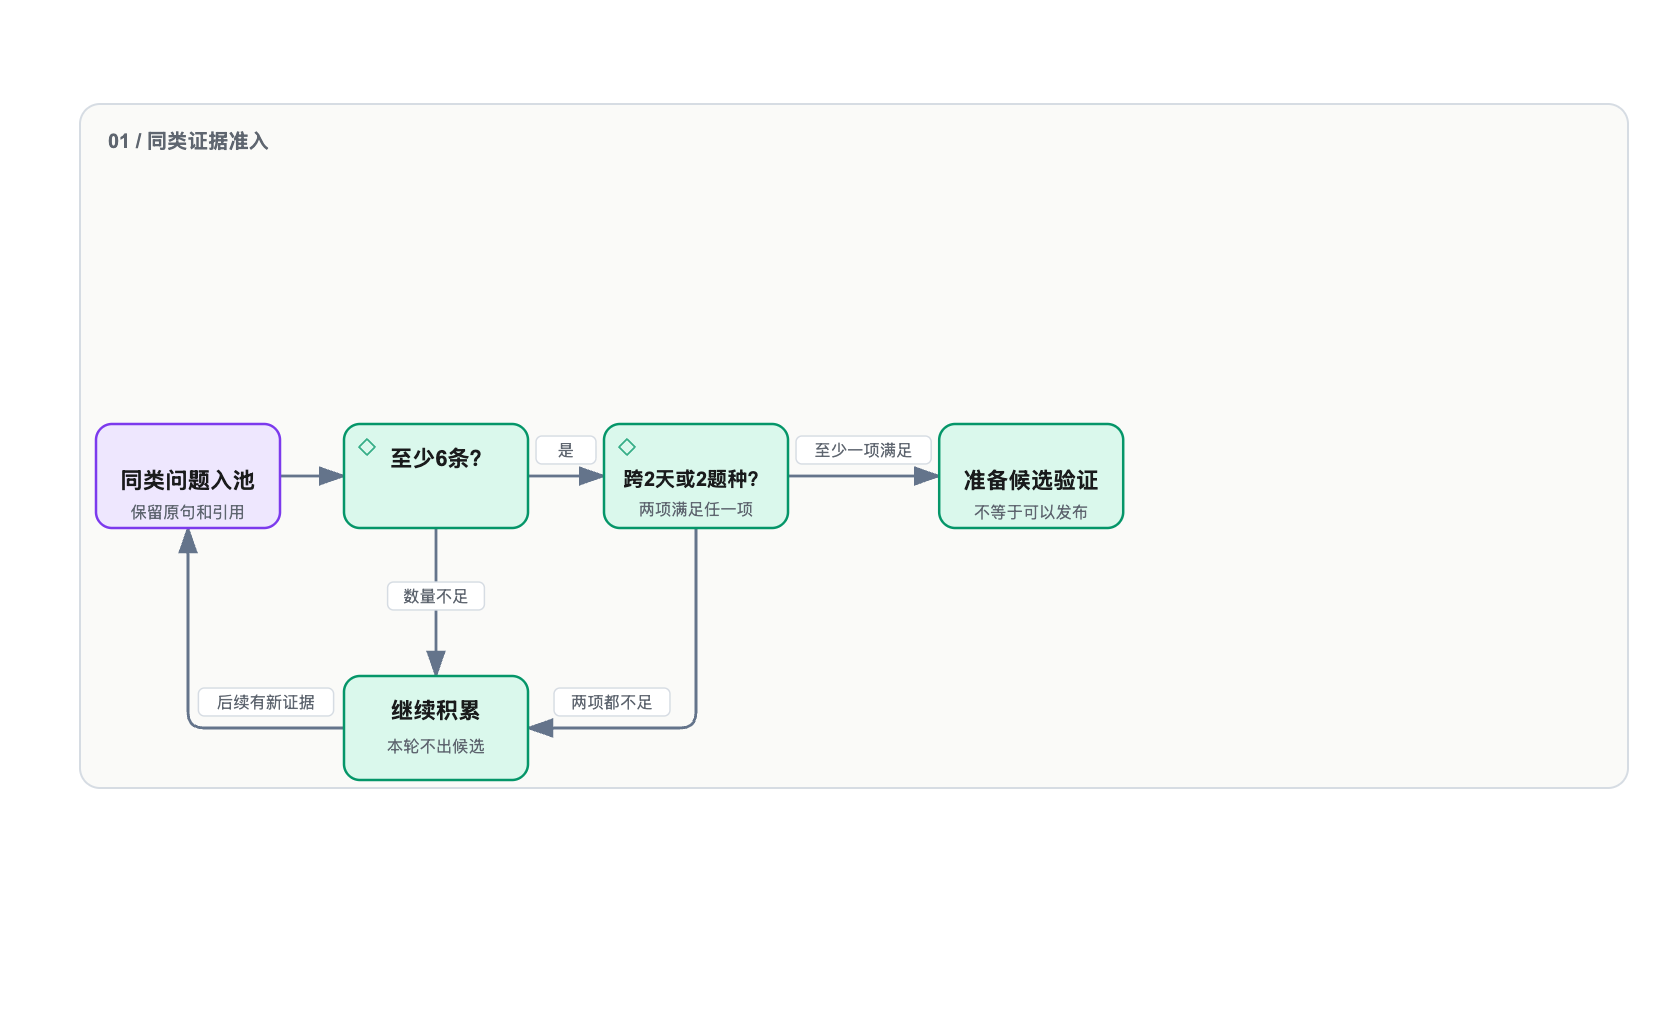
证据达到数量与分布要求,才准备候选验证。下图把这个条件展开:至少六条,并且来自至少两天或两种题;后两项满足任一项即可。
验证与发布
候选在一批题上过关,也可能只是适应了这些题。当天先预发布,次日再用新题复测;发布后保留观察和预定回滚条件。
- 固定比较条件:评测期间不修改候选、版本和判断标准,不重试到过为止。
- 保护现用规则:事实变差、出现新错误,不能靠句子更顺来抵消。
- 限制改动范围:自动流程只更新每日细则,不改底线、稳定判据和个人风格。
小样本比较可以提供改进线索,不能证明一套语言规则普遍更好。人的批改原样留作判例,仍要经过同类积累和新题检查,不能一句偏好就直接发布。
使用与交付
手动比较时,给原文和各份改稿,例如“逐份对照原文,看哪里改了意思、哪里还没改好”。拿到的是可逐条核对的问题清单,不改现用规则。
- 日常记录:留下题目、引用、候选和版本,便于复查为什么更新、为什么没更新。
- 材料来源:只取明确提供的来源,不自动搜私人文档。
- 不用的材料:个人信息、财务和公司敏感内容不纳入评测,即使被提供,也不作为题目使用。
实践总结解释了保真优先的取舍。判断这套评测有没有用,要看它是否能抓到具体失真、是否减少同类错误,而不是产生了多少分数和规则。