产品需求与计划:验收怎么写,才不算糊弄人
很多 PRD 的验收写着「用户体验流畅」「系统运行稳定」,这种话写了等于没写。这个技能的大半规矩,来自一轮 A/B 盲评的失分沉淀。
什么时候喊它:手头有一句需求、一份访谈或附件、一张机会评分卡,要整理成 PRD 和执行计划,或者评审前发现验收写不下去、要补里程碑和估算时,就用它。独立使用不要求先跑雷达或评分卡;已经有上游评分卡就接着用。
相邻技能分工:机会雷达负责发现候选,scorecard 判断潜力,这里不重复打分;界面结构和视觉交给 style-compass;技术取舍、系统集成和合规方案交给 engineering-docs,交接条件见下面边界段;下一步做什么由用户决定,本技能不自动开新会话、不替用户排期审批。
从旅程确定最小范围
让 AI 直接写功能清单,常说不清用户要完成什么。这里先提取人群、场景、障碍、替代做法和已有决定,分开事实、用户确认与假设,再沿旅程确定最小范围。
继续用下文个人记录工具的构造情境:如果目标是让用户留下记录并回看,先保留证明这条旅程所需的 F1、F2,个性化周报作为待验证扩展。它是否有价值要另验,不能因为 AI 能写出来就进入最小版本。用户已定 Web 就沿用,不擅自换平台。
两份交付共用一条验收链
每个 F 标识记录触发条件、输入规则、预期结果和验收。这样「支持记录」才能进一步问:必填信息是什么,无效输入如何处理,合法输入之后用户能看到什么。材料没定的规则列为未决或明确建议,不能冒充用户确认。
- PRD 固定问题、人群、旅程、功能与验收、平台取舍和未决项;它定义要交付的范围。
- 执行计划沿用同一主题和 F 标识,写里程碑、依赖、估算区间与置信度、验收责任和回退范围;它定义如何推进与怎样收口。
计划按 F 回查 PRD,防止范围外功能混入。周期没依据就标待估,两份仍待人审,不构成开工授权。
验收样例和用户受益分开
- 盲评时新版 PRD 在验收写法上吃了亏,回来后把验收按可靠度分了档:第一档是可注入、可回放的系统行为用例,必须带频次上下限。
- 这组样例口径是注入 50 个应触发用例要全部通过、20 个应抑制事件要 0 触发,误触发不超过每设备每天 3 次。
- 要说明白,这是盲评后定下的验收样例,不是生产环境的全量实测覆盖。
- 用户行为指标降为第二档;
- 「日志留存完整率等于 100%」这类自证型内部指标立成了反例,它只证明系统记了账,证明不了用户受益。
功能编号也挨了扣分:新版从 F1 跳到 F3、F5 没有任何说明,评审不知道是漏写还是跳号。现在规矩写进模板:编号必须连续,断号就地说明原因,说不清就按漏号处理。
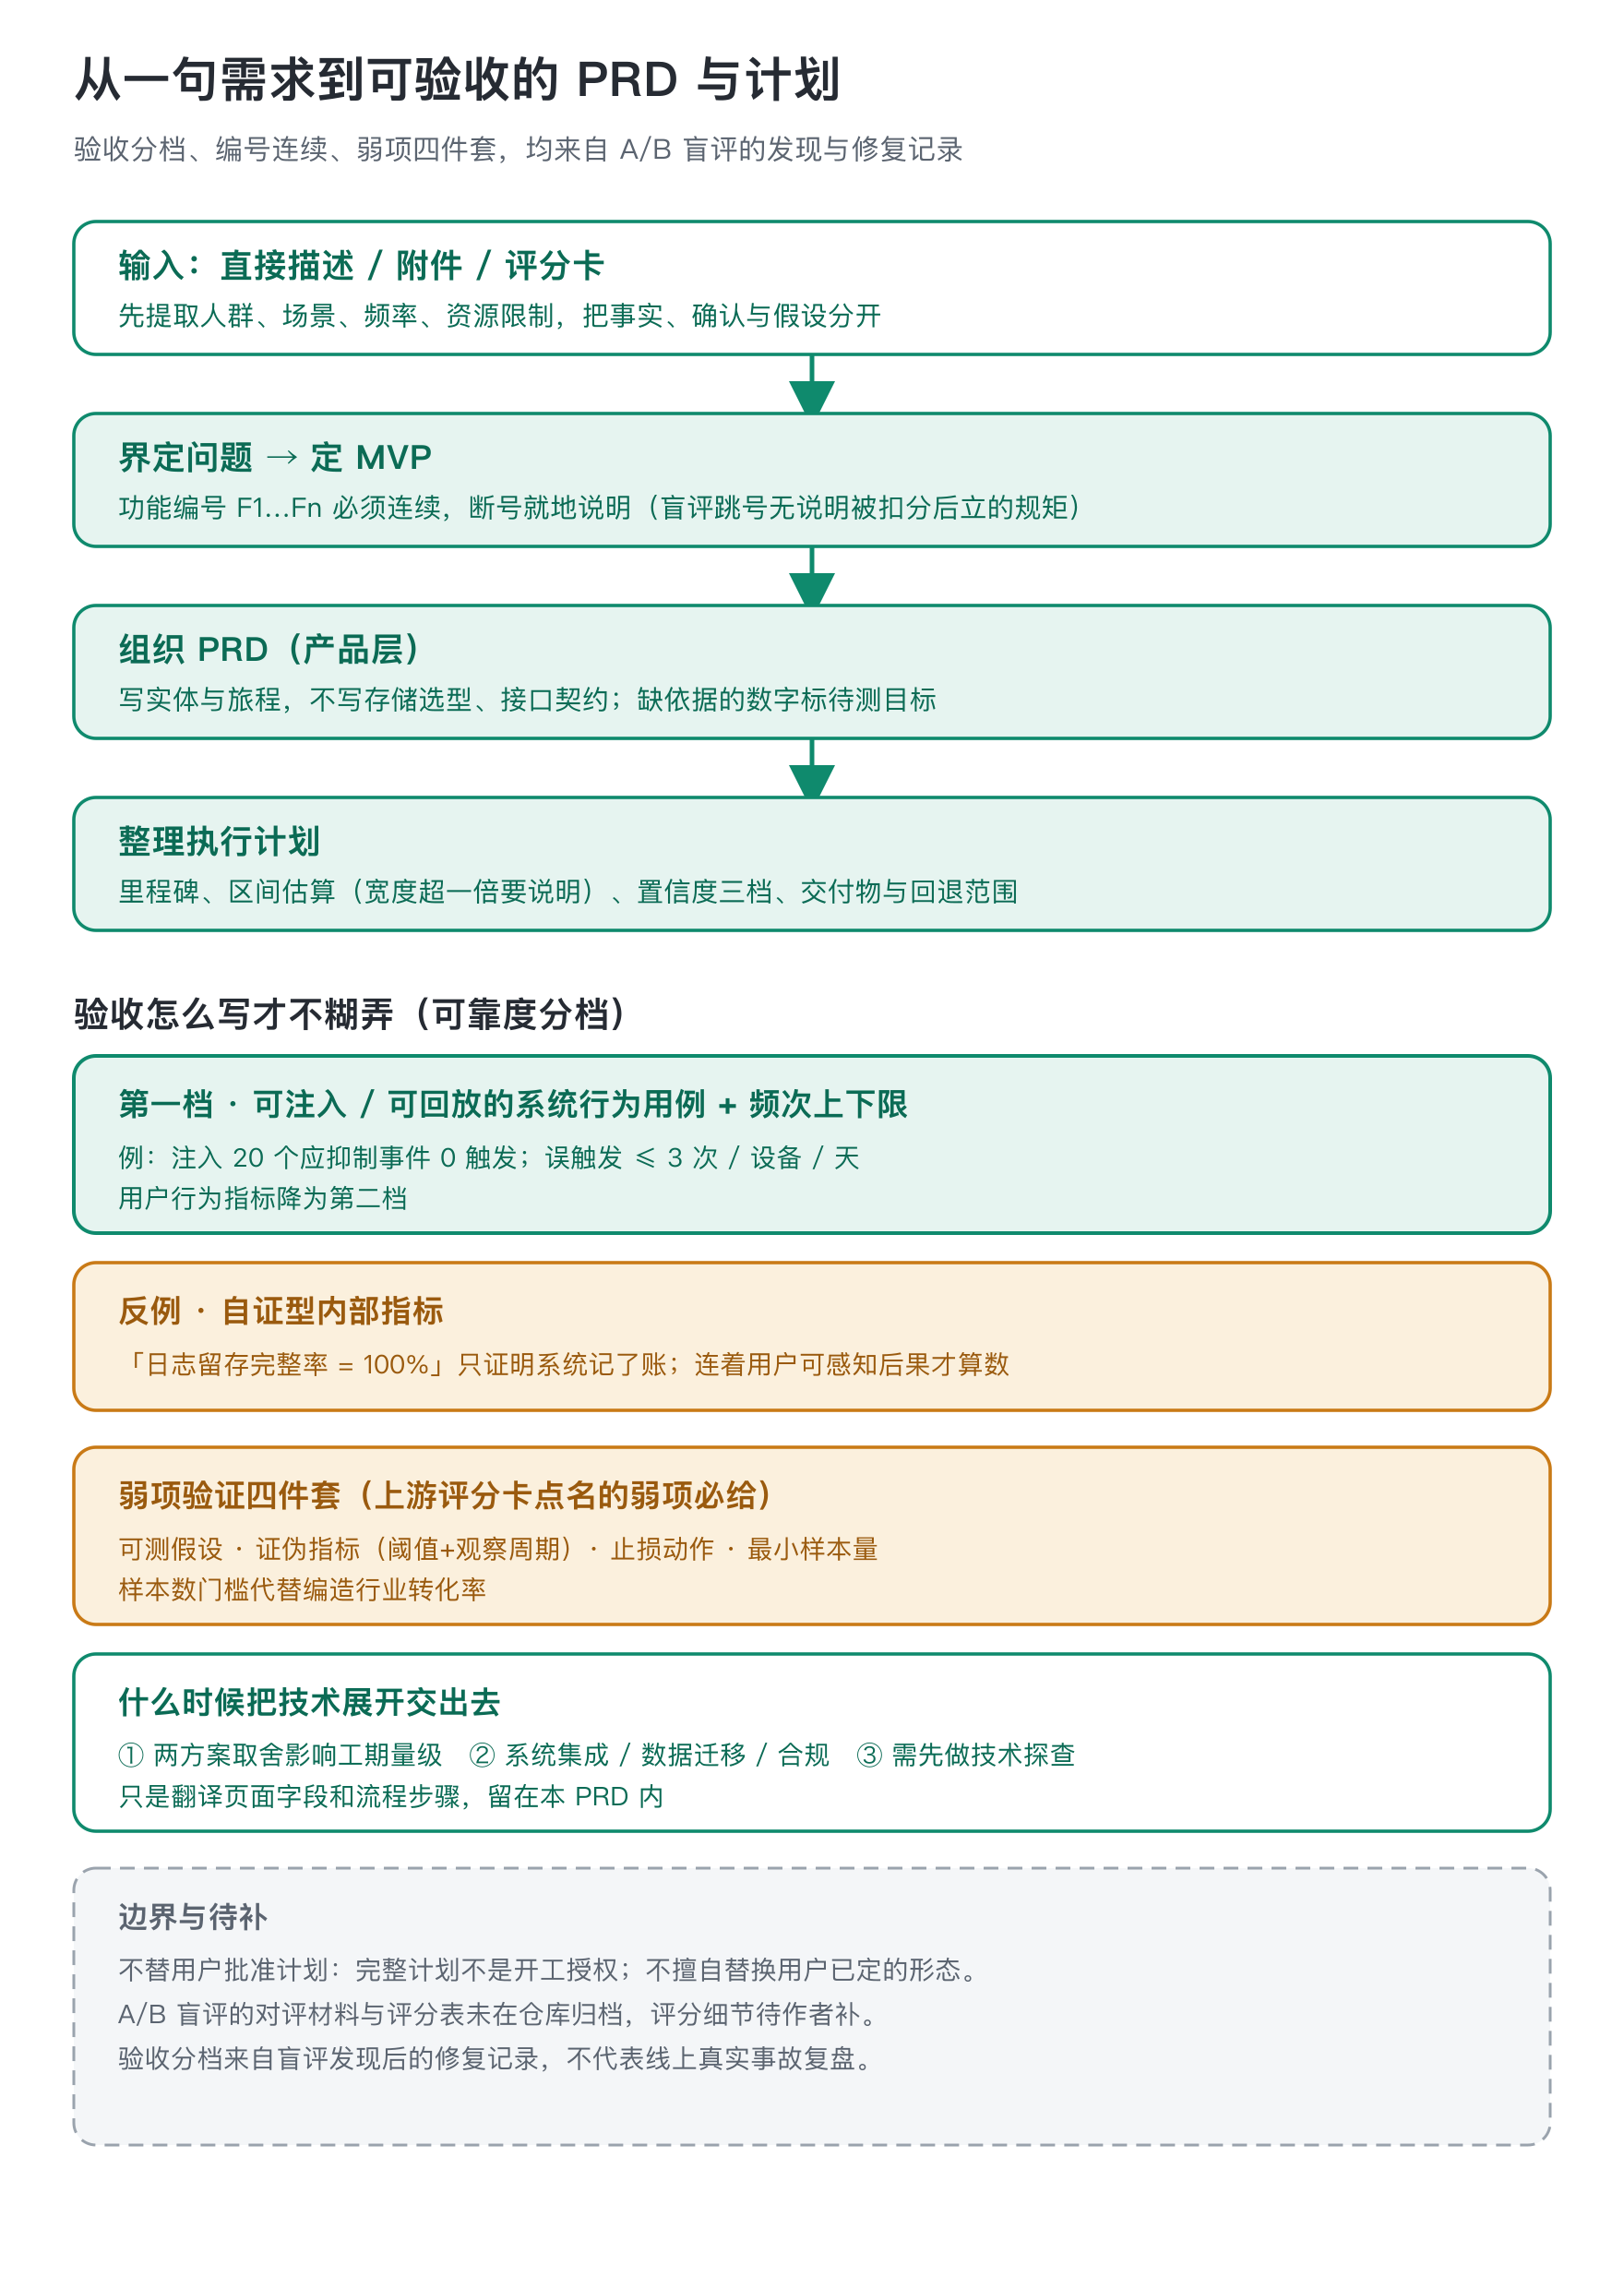
能回放的系统行为证明产品按约定触发、抑制或响应;用户行为指标才回答人是否受益。前者更容易定位失败,后者仍不可省。「日志记全」若不连着用户可感知后果,无法独立证明需求完成。
计划还要把上游弱项转成一次能判错的验证。下文护城河 5/10 的构造例,不能只写「加强个性化」,必须落实四件事:
- 可测假设:个人语境和回看是否产生通用产品难替代的价值。
- 证伪指标与观察周期:什么结果允许继续,什么结果推翻假设。
- 止损动作:证伪后退回什么产品形态,保留哪些 F,哪些投入停止。
- 最小样本量:用样本数门槛界定能否判读,不编行业转化率。
这四项让弱点从评语变成计划里的依赖和回退条件。估算也要交依据:区间必须有宽度,超过一倍说明原因;低置信度写清如何提高。需要技术探查才能估时,先交工程方案,不用无依据的小数填满排期。
下面这份是构造出来的演示,数字不代表行业真实基准,只看四件套填到什么密度。假设上游评分卡给护城河 5/10,判断这个产品容易被通用聊天壳吞掉:
- 可测假设:护城河是用户在 app 里积累的个人语境词表和周期-情绪回看,通用产品抄不走这份个人数据。
- 证伪指标:个性化周报打开率,连续 4 周 ≥ 35% 算成立,< 15% 算证伪;这两个阈值是演示设定,不是行业基准。
- 止损动作:证伪后砍掉个性化回看,退回轻量记录工具形态,只留核心记录 F1、F2,不投流。
- 最小样本量:落地页 4 周内 ≥ 100 个目标访客、≥ 30 个邮箱订阅才够判;不够就延长观察,不编转化率。
对照没有证明产品值得做
- 这套规矩过过对照实验:早期用同一宿主做过 6 个无技能或启用技能对照。
- 4 个开发案例,无技能均分 19.625,初版 19.875,定向修正后 20.000;
- 2 个留出案例三组全部打平 20.000。
- 这组分数说明两件事:规则能补上明确缺口,但在强模型本来就写得完整的任务上,不会稳定产生可见增益;
- 而且评测以模拟任务为主、分数接近上限,并没有证明按这套流程写出的产品本身值得做。
- 它和那轮验收写法盲评是两回事,盲评改的是验收怎么写,这里量的是整套技能有没有用。
- 填好的弱项四件套长什么样,见 templates/plan.md 里「护城河 5/10」那份完整示例,假设、证伪指标、止损动作、最小样本量都填好了,写计划时照那个密度写。
边界也划清楚:PRD 只写到产品层,出现技术取舍影响工期量级、涉及系统间集成或合规、不先做技术探查就算不出工期这三种情况,才把技术展开交出去。这个技能不替用户批准计划,完整计划写完是待人审状态。
- 材料不够时不硬凑。
- 缺输入先把能独立推进的部分写完,只追问会改变实现范围的关键歧义;
- 已经明确的规则写进验收,缺依据的列成未决项或给出建议,不替用户拍板。
- 收益、周期、流量没有出处就标待测目标;
- 工期写不出依据时注明「待技术方案后估算」,不用一个模糊小数假装精确;
- 样本量没有出处宁可标待测,不编行业转化率。
- 正文结构过不了校验、缺章节时回到模板补齐,不假装完成;
- 校验通过只说明结构合规,不代表范围合理,也不代表已经批准。
- 示例和演示数字不冒充真实调研、真实工期或用户确认;
- 缺外部资料时不伪造行业共识,也不因此阻塞本地成文。
版本口径有三处对不上也记在这里:SKILL.md 自称 0.3.1,handoff.md 写本轮版本 0.3.0,CHANGELOG 最新条目是 0.3.2,以 CHANGELOG 为准,待作者统一。那轮验收写法盲评的对评材料和评分表没有归档,具体评分细节待作者补。