兼听(outside-view)来路:写不出「什么新证据会改变行动」就不要搜
选技术或定大型计划,直接问 AI 容易沿当前倾向给理由;无差别搜索则会堆出很多观点,仍不知道哪些能改变决定。兼听先判断缺的是什么,再组织取证和裁决。底层搜索、RAG、知识库拿回材料,它决定找哪类、信多少、何时停。
它来自产品链的取证一环,最早在个人工作目录里先导,9 月 27 日随 curated product workflow skills 导入本仓。
入口先问现有输入、官方原文、代码、日志或历史数据,能否同时支持取舍和准备推荐的方案。只能否定旧方案,却没证据支持新方案,还不算够。若能写出一个会改变行动的未知项,再比较错误代价与检索噪声;写不出,就不搜。
三档路由,裁决只给四种
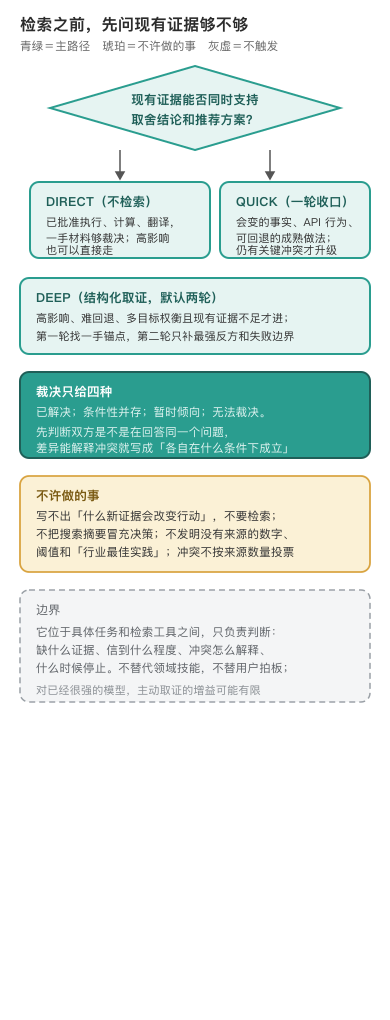
检索预算随缺口走,不随任务声势走:
- DIRECT 用已有材料、计算或现场验证;高影响也可直接判断,但否定工期估算的六个历史项目,未必还能支持替代排期。
- QUICK 针对会变的价格、版本、规范做一轮一手核验;只有来源不完整或实质疑点才加独立来源。
- DEEP 在高影响、难回退且现有证据不足时默认两轮:先找一手锚点与可比案例,再只补最强反方、失败边界和关键缺口。明确调研也可进入这一档。
找到矛盾,先对对象、版本、场景、指标和基线;差异解释得通,就写各自成立条件。真的互斥,再比较直接性、可复查性与独立性。十篇转载同一原文只算一份;官方承诺也只能证明官方口径,不能证明实际效果。
裁决仍只有已解决、条件性并存、暂时倾向、无法裁决四种。已足以支持行动、只是重复上游,或只能靠私有数据、实验、专家解决时就停;停止检索允许暂缓判断。
迁移决定怎样接回证据
沿用五人团队三个月全面迁微服务的构造例。输入是迁移决定、暂缓全量的倾向,以及单体运行三年、本月无事故的已给情境。它们说明现状,却不足以证明渐进迁移更好。会翻盘的未知是:高度可比小团队的实际交付周期、回退和故障成本如何。
第一轮找官方迁移指南与团队亲历复盘,第二轮找失败样本;按人数、系统规模和迁移范围比较,不能只数成功案例。如果新增博客都转引同一来源,就停止。
这里没有实际外部检索,不能宣布「三个月全量不可行」。交付应写成条件规则:可比实证支持且资源满足时再考虑推进;否则暂缓全量,渐进试点也先补依据。给出待验证项和原始来源位置,才算把资料接回行动。
边界是诚实写出来的
这个技能没有版本演化记录,导入时就是 0.1.0。它适合的是技术选型、大型计划、高影响或难回退决策;纯执行、已有直接证据和简单问题不触发。高风险冲突无法裁决时,它明确说该转向本地实验、专家或可回退试点,不用更多低质量网页填满上下文。
它不管已经批准的执行任务;数学计算、忠实摘要、翻译改写;本地代码日志能直接回答的问题。
- 它的真实增益边界作者有一句直说:对已经很强的模型,主动取证的提升可能有限。
- 这句不是对照实验测出来的。
- 先导期它从一份 19 KB 的长协议瘦到 7.6 KB 薄版,唯一可核理由是试测里长协议在十五个路由用例上平均计划检索八次,薄版降到五次;
- 同期跑过一轮受控试测,触发二十条用例两次全对、路由十五条三次全对、一个开放任务盲评薄版胜过无技能基线。
- 但那轮试测只用了一个不暴露型号的前沿端点、触发是显式分类而不是生产环境自动加载、同模型族既生成又评审,所以只算协议本身跑没跑对的证据,不算跨模型的效果证明。
- 「强模型增益可能小」是试测时观察到过度检索被抑制、加上作者先验,没有对照过哪个具体模型。