机会评估:一把先承认自己是经验判断的尺子
一个产品想法摆在面前,问 AI「值不值得做」,很容易得到一份听起来周全、却无法追问依据的优缺点。机会评估要回答更窄的问题:当前证据支持补资料、小试点,还是投入开发?分数帮助比较投入级别,不能证明市场会成功。
三层机制处理三种不同问题:地基门只挡命题自相矛盾、依赖做不到的前提、市场可证明为空;十维评分处理程度差异;逃生舱把有具体申辩的低分机会交人复看。「一个人扛不动」「要牌照」属于程度问题,不放进逻辑否决层。
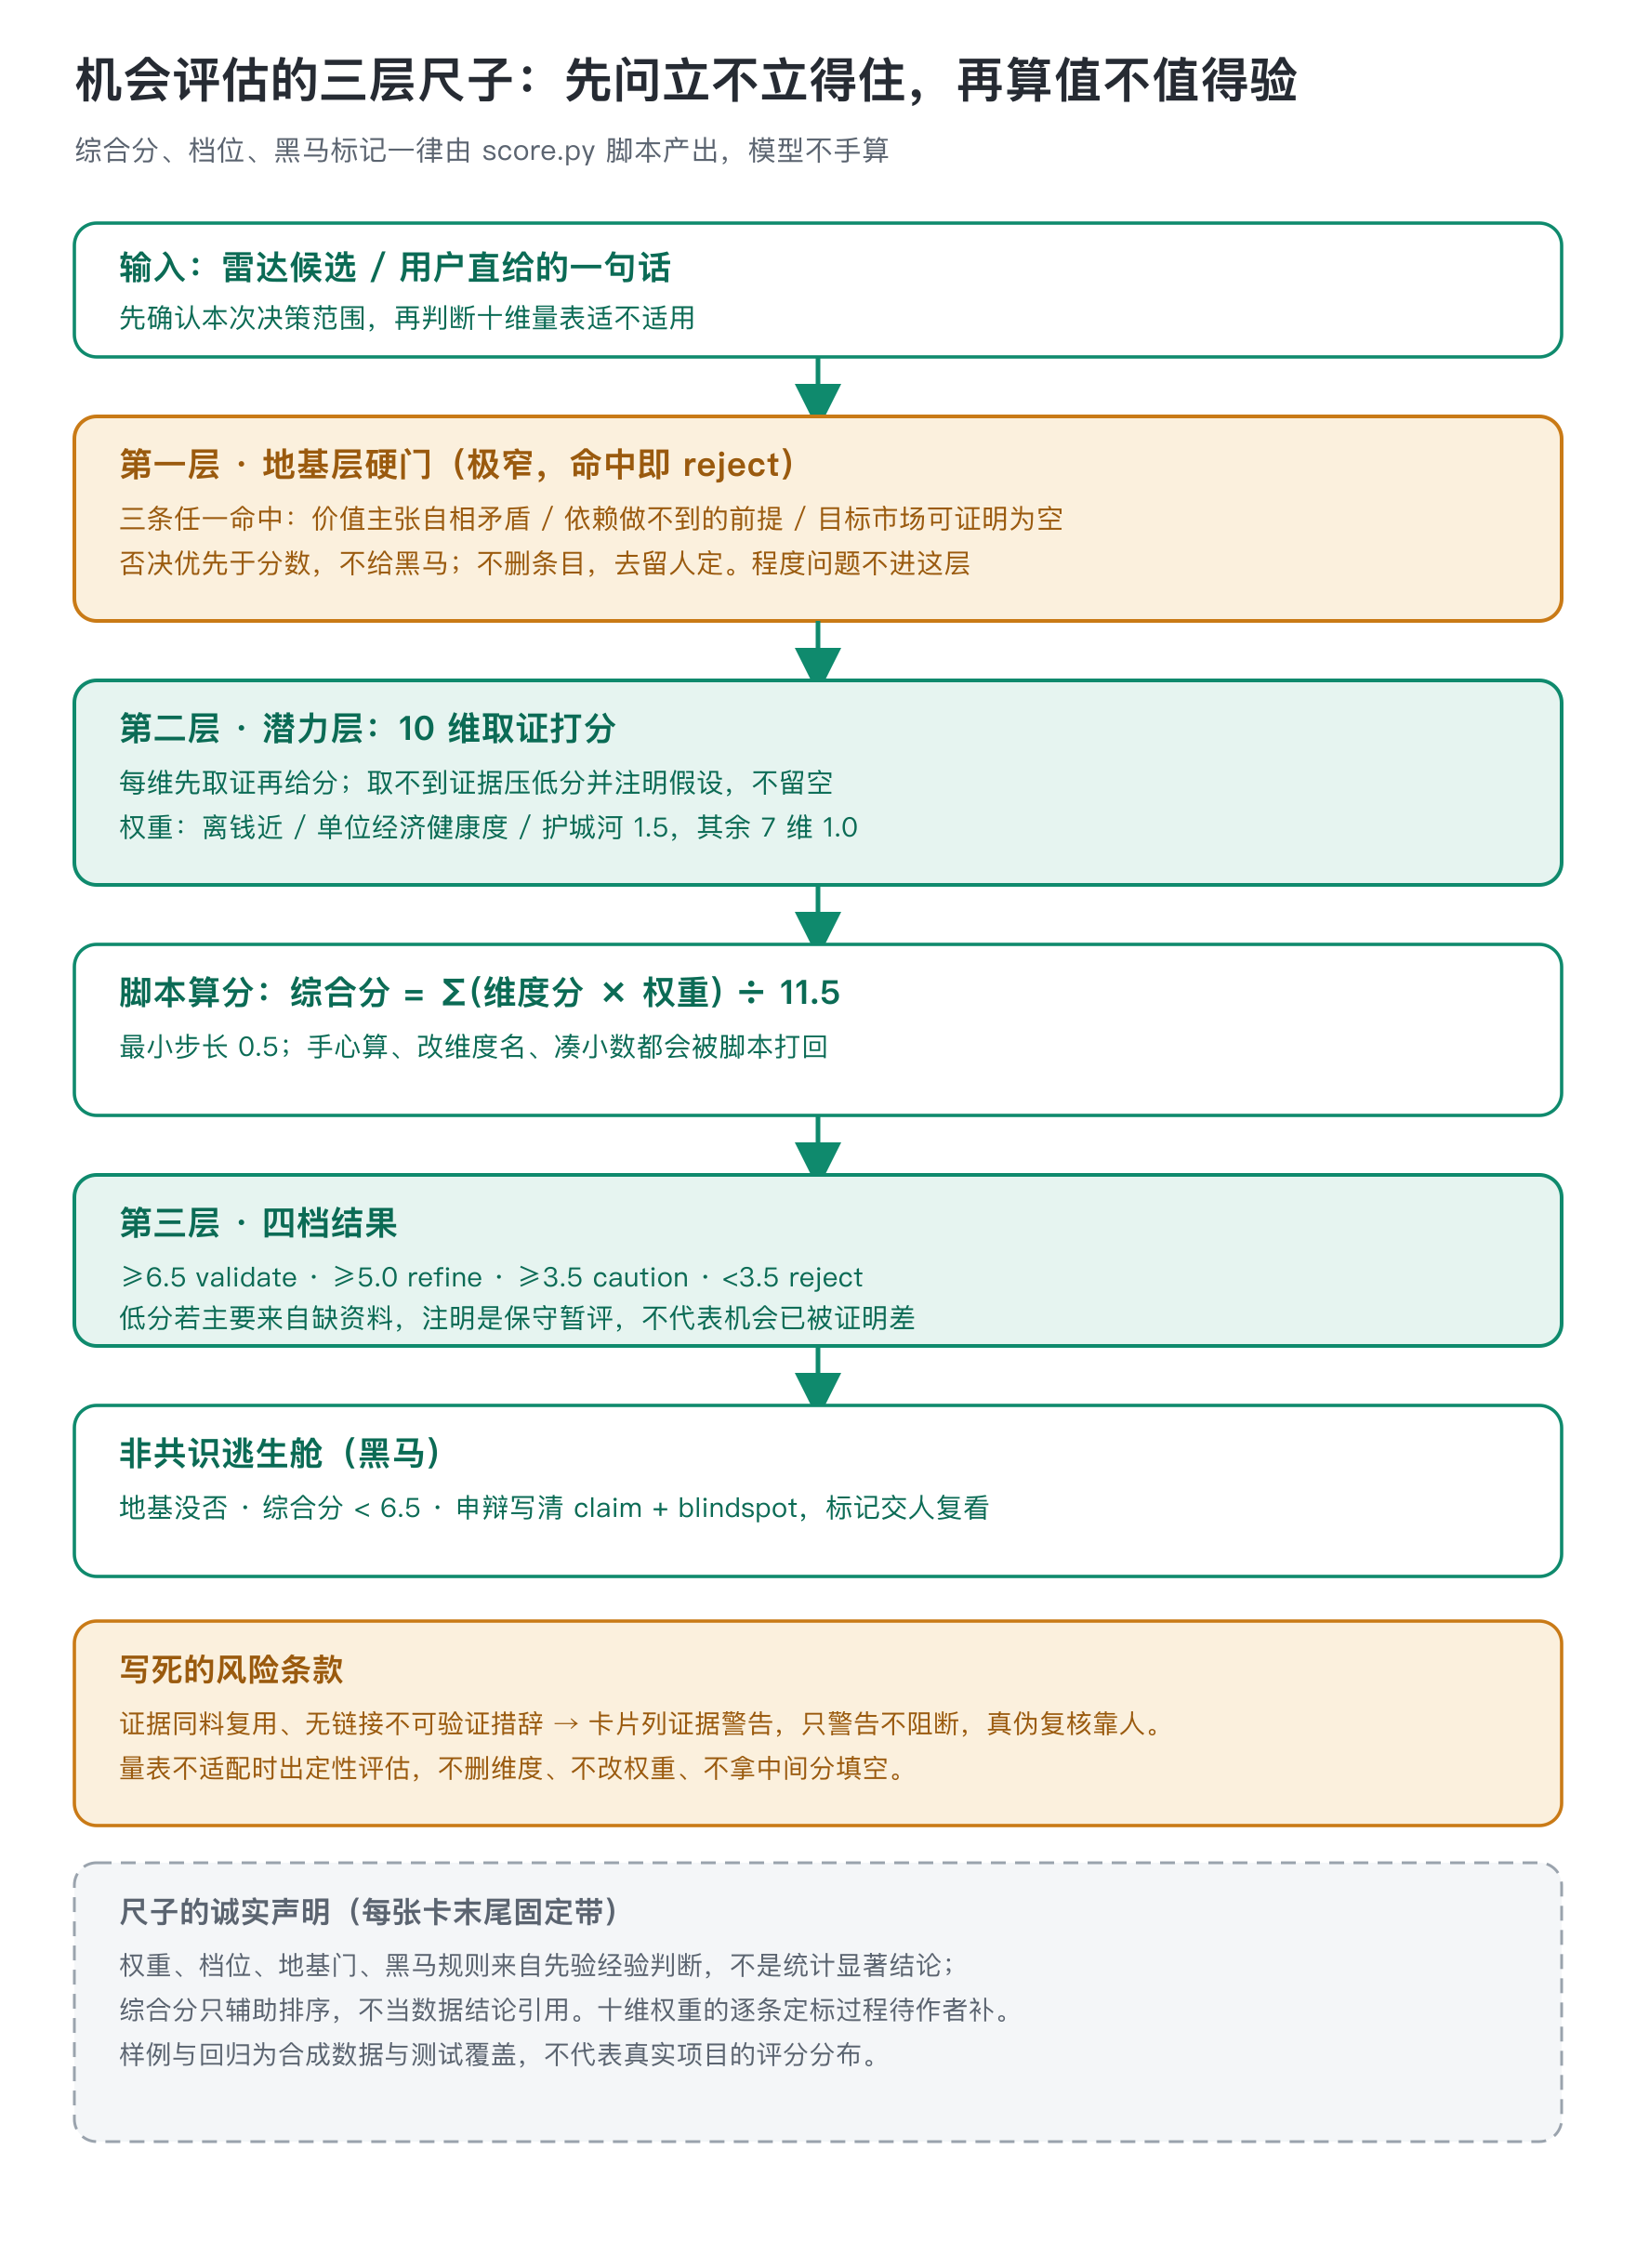
计算可靠不等于判断正确
- 这里有个少见的设计决定:综合分、档位、黑马标记全部由脚本算,模型不手算。
- 理由不是不信任模型,是这三个数是下游机器读的接口,人给自己写的分再算一遍,等于让考生自己登分,职责上不该合一。
- 另一处诚实是每张卡末尾固定带一段尺子置信度声明:权重和档位来自先验经验判断,不是从市场数据里回归出来的统计显著结论,分数只辅助排序,最后拍板的是人。
低分也要说清它是什么。如果低分主要来自缺资料,交付时要注明这是保守暂评,不代表机会已被证明差,补证或低成本实验完全可以翻盘。
先看量表与证据
十维初始权重的逐项形成过程没有记录,现有口径是面向个人产品的先验经验。先检查量表是否适合当前决策,再按固定维度取证:
- 需求与经营:痛点强度、离钱近、单位经济健康度、一人可交付、自然分发。抱怨证明有人困扰,不自动证明愿意付费;重度用户的成本也要单独算。
- 技术与窗口:护城河、市场趋势、可验证性、时机(Why now)、AI-native契合度。热度上升与「现在才做得成」是不同判断,不能重复算同一个优势。
每维先挂链接与原话或数据,再对照 0/3/6/10 锚点给分,步长为 0.5;缺资料写「暂无公开证据,属假设」并保守暂评。离钱近、单位经济健康度、护城河权重为 1.5,其余为 1.0,权重和为 11.5。它们体现经营取向,不是事实可信度;用户偏好另行记录,不混进事实验真。
AI 负责这些语义判断;score.py 负责正好十维、名称一致、证据非占位、topic 合规的校验,再计算综合分、档位和黑马。输入不合规给 JSON 错误信封与退出码 1;地基不成立时直接 reject,不因高分逃逸。
同料复用、无链接的传闻只形成软警告,脚本不验真;十维全无可验证链接时标 evidence_lock: all_unverifiable,不可 clean 引用。计算分工避免算错和接口漂移,不能保证模型给分正确。
合成样例只演示分支
- 口说无凭,跑一个看看。
- 样例目录里六个 JSON 全部明示是合成测试输入,证据栏写的都是「假设:占位验证用」,不能当市场建议。
- 边界样例「黑马」是十维全 5.0,申辩写了一个可被证伪的判断(竞品都做通用工具,细分人群抱怨没人接,落地页两周可测真实点击)和一条信息差(人群分散在小众论坛,社媒监听抓不到)。
- 实跑结果:综合分 5.00,档是 refine(有潜力待补强),dark_horse 置真。
- 机械分没到 6.5 的 validate 线,但申辩有形状,强制交人复看。
- 同时因为证据栏全是「假设」占位,frontmatter 自动带上 evidence_lock: all_unverifiable。
- 另一个边界样例「地基门」是命题自相矛盾(对核心患者永久免费,又靠同一批人订阅养活),但十维分数都不低。
- 实跑结果:综合分 7.11,档是 reject,dark_horse 为假。
- 7.11 的加权分也救不回来。
- 这两个样例合起来就是这把尺子的两头:逻辑不成立的别救,被低估但申辩有形状的别让机械分一刀杀掉。
适用性与资料缺失要分开。维度确实影响成功但证据少,继续给明确标注的保守暂评;重要维度与实际目标无关,转定性评估,不出综合分。不能删维度、改权重或填中间分,让不适配的量表看起来合规。
- 只有一个想法,要判断投入级别:留在本技能,首句写建议行动、暂缓什么、什么证据会改变建议。
- 已有两个成形选项,犹豫 A/B:交 steelman-choice;缺现实反馈可交 minimum-experiment。
- 发现线索交 opportunity-radar;选定后写 PRD 与计划交 product-brief。设计和编码不由 product-brief 承包,也不由评分卡自动启动。
修订针对自欺与误读
- 这把尺子也不是一开始就长这样。
- 版本记录里 0.3.0 和 0.3.1(2026 年 10 月)两个迭代,取向一致:防自欺、防误读。
- 0.3.0 修的是脚本脆点:坏输入不再崩成 traceback;
- 打分步长锁死 0.5;
- topic slug 正则和冻结交接包逐字对齐;
- 卡片信封的版本号从「kit 版本 0.2.2」改回 schema 0.2.0——信封结构版本和技能包版本不是一回事。
- 同时把权重口径诚实化:写明三组权重是先验、没有经验来源,临时改权重是自欺。
- 0.3.1 加的是防误读:结果里固定带 statistical_significance: false 的方法声明;
- 证据对抗自检(同料复用、无链接不可验证措辞)只警告不阻断;
- 补了三个对抗样例(全 10 分不溢出、全 1 分落 reject 不逃逸、维度互相矛盾不崩溃)。
测试只覆盖契约
- 最后说清楚它靠不靠得住。
- 仓库里 18 条回归测试全部通过,覆盖:slug 两边规则一致、0.5 步长、占位词表超集、错误信封形状、三个基础样例的确定性输出、出卡能过冻结版交接校验、卡片含「非统计显著」声明、六个对抗用例不崩溃且警告可见。
- 这些测试证明的是脚本契约——输入坏成什么样脚本会拒、输出长什么样。
- 它们不证明另外三件事:十维权重预测真实结果的效度(没有「哪些 validate 后来真成了」的回测)、档位阈值 6.5/5.0/3.5 的校准(是先验拍的,不是从样本分出来的)、不同打分人之间的一致性(没有盲测)。
- 样例目录里六个 JSON 全是合成数据,不能当市场建议引用。
这就是开头说的「先承认自己是经验判断」的意思。权重是先验,测试是契约测试,两者不是一回事——测试能保证脚本不算错账,不能保证这把尺子量得准未来。它的天花板是「值得去验」,不是「确定能做」,分发这种胜负手要真碰市场才知道,最终靠落地页验证拍板。