说法核查:一句话里混着三种东西,只对事实验真
传言的数据、文章结论、方案承诺,直接问 AI「靠谱吗」常得到整句赞成或反对。问题是同一句里可能混着可验证事实、从事实推出的结论和价值判断;数据对了,也不代表推论成立,偏好更不能用真伪裁决。
所以先拆三堆。事实回答发生了什么、口径是什么;推论回答这些事实能说明什么;价值判断回答什么值得追求。价值不争真伪,但要点明它是否偷偷承担了结论前提。思想资源是事实核查与笛卡尔式系统怀疑,五级名称是本仓自定,不冒充外部量表。
这里借系统怀疑的,是暂缓接受未经检查的前提:一句话说得熟练,或者符合自己的期待,都不增加它的证据。它没有要求先怀疑一切,更没有把「还没验证」改成「大概是假的」。怀疑要落到可查的问题,否则只是换一种口气表达不信。
三类判断分开,是因为它们需要不同回答。统计增长找数据,增长由谁带来找解释,增长是否值得追求还要看目标与代价。若把偏好也塞进事实档位,核查就会伪装成价值裁决;若只查数字,又会漏掉真正影响行动的那句解释。
这套取舍依据当前 SKILL 对事实核查、系统怀疑和推理审计的定义,五级只是本仓的操作口径,不是一项外部认证。见当前设计依据。
先找会翻转结论的事实
核查范围按影响排序:若某条事实为假,主结论会怎样变化?先查最可能翻转结论的一项,避免无差别搜完所有细节,却漏掉关键分母或时间窗口。
核查资源有限,先查哪一项会改变结论,比多查几项更重要。在日活例里,统计对象或同比口径一旦不符,「增长 30%」本身就要重写;发布时间差一天,未必会改变判断。两者都可查,却不该同样优先。
这种排序也有代价:它主动放弃一次把所有细节核完。交付必须保留未查项和影响范围,不能查对一个关键数字,就说整段话全部可信。若用户据此作高代价决定,核查范围要随真正影响决定的前提扩大。
实际查过后,按已证实、基本成立但需收窄、存在争议、证据不足、明显错误给裁决。待外部核查与未执行外部核查是过程状态,未完成时只能暂不可信判定;「暂不判」不等于「已判假」。
裁决描述证据把说法支持到哪里,过程状态描述这轮做没做。两条轴分开,才不会把工具不可用当成事实错误,也不会把「我记得见过」算作核查。已证实仍受统计口径、时间和对象限制,不能越过这些边界替推论背书。
「证据不足」也不是反证。查了材料却无法区分几种解释,只能降低结论强度;可靠来源直接指出原数字不成立,才是明显错误。若可靠来源互相冲突,先展示冲突的定义和时段,不用自己喜欢的一方抹平争议。
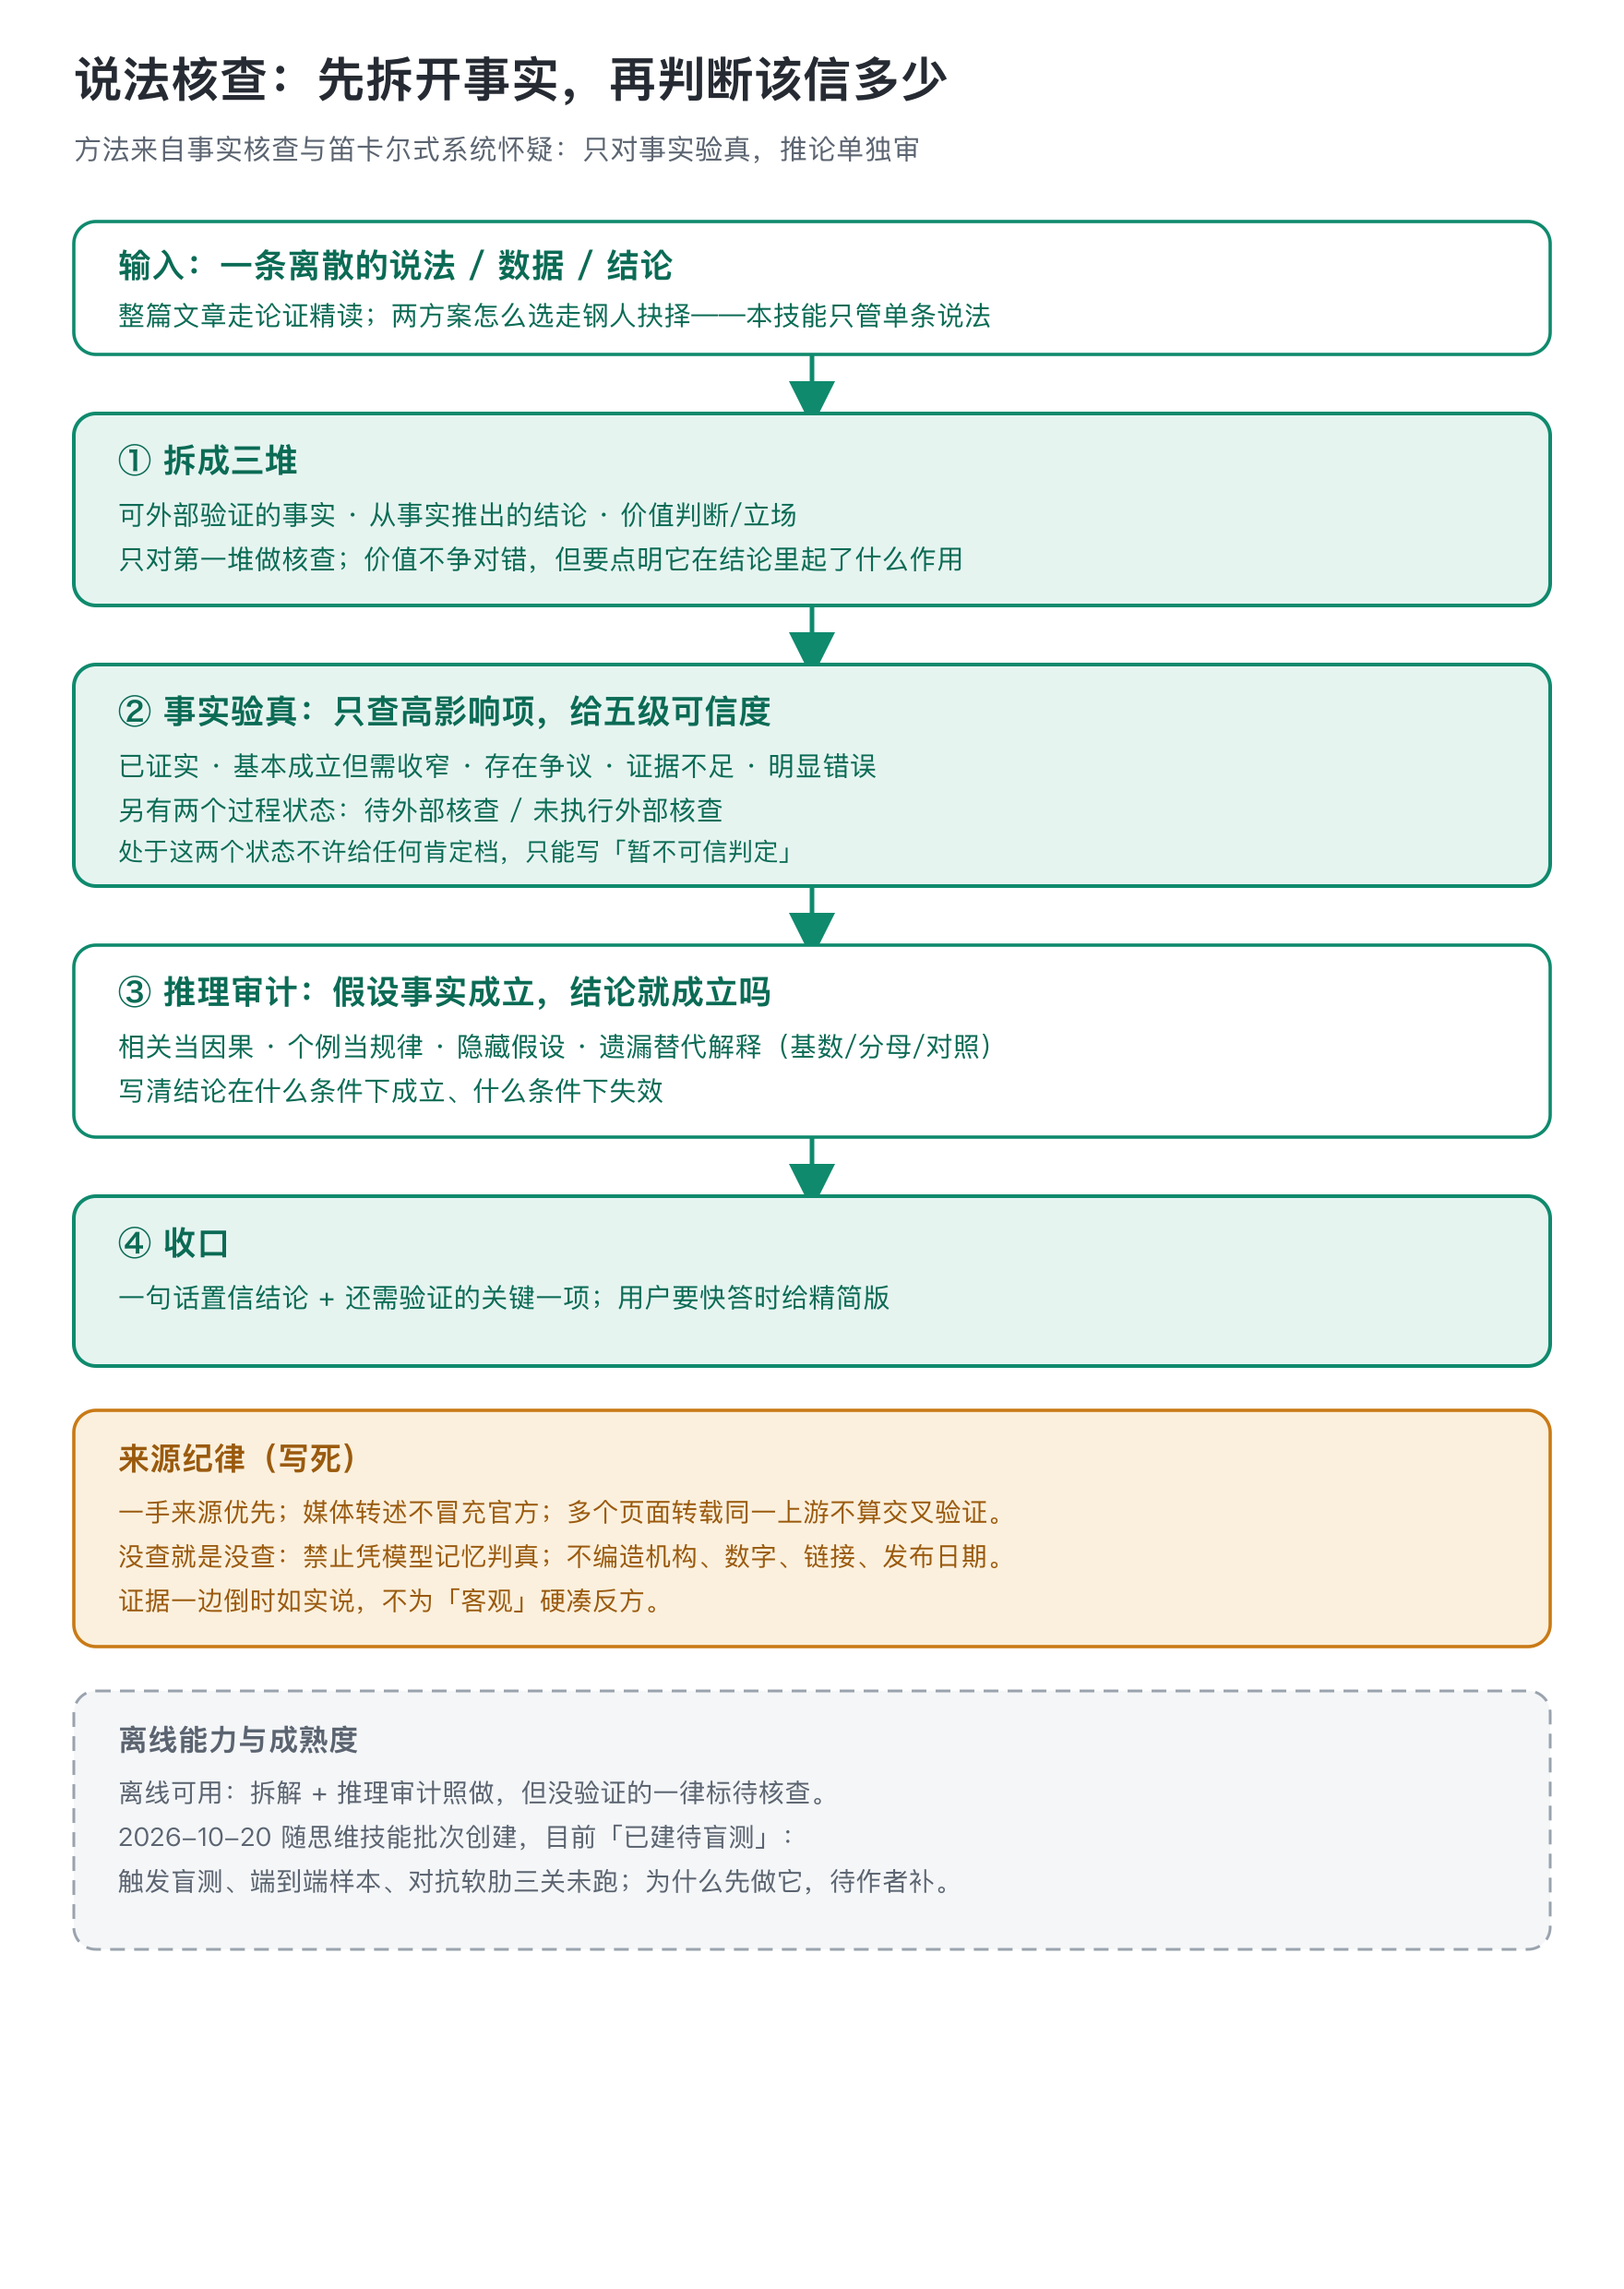
取证优先打开原始数据、报告或当事人原话,记标题、机构、日期和链接,再核对定义、样本、时间窗口。媒体转述只能标转述,多篇转载同一上游不能算独立验证;作者自述、匿名消息和预测保留类型,不能直接判外部证实。
来源独立性关系到错误会不会被重复传播。五篇报道都引同一张截图,增加的是传播次数,不是五份证据;回到截图对应的原始披露,才能看统计口径。官方发布也只支持它实际披露的内容,不能据发布者身份替它补上未给出的回流数据。
离线仍能拆解和审推理,但不能凭记忆给肯定档。查了而证据不足,与本轮根本没查,必须分开记录;这让用户知道下一步需要补材料,还是换来源解决冲突。
数字核实后仍要审推理
事实核完,再暂且假设它都成立,审结论:相关是否被当成因果,个例是否外推,基数、分母和对照是否缺失,有没有其他解释。两步分开,才不会因为一个数字属实就替整句话背书。
暂且接受事实,是为了单独检查解释的承重条件。这样即使外部核查尚未执行,也能指出「若数字为真,这个结论仍缺哪一环」;但文本内推理审计不反过来证明数字可靠。两种工作相互提供问题,证据权限不能互换。
沿用构造例,非真实公司的核查:「某 App 三季度日活同比涨了 30%,说明它重新赢回了用户。」
三分类允许为空,只标出原句实际表达的内容;不能为了把三堆填满,替说话人补出立场。
先看「同比」在比较什么:同一统计定义下,本年三季度与上年三季度的日活变化。这个比较若核实,说明总体活跃增加;「重新赢回」却在描述流失过的人又回来。总体人数和用户身份是不同信息,前者本身识别不了后者。
- 事实:三季度日活同比涨 30%。本例没检索,状态为未执行外部核查,需要先找原始披露及统计口径。
- 推论:增长意味着赢回用户。即使 30% 为真,去年基数、季节性、活动或新增用户都可能解释增长,不能自动推出老用户回流和长期留存。
- 价值:本句没有独立、明确的价值判断。「赢回」可能带有正向倾向,但只能标作可能的隐含倾向,不能当作原句已陈述的立场。这种可能倾向不能替代回流证据,也不参与事实可信度评分。
- 交付:暂不可信判定;较窄的版本是「若口径核实,只能先说该季日活增长」。优先核原始数据,再用回流与留存资料区分解释,缺资料就保留未知。
增长成立,解释仍可能不成立
增长可能来自新增用户,也可能来自回流,或者两者都有;即使回流增加,也未必持续留下。要区分解释,就查用户构成与后续留存,而不是再找一篇赞美增长的报道。去年低基数也可能使同比更好看,这要求保留比较基准,不能只盯百分比。
提出这些替代解释,不是在宣称它们已经发生。它们的作用是证明现有证据还不能唯一选中「赢回用户」。若后来获得同口径回流和留存数据,原解释可以增强;若数据指向主要新增用户,就应收窄或改写。哪些材料能改变判断,要事先说清。
这次演示没有外部检索,所以仍暂不可信判定。留下的方法是先让事实有出处,再让解释有连接;能信到哪一层就说到哪一层,把下一步缩成最影响判断的一项,而不靠一个总分结束问题。
这个技能只管单条说法的验真:要通读一整篇新闻、长文或宣传文案,重建论证链、定位隐藏前提,归 argument-reading;A、B 两个方案都讲得通、要权衡取舍,归 steelman-choice;只有一条离散说法、数据或结论要判断可信程度,才留在本技能。
成熟度边界:这个技能 2026 年 10 月 20 日随思维技能批次创建,目前「已建待盲测」,触发盲测、真实样本端到端、对抗软肋三关都没跑。仓库提交说明称跑过一轮 32 条 query 的路由试测,但用例与脚本未归档,当前不作为可复核的效果证明。初始创建顺序的个人缘由没有记录。