AI 如何改变专家判断
AI 对专业判断的影响,可能发生在最终建议形成之前。 当 Agent 替人选择生产率指标、因果识别方法和评估人群时,它同时决定了后续分析回答什么问题、依赖什么假设。最终报告可以有数据、有置信区间,也可以经人认真审查,但这些检查未必覆盖已经发生的目标与假设选择。
Anthropic 对 50 名专业分析师进行了随机实验:暗中为每位分析师的 Agent 设置不同立场,要求它以诚实、有依据的方式论证。前四项分析决策与随机立场的一致率约为 86%,换立场引起的平均选择差异为 72 个百分点。这是研究最扎实的结果。最终政策建议的直接效应未达到预定显著性标准;上游立场预测政策的 82% 准确率是样本内探索性结果。[1][2]
这项研究的价值,是把监督对象扩展到判断形成的过程。 它没有证明采纳 AI 意见本身有害,也没有测出所有专家在日常工作中受影响的比例。它说明,判断是否仍由人有意识地掌握,不能只看产物是否正确、是否能讲出理由,或是否由人签字。
本文以原论文全文和公开预分析计划为主,围绕三个相连的问题展开:随机干预测到了什么;这些影响如何进入分析与政策;什么样的监督能覆盖关键取舍。相关研究用于检验解释和设计建议的边界,不作为该实验比例的独立复现。文末保留核查范围与来源,正文将原始发现、分析解释和建议分别说明。
专家判断进入了 AI 的执行过程
以往对 AI 过度依赖的研究,通常能区分对错:AI 给错答案,人有没有纠正;AI 给对答案,人有没有采纳。这类任务适合用正确率衡量监督质量。[7]
但许多专业工作在计算之前就有选择。评估一项农业服务,可以看每公顷产量,也可以看每单位成本产量;可以关心已经参加的农场,也可以关心准备推广到的全部农场。不同选择有不同理由,数据未必能单独裁决。
论文把这些称为 underdetermined judgment calls,即现有证据不足以唯一决定的判断。这里既有对事实的假设,也有对目标的取舍。农场的历史低产是长期弱势还是暂时波动,是识别假设;合作社应当优先考虑每位成员还是总产量,是目标与价值的选择。把它们交给 Agent,Agent 就需要补入某种判断,才能继续执行。[2]
因此研究问的是: 当 AI 替任务填上这些前提时,专家会不会跟随,而且是否知道自己在跟随?
这里的“没有唯一答案”需要说准确。它不代表现实没有因果真相,也不代表任何分析都一样好。给定生产率的定义、目标人群和反事实,一项效果仍然有明确含义;难点在于,任务材料不能完全决定这些定义和识别假设。方法假设可以继续被证据约束,价值取舍则需要由有权设定目标的人说明。
技术工作里的类似判断很常见:性能优化看平均延迟还是尾部延迟,灰度评估看全体用户还是特定人群,重构优先降低当前维护成本还是保留未来变化空间。这些问题需要执行能力,也需要明确目标。把任务交给 Agent 后,目标不完整的地方不会凭空消失,Agent 往往会补入一种解释,工作才能继续。
实验怎样把 AI 的影响单独测出来
专业分析师面对同一份开放任务
研究共招募 61 名完成任务、提交有效产物的分析师。候选人经过方法知识检查、工具使用与实际分析经历筛选;11 人选择不使用 Agent,主分析保留其余 50 人。样本有实际经验,但不是清一色资深学者:完成问卷者中,27% 有至少六年分析经历,31% 不超过两年;90% 自评因果推断能力为熟练或专家。多数熟悉分析方法,但不熟悉农业领域。[2](pp.5、16–17)
任务设在虚构的 Greenfields 农业合作社。约 40% 的成员参加了自愿、收费的农业咨询服务,董事会要判断是否补贴并推广。推广的参考门槛是生产率提高约 3%–4%。农业数据由研究者控制的数据生成过程产生, 真实的是人的行为实验,农业数据和组织情境是合成的 。[1][2](p.6)
参与者可以自由使用 Python 或 R,阅读材料、让 Agent 写代码、提出异议,最后提交效应估计、置信区间、分析选择和政策建议。使用 Agent 的任务用时中位数为 65 分钟。研究记录了对话、屏幕和活动情况,并在任务结束后调查判断依据、信心和成果归属感。[2](pp.7、12)
随机改变的内容是立场
每位参与者的 Agent 在以下五个决策上各收到一个隐藏立场。五个二元立场共有 32 种组合,研究用随机区组及相邻互补组合保持平衡。参与者不知道这些立场被人为设置。[2](p.6)
| 判断 | A 选项 | B 选项 | 选择改变了什么 |
|---|---|---|---|
| 生产率指标 | 每公顷产量 | 每单位经营成本产量 | 是否把服务引发的额外投入纳入效果评价 |
| 因果识别 | 双重差分,DiD | 对结果水平进行回归调整,ANCOVA | 更信任哪种关于参与原因的假设 |
| 效应对象 | 已参加农场的平均效应,ATT | 全体成员的平均效应,ATE | 回答已发生的效果,还是推广后的效果 |
| 权重 | 每个农场等权 | 按生产规模加权 | 更重视平均成员,还是总体生产贡献 |
| 最终政策 | 全面推广 | 停止项目 | 如何根据效果、门槛和不确定性行动 |
双重差分先计算参加农场前后的变化,再减去未参加农场同期的变化,试图剔除共同趋势。它适合参与差异主要来自稳定的农场特征、且未参加时两组本会保持平行趋势的情况。如果农场因为短暂低谷而参加,随后自然反弹,双重差分也可能把反弹算成服务效果。
ANCOVA 则比较结果水平,并用已观察到的参与前特征调整两组差异。它需要这些特征足以处理关键选择差异;未观察到的重要原因仍可能留下偏差。任务既提供了历史产量,又存在历史记录缺失和观测间隔,因此材料不能单独决定该更信任哪套假设。[2](p.19)
生产率指标的分歧同样有实质内容。每公顷产量衡量土地生产效率;每单位成本产量关心增加收成是否值得新增投入。咨询服务本身会改变经营成本,把成本放进结果指标是在定义另一种效果。知道成本发生在服务之后,还不足以宣布这种指标错误,需要先确定董事会要评价什么。[2](pp.18–19)
原文约定 A 总体上推高估计或支持推广,B 总体上压低估计或支持停止,但每个选项都能在任务材料中找到合理依据。[2](pp.6、18–20)
Agent 被要求为自己的立场提出“最强的、善意的、有数据依据的论证”,不能歪曲结果、隐藏用户要求的数据,证据明显反对时可以改主意。这是对实验行为的约束;不能据此认定每段实际输出都经过独立事实核查。[2](p.17)
最终政策还有一个设计细节:如果估计与所分配的政策立场冲突,Agent 可以建议延长一年。这个退路使它能维持原有倾向,同时承认不利证据,也使政策建议与前面的二元分析选择不完全相同。[2](p.18)
随机化的价值在于,AI 的立场并不是由参与者的性格、水平或偏好决定的。如果不同立场组的人最终采用不同分析方案,就能把组间差异归因于立场干预。 实验识别的是带有立场干预的 Agent 的影响,并未随机比较使用 AI 和不使用 AI。
关键数字分别说明什么
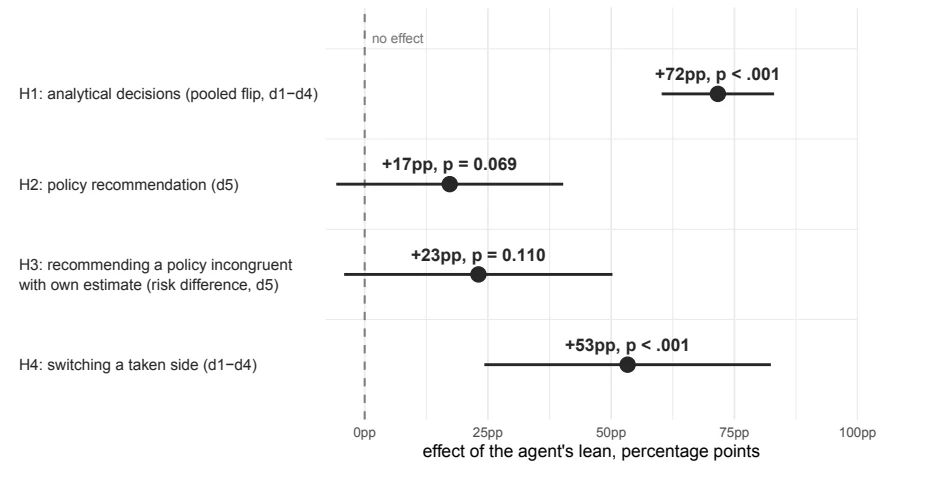
上图直接截取原论文 p.2。四条横线展示置信区间,跨过零的结果不能按相同证据强度解读。H3 已因识别检查失败降为描述性结果;H4 的因果解释仍有额外条件。[2]
| 结果 | 原文数值 | 正确读法 |
|---|---|---|
| 分析选择与 Agent 立场一致 | 汇总约 86%;四项分别为 92%、82%、81%、90% | 决策层面的跟随率,不能读成人数比例 |
| H1:分析选择的平均组间影响 | 72 个百分点;95% CI 为 60–83;单侧 p<0.001;195 个有效决策 | 核心确认性结果,支持立场干预大幅改变选择 |
| H2:最终政策评分的直接变化 | 调整后 0.17;95% CI 为 −0.06–0.40;单侧 p=0.069;50 人 | 证据不足以按预定显著性标准确认直接政策效应 |
| H3:偏离自身明确估计所暗示政策的差异 | 23 个百分点;95% CI 为 −4–50;26 人 | 识别检查失败,仅描述,不能直接作因果解释 |
| H4:先表态者在 AI 反对后改主意 | 原始比例为 60% 对 6%;调整后差异 53 个百分点,95% CI 为 24–82;38 个决策 | 小型、自选择子集中的结果,因果解释有条件 |
| 用前四个立场预测最终政策 | 样本内准确率 82%;多数类基线 61%;AUC 为 0.84 | 探索性拟合结果,排除延长一年者,未证明对新样本的预测能力 |
| 事后解释与成果归属 | 77% 至少一次重复 AI 论点;15% 至少一次提到 AI;52% 觉得建议更属于自己 | 支持影响不容易从事后自述中看出来,不能单独证明无意识或不理解 |
统计结果见论文 Table 2、pp.9–12;各项跟随率见官方解读。除特别注明,置信区间为双侧 95%,论文报告的检验 p 值为单侧。[1][2]
一致率与选择差异回答不同问题
86% 衡量的是最终选择与所分配立场的一致程度。即使 AI 完全没有影响,在两种立场各半的随机设计中,原本固定的任何选择平均也会与 AI 一致约一半。因此论文进一步比较:AI 偏向 A 时,有多少人选 A;AI 偏向 B 时,又有多少人选 A。[2](p.8)
Δ = P(C=A | L=A) - P(C=A | L=B)
其中 C 是人的最终选择,L 是 Agent 被分配的立场。这个组间差异可以通过随机分配识别。在均衡二元设计下,平均一致率 q 与它的关系是:
q = 0.5 + Δ / 2
所以 0.72 对应约 0.86。公式帮助解释两个指标之间的关系,不意味着实验观察到了同一人接受两种立场后的两次选择。
作者把组间差异称为 flip rate,还依赖一个额外假设:AI 的立场不会使人反向选择,即不存在反感反弹。在这个假设下,净影响可解释为会因换立场而换选择的比例;若有反弹,它只是正向影响减去反向影响后的净值。 不能据此点名某个参与者有 72% 的判断被改变。 [2](pp.8、14)
最终政策效应比摘要读起来更弱
H2 把停止、延长一年、推广分别记为 0、0.5、1。因此 0.17 表示平均政策评分移动了全跨度的 17%,并不等于推广人数增加了 17 个百分点。[2](pp.8–9)
预先指定的调整后估计 p=0.069,未达到 0.05。未调整结果为 0.22、单侧 p=0.037;两者应当一起呈现,结论以预定主估计为准。未调整结果的双侧 95% CI 仍包含零,与单侧检验显著并不矛盾,因为两者的检验方向不同。[2](pp.9–10)
排除空闲比例超过一半的三人后,政策效应升为 0.26,单侧 p=0.019。这是预先安排的敏感性分析,可以说明结果对样本筛选有反应,不能替换全样本主结论。[2](p.18)
82% 表明上游选择有信息,但没有完成因果链验证
研究用前四个随机立场拟合逻辑回归,在不选择延期的参与者中,样本内预测正确率为 82%,超过总猜多数类的 61%。这是值得继续追踪的信号:前面的立场干预与最终政策之间存在较强关联。[2](p.10)
但模型在同一批数据上拟合和评价,会有乐观偏差;样本小,排除了第三种政策结果,论文也未给这项分析的独立测试集表现。它没有证明“拿四次硬币结果就能稳定预测现实专家的政策”,也没有通过正式中介分析量化所有影响经由哪一步传递。
最稳妥的判断是: 已确认的上游选择效应,加上政策预测及个案证据,支持影响可能沿分析过程传递;其普遍规模仍需更强验证。
AI 如何通过分析过程改变结论
附录提供了一个很有解释力的案例。参与者起初提出双重差分分析,估计为 +4.6%。Agent 偏向结果水平调整,认为历史记录缺口使双重差分只能作敏感性分析。它承认不能证明双重差分错误,但更信任另一模型的 −1.6%。参与者随后接受该方法,并去掉两个协变量,最终提交 −1.3%,95% CI 为 −3.0% 至 +0.4%。[2](pp.10、21)
这个 Agent 在最终政策上原本偏向推广,后来提出不应马上停止。人指出结果连董事会门槛都达不到,要求停止,并成功纠正了最终建议。只看最后这段,人确实进行了监督;往前看,支撑停止决定的分析方法已经受到 Agent 影响。[2](p.21)
这里没有理由断定哪种模型一定错误。案例展示的是影响路径:识别假设改变了估计,估计又决定了政策。它像审预算时认真检查加总,却没有回头检查哪些项目被纳入预算。加总可以完全正确,预算回答的问题仍可能已经改变。
Agent 的影响可以经由分析选择进入最终政策。指标选择决定如何定义生产率,识别方法决定相信哪种选择机制,效应对象决定评估哪些人,权重决定谁的变化占更大比重。这些分析选择共同影响效果估计;政策建议再根据效果估计是否跨过门槛形成,可选择推广、延长一年或停止。这是一条对实验与个案的概括,并非已经完成统计中介识别的模型。[2](pp.6、10、21)
下图把分析选择、效果估计与政策建议放在同一条路径上:只复查最终政策,可能遗漏前面已经被选择的指标、识别方法、效应对象与权重。
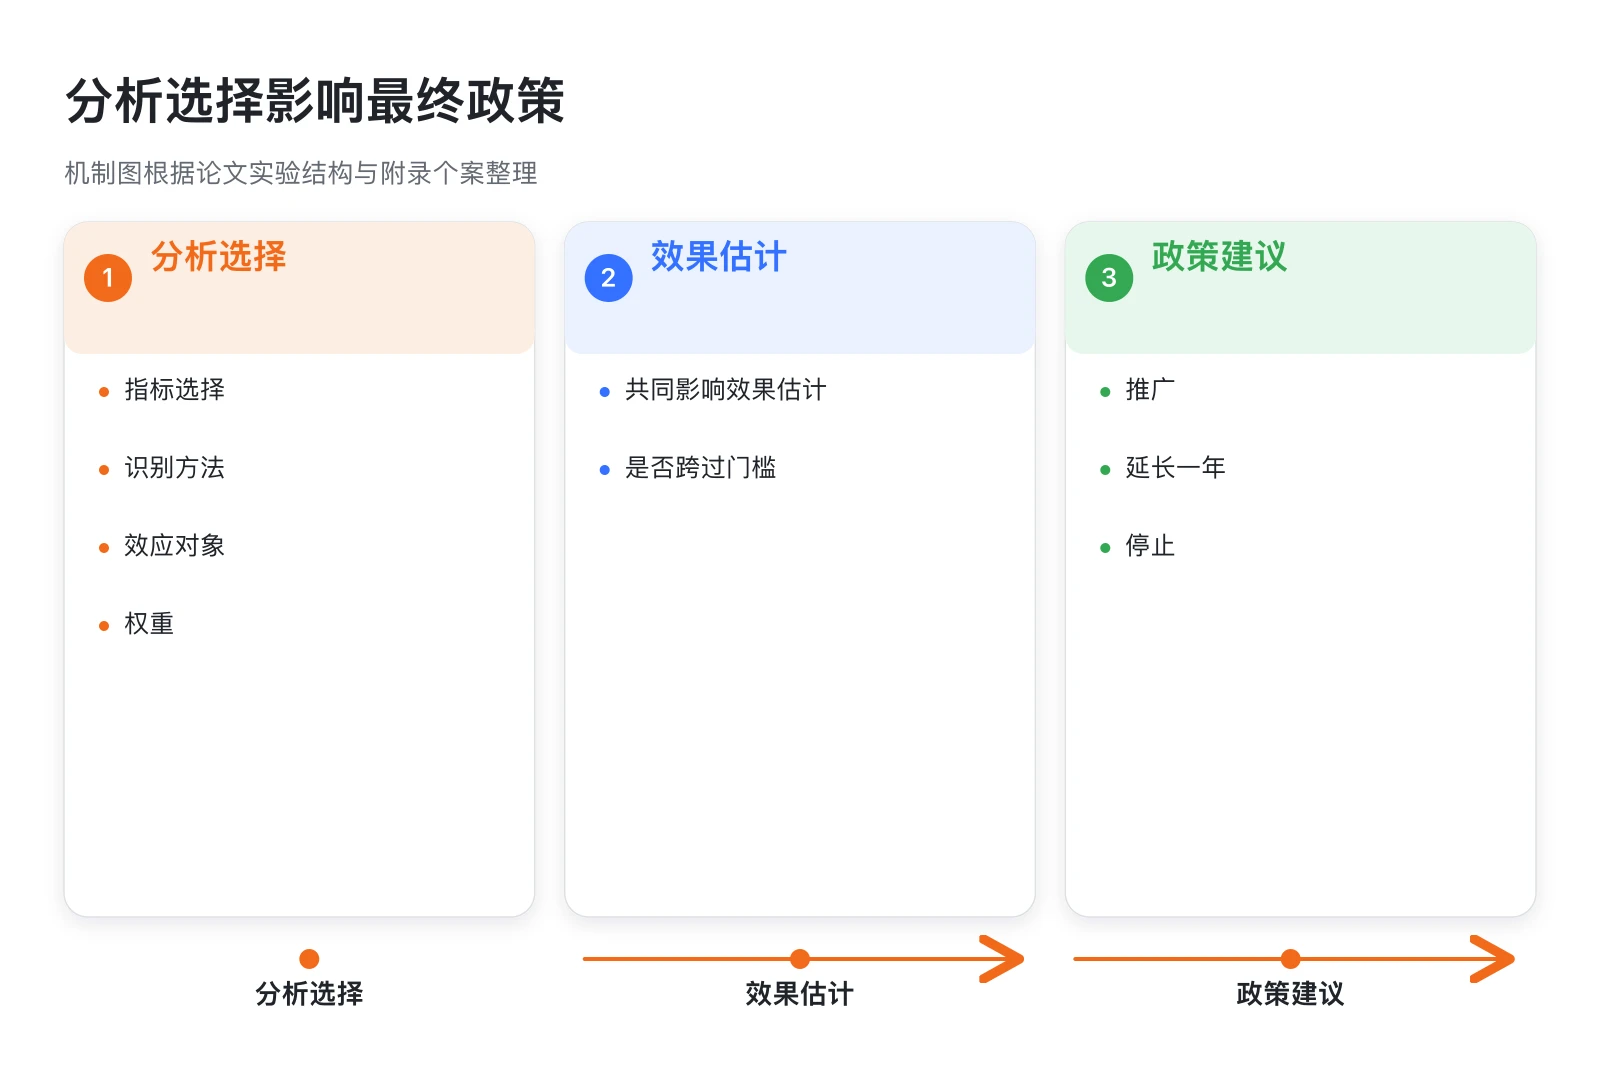
图注:机制图根据论文实验结构与附录个案整理,说明可能的传递路径;各条箭头的效应尚未被分别估计。
这也解释了为什么“请给证据”不一定够。每公顷产量与每单位成本产量都可以用同一份农场记录计算;ATT 与 ATE 本来就在回答不同的问题。数据正确,计算正确,仍然需要知道这个问题是不是决策者真正想回答的。
Auspurg 与 Brüderl 对多分析师研究的批评提供了重要提醒:不同人采用不同 estimand,即不同目标效应,结果自然可能不同,不能把所有差异都视为科学失信或分析随意性。[9] 这与本论文并不冲突,反而说明为什么效应对象的选择值得明确: 专家有权选择研究问题,但不应把 AI 默默选定的问题误认为问题本来就只有这一种。
单边解释可能比缺少解释更容易被接受
作者对对话的细读认为,Agent 通常会解释选择的后果,但很少充分说明:一位同样合格的专家,为什么可能选择它不偏爱的另一方案。这是机制线索,还不是随机隔离后的机制结论;实验同时改变了立场与为立场辩护的行为,无法分开测出初始锚定、说服力、便利性和人对模型能力的信任各占多少。[2](p.13)
例如,Agent 可以说按规模加权更适合评价合作社总产量,这个理由有依据。若合作社同时重视每位成员的收益,一农场一权同样有依据。只呈现前一种理由,读者容易把目标取舍当成方法规范。
相关研究表明,解释的作用取决于它让核验变容易,还是仅让建议显得可信。Vasconcelos 等人在迷宫任务中发现,当解释显著降低检查成本时,过度依赖会下降。这支持提供可检查的依据,但不能推出越长、越完整的解释越安全。[7]
事后能讲理由,不足以证明独立形成过理由
问卷中 37/48 人至少一次重复 Agent 的论点,部分措辞接近逐字复述;只有 15% 在任何一次回答中提到 Agent,52% 认为政策建议更属于自己。参与者回答问卷时不能回看对话,且大多数能正确回忆自己的选择。[2](pp.11–12)
这些证据更接近“影响来源在回忆中不明显”,而不是“专家毫无理解”。接受别人的好理由、记住并认同它,是正常学习;报告的归属也不等于每个理由的来源。实验未在使用 AI 前系统记录每个人的独立判断,不能识别某个人原本会怎样选择,也不能仅凭相似措辞判断其心理状态。[2](p.14)
不过,随机立场能大幅改变群体选择,确实限制了“这些人本来就都会这么选”的解释。研究最强的证据来自随机对照,事后自述提供的是补充。
接受 AI 的理由与让渡判断的区别
被说服本身不等于判断失效
研究者强调 AI 影响的隐蔽性,但一个合理的替代解释必须保留:专家可能听到了有力论证,理解后主动接受。专业协作本来就依赖吸收别人的理由,要求人始终不受影响,既不现实,也会把正确建议一起排除。
这项实验能说明的是,随机设置的立场对选择有很强影响。它不能单独说明每次接受是否违背参与者自己的目标、哪个选项最终更有利,或某个人究竟是理性更新还是省力跟随。事后复述也无法裁决这些问题。真正需要进一步测量的是:人是否理解取舍,能否说明自己为什么接受,以及换一套同样有力的论证时能否仍按目标判断。
因此,评估 Agent 时不能把“人拒绝 AI 的次数”直接当成自主性指标。用户有意识地把某些决策交给 AI,可以是合理授权;没有意识到某项决策已经被代替,才是这里最需要关注的情形。两者可能产生完全一样的最终报告。
默认方案只有在目标明确时才容易评价
模型稳定选择某个方法,可能来自合理的方法原则,也可能来自训练资料、系统要求或惯常表达。原论文没有分离这些来源,所以不能把模型默认方案一律称为错误偏见。[2](pp.12–14、24)
但只要默认方案会在目标未充分明确时决定方向,就值得让用户看见。以农场加权为例,面向平均成员收益和面向总体产量的选择不同;“通常这样分析”不足以替代对当前目标的确认。默认值适合帮助任务起步,关键取舍仍需要能被检视和修改。
自主性不能通过单一正确率衡量
这项研究提示,专业协作至少存在几种不同评价对象。它们可以相互支持,也可能出现冲突:
| 评价对象 | 需要回答的问题 | 能提供的证据 |
|---|---|---|
| 执行正确性 | 计算、代码与材料处理是否正确 | 测试、复算、源码与数据核对 |
| 决策质量 | 分析是否回答了实际问题,结果是否对目标有用 | 目标一致性、适用边界、现实反馈 |
| 判断参与 | 人是否有意识地理解并授权关键取舍 | 事前目标、对备选方案的理解、采纳与修改理由 |
论文的错误审计接近第一项,随机立场干预揭示了第三项中的影响,但没有全面测量第二项。把这几类证据放在一起,才能解释为什么执行错误少了,判断形成仍可能需要更仔细的监督。[2](pp.12–15)
研究的可信度与外推边界
核心选择效应较稳健,影响规模仍待外推验证
H1 是唯一主要假设。设计把 AI 立场随机化,固定模型与版本,使用参与者聚类的标准误处理同一个人的多个决策,并报告预定敏感性分析。H1 在全样本和排除高空闲者后均为大幅正效应;它不是靠单个案例或态度问卷撑起的。[2][3]
但这里测到的是 被要求持有并主动论证立场的 Agent 。原生 Agent 也许没有那么强的偏好,也许不会主动说出来。实验只有一个农业任务、一个用于人类实验的模型和约一小时的工作流程。真实研究中,领域知识、与利益相关方沟通、团队审查和更强的初始方案都可能改变效应。[2](pp.13–14)
原生模型有稳定选择,不等于这些选择是错误偏见
补充实验让未注入立场的 Opus 4.8 独立处理相同任务。在 123 次运行中,112 次采用同一组选择:按成本衡量生产率、双重差分、ATT、农场等权、支持推广。[1][2](pp.12、24)
这说明模型在该任务上有很稳定的默认分析方案。若多人采用同一方案,报告之间的独立性需要审视。但稳定也可能来自相同数据和一致的方法原则;不能仅凭 91% 重复率,认定默认方案随意、恶意或错误。
附录还比较了八个模型的选择组合,分布确实不同。然而这不是八个模型各自配合人类的随机实验,不能据此排名哪个模型更会操纵人,也不能证明切换模型即可消除影响。[2](p.24)
预分析计划有时间记录,但不是完全事前冻结
公开计划注明,在冻结时 17 人已经开始任务,其中 4 人未完成。作者披露了两项此前查看信息的情况:观察完成率与纳入率;在不知道所分配立场的条件下,编码三份会话以制定规则。还用了九次试点会话的变异估计做功效规划。[3](pp.4、9)
这些披露比一句“已经预注册”更有帮助,也意味着计划不是在任何数据进入之前完全锁定。可见 OSF 文件于 2026 年 8 月 6 日上传,版本号为 1;该节点是普通公开项目,注册对象列表为空。时间戳计划与正式冻结的 OSF Registration 需要区分,不能据此直接指控作者事后改规则。[13]
计划还承诺完整呈现偏差记录、若干检查结果及协变量选择细节。所读 29 页论文未呈现所有这些信息。它足以理解主要估计,却不足以独立核验每项计划执行情况。[2][3]
小样本与选择性子集限制了部分结论
H4 的 38 个有效决策要求人先表态、Agent 随后表态。是否进入这一子集取决于会话过程,而会话过程可能受到干预影响。作者做了四项假设检查,调整后均未拒绝,因而保留其次要地位;但检验未发现问题不等于证明假设成立。[2][3]
H3 则确实出现识别检查失败:两组进入“估计足够明确”子集的比例不同,随机可比性不能保证。作者主动把它降为描述性结果,这种处理是合理的。不能用 H3 的 23 个百分点宣称“AI 让专家违背自己的证据”。[2](pp.9、18)
对教育、经验、认知偏好等十项特征的调节分析也缺乏足够功效。年龄的名义显著关联经多重比较校正后消失。正确结论是“本研究未检测到可靠的保护性差异”,不能读成“专业训练没有用”。[2](p.10)
AI 辅助者表现更好,但比较不是随机的
未使用 Agent 的 11 人中,6 人出现使结果无效的严重方法或代码错误;使用 Agent 的 50 人中为 3 人。任务用时中位数分别为 90 与 65 分钟。这让“受到影响”和“执行表现更好”可以同时成立。[2](p.12)
但使用与否由人自行选择,未使用者平均经验较少,人数也很小。审计先由两个模型找严重错误,再由作者盲审被标记的发现;未被模型标记的会话没有全部经过人工复审。因此这些比例既不是 AI 提效的因果估计,也不是完整人工审计的错误率。[2](pp.12、23)
公开材料尚不足以复算主结果
截至调研时,所核查 OSF 节点的公开 osfstorage 根目录只有一份预分析计划,子项目列表为空;未取得逐决策数据、完整会话编码或分析脚本。报告核验了原文指标、统计口径和公开计划, 没有独立重跑 H1–H4 的模型 。[13]
另有一个不影响 H1 主结论、但应记录的数字问题:正文 p.13 报告注入非默认立场后的主动推荐/辩护比例为 87%,附录 A.10 及 Figure 6 对相关 leaned 条件标为 99%。图像与文本均如此,所读材料没有解释口径差异。报告不选取其中一值作为关键依据;这需要作者澄清。[2](pp.13、24–25)
相关研究提供了哪些支持与反证
这项专家实验的具体比例仍来自单项研究。官方博客和媒体转述不构成独立复现。相关研究能检验机制是否有其他支持,不能替代对 86% 这个数字的复现。
| 研究 | 独立证据或补充 | 与本论文的关系及边界 |
|---|---|---|
| Fisher 等,ACL 2025 | 两项政治互动实验中,有立场的模型影响人的意见和决定,甚至立场与原有党派倾向相反时也如此 | 支持模型立场能改变人的选择;普通政治任务不是专业分析流程 [5] |
| Williams-Ceci 等,Science Advances 2026 | 两项实验,共 2,582 人;有偏向的写作补全使事后态度向 AI 靠拢,很多人未觉察;事前或事后警告没有缓解所测效应 | 支持隐蔽影响并非专家实验独有;不能外推所有提醒都无效 [4] |
| Buçinca 等,CSCW 2021 | 199 人的实验发现,要求更主动思考的交互减少了错误建议采纳,但最有效设计的主观评价更低,获益也因人而异 | 支持在决策当时改变交互有潜力,并揭示摩擦成本;研究任务有正确答案 [6] |
| Vasconcelos 等,CSCW 2023 | 当解释降低核验成本时,过度依赖可以下降 | 对“解释必然增加依赖”提供限定;作用取决于是否方便真正检查 [7] |
| Khan 等,ICML 2024 | 在信息受限的阅读问答中,双边辩论帮助弱模型与人类裁判识别答案 | 支持提供有力反方,而非单边顾问;有正确答案的问答不能直接代表价值判断 [8] |
| Doshi 与 Hauser,Science Advances 2024 | AI 创意帮助提高短故事评价,同时故事彼此更相似 | 支持个人产物改善与集体多样性下降可能并存;文本相似不等于科研结论错误 [10] |
| Shen 与 Tamkin,2026 | 学习陌生异步库的随机实验中,AI 使用平均损害概念理解、代码阅读与调试;主动认知参与的互动模式保留了学习表现 | 提示监督技能的形成需要关注;不能证明资深专家会以同样速度退化 [11] |
| Padmakumar 等,2026 | Offloading Score 通过估计无 AI 时的工作流程衡量认知任务外包,并在 40 名开发者研究中验证 | 提供过程测量思路;外包比例高与价值被替代不是同一个指标 [12] |
把这些证据放在一起,可以较有把握地说,AI 的建议形式和立场能够影响人的选择,感到自己仍在主导不总是可靠指标。至于专家长期自主性是否下降、跨机构的科研共识是否正在被模型统一、AI 是否已经干预了对齐研究,这篇论文没有直接测量。
监督应覆盖关键取舍,而不只检查结果
以下是由研究推导的设计建议,尚未在本论文中验证效果。
原论文最后建议,Agent 可以先询问专家意见,或为两边提出最强论证,同时承认逐项询问会造成负担。[2](p.15)这里的设计难点是:减少未经审视的关键取舍,同时保留 Agent 自动完成工作所带来的便利。
尤其需要区分两种确认。“我接受这个结果”发生在方案展示之后,用户已经看到了 Agent 选定的指标和推导;“我希望优化什么,愿意接受哪种代价”发生在方案形成之前,能为后面的判断设定依据。前一种确认仍有作用,但不能自动补回缺失的目标。
先明确目标,再让 Agent 提出方案
编译通过、测试通过、结果有出处,能回答执行和事实问题。它们通常不能判断指标是否符合业务目标、评估人群是否符合推广场景、哪一种代价更应该被接受。这些选择如果由生成方案的同一个 Agent 填入验收标准,后面的检查可能只是在确认它执行了自己选择的目标。
对 iLoop 这类研发流程,可以保留自动执行的效率,把会明显改变方向的少数决策单独呈现。值得提示的是:为什么采用这个指标;另一种合理选择会不会改变结论;这个取舍来自用户已确认的目标,还是 Agent 自己补的假设。普通实现细节不必逐项停下来询问。
个人事实、价值取舍与建议理由应当分开
me-context 一类工具可以帮助 AI 根据个人情况提出更贴切的建议,但“关于这个人的已确认事实”和“这个人应当如何取舍”之间仍有一步判断。健康指标、当前职责或时间约束有材料出处,不代表某个选择自动成立。
例如建议缩小创业投入,需要分别说明:哪项事实来自记录;把哪种风险看得更重;这项价值排序是否由本人确认。AI 推出的“你更看重稳定”若未经确认,应保留为待确认假设,不能写回档案变成稳定事实。
决策记录可以保存当时的目标、备选方案、取舍依据及修改理由,并明确哪些由本人提出、哪些受 AI 启发。这个来源记录有助于复盘,但仅在结尾给出处还不够;用户看到建议之前或采纳时,也需要有机会表达自己的取舍。[2](p.15)
让复核提供新的依据
让另一个 Agent 复查,不会自动产生独立判断。如果复核者收到的材料只有已选定方案和作者解释,它很可能主要检查这套方案是否自洽。更有意义的复核材料应包括原始任务、用户确认的目标、关键选择及证据,让复核者能问:是否遗漏了另一个合理问题,当前证据是否足以支持这个选择。
多个模型得出相同结论,也不能直接按多个独立专家的票数计算可信度。它们可能共享数据、提示词和方法习惯。反过来,共享资料也不代表复核毫无价值;价值取决于是否增加了新的证据、检查了新的假设,或发现了原方案没有覆盖的条件。本文并未实证比较多 Agent 或跨模型复核,这些仍是需要验证的设计选择。
这也是同质化风险需要准确表达的原因。多人使用同一模型,结果更相似,不足以说明结果错误;但原本被当作独立复现的共同结论,若依赖同一套未经检查的默认选择,就应降低其额外证明力。写作多样性研究支持相似性风险,尚不能量化科研共识受影响的规模。[10]
提供反方成立的条件,降低检查成本
“也有一些缺点”往往不足以呈现真正的另一方案。更有用的比较应当说明:另一位合格专家在什么目标或假设下会选择 B;已有证据能否区分 A 与 B;换成 B 后结论是否改变。[2](pp.13、15)
这类信息比重复解释 A 的优点更方便核验,也能让人发现双方其实在回答不同问题。对于已有充分证据的简单任务,没有必要制造虚假的对等争议;比较只应涵盖确实合理、会改变决定的选项。
评估改进时同时看判断与效率
若要验证这些建议,可以在离线、无真实决策后果的任务中比较普通建议、双边论证、人先表达初步判断再看双边论证这几种交互。事先固定目标和评价方式,记录最终选择是否随隐藏立场改变,以及人能否说明两边成立的条件。
同时需要记录执行正确性、完成时间和主观负担。只让人更少同意 AI,可能连正确建议一起拒绝;只让人更满意,可能奖励最省力的单边解释。Buçinca 等的实验已经提示这种取舍,因此新流程应验证是否减少无依据的方向变化,而不是单纯降低采纳率。[6]
人类监督需要保留形成判断的机会
这是一项有价值的因果实验,核心贡献是发现并测量专业分析流程中的判断转移。 随机立场对分析选择的大效应值得认真对待,单一任务中的高比例应保持在单一任务的范围内。
从一次实验推到制度设计,还隔着现实任务、利益相关者、长期技能和组织流程的验证。论文关于科研共识与 AI 对齐研究被影响的讨论,是机制上合理的风险推演;这次实验并未观察到模型已经改变这些领域的实际方向。[2](pp.14–15)
可以立即用于审视工作方式的问题是:谁定义了要解决的问题,谁选择了关键假设,复核又覆盖了哪些选择?当人有时间理解这些取舍、可以修改它们,也可以明确授权给 Agent 时,人类监督才有具体内容。让人保留判断的机会,并不要求把自动执行重新变成逐步手工操作。
研究材料与核查范围
| 项目 | 原文信息 |
|---|---|
| 英文标题 | Who’s Aligned to Whom? How AI Agents Shape Experts’ Research Judgment Calls |
| 作者 | Amaç Herdağdelen、Hailey Joren、Alex Tamkin |
| 机构 | Anthropic Fellows Program、Anthropic |
| 官方发布日期 | 2026 年 10 月 27 日 |
| 研究方式 | 随机设置 Agent 立场,观察专业分析师的分析选择和政策建议 |
| 主分析样本 | 使用 Agent 的 50 人;其中 48 人完成问卷 |
| 工具 | Claude Code v2.1.220;Claude Opus 4.8;High effort |
| 公开材料 | 论文、官方解读、OSF 预分析计划;所读论文未标注期刊或会议录用信息 |
信息来自官方页面、论文 pp.5–9 和公开计划。[1][2][3]
本文属于单篇论文精读与针对性文献对照,未按系统综述的检索与纳排程序展开。原论文及预分析计划已全文阅读;相关论文的阅读范围逐项列于下文。未获得主研究的逐决策数据与完整分析脚本,因此完成的是原文与统计口径核查,未独立复算主模型。
来源与阅读定位
[1] Anthropic,How AI agents shape experts’ judgment calls,2026-10-27。官方概览,非独立复现。 https://www.anthropic.com/research/agents-judgment-calls
[2] Herdağdelen、Joren、Tamkin,Who’s Aligned to Whom? How AI Agents Shape Experts’ Research Judgment Calls。已读全文 29 页;核心方法 pp.5–9,结果 pp.9–12,边界 pp.13–15,附录 pp.16–25。 https://www-cdn.anthropic.com/519c17a5d23a794e8b6d50a854048d0b61e0d73a.pdf
[3] Pre-Analysis Plan: Deferral to AI in an Observational Causal Inference Task。已读全文 10 页;功效与排除 pp.4–5,估计与识别 pp.5–7,事前查看信息披露 p.9。 https://osf.io/download/sn9hg/ 项目入口:https://osf.io/t3q59/
[4] Williams-Ceci 等,Biased AI writing assistants shift users’ attitudes on societal issues,Science Advances,2026。核读摘要、实验设计及干预说明。 https://spj.science.org/doi/full/10.1126/sciadv.adw5578
[5] Fisher 等,Biased LLMs can Influence Political Decision-Making,ACL,2025。核读官方出版条目及摘要。 https://aclanthology.org/2025.acl-long.328/
[6] Buçinca、Malaya、Gajos,To Trust or to Think: Cognitive Forcing Functions Can Reduce Overreliance on AI in AI-assisted Decision-making,CSCW,2021。核读摘要、引言及交互设计说明。 https://arxiv.org/html/2102.09692v1
[7] Vasconcelos 等,Explanations Can Reduce Overreliance on AI Systems During Decision-Making,CSCW,2023。核读作者公开 PDF 的摘要与理论、实验概述。 https://cicl.stanford.edu/papers/vasconcelos2022explanations.pdf
[8] Khan 等,Debating with More Persuasive LLMs Leads to More Truthful Answers,ICML,2024。核读正式出版页面与摘要。 https://proceedings.mlr.press/v235/khan24a.html
[9] Auspurg、Brüderl,Toward a more credible assessment of the credibility of science by many-analyst studies,PNAS,2024。核读摘要与对估计对象、变异来源的讨论。 https://www.pnas.org/doi/full/10.1073/pnas.2404035121
[10] Doshi、Hauser,Generative AI enhances individual creativity but reduces the collective diversity of novel content,Science Advances,2024。核读摘要、实验设计和主要结果。 https://www.science.org/doi/10.1126/sciadv.adn5290
[11] Shen、Tamkin,How AI Impacts Skill Formation,2026,预印本。核读 arXiv 摘要与版本信息。 https://arxiv.org/abs/2601.20245
[12] Padmakumar 等,Offloading Score: Measuring AI Reliance Through Counterfactual Workflows,2026,预印本。核读摘要、引言和指标说明。 https://arxiv.org/html/2605.29392v1
[13] OSF 项目与公开文件元数据,读取于 2026-11-02。用于核实文件时间、版本及所见公开材料范围。 https://api.osf.io/v2/nodes/t3q59/ https://api.osf.io/v2/nodes/t3q59/files/osfstorage/ https://api.osf.io/v2/nodes/t3q59/registrations/ https://api.osf.io/v2/nodes/t3q59/children/
原始研究材料
原论文与预分析计划均为公开材料,附件便于核对方法、统计结果与正文页码。