ai-briefing 的来路:把 AI 外部摄入变成每天的固定动作
每天都能刷到很多 AI 新闻,但同一发布被反复转述,营销热度又容易盖过真正的变化。持续了解外部进展,需要固定的筛选方法,不只是每天多读几条消息。
所以做了 ai-briefing:把采集、核验、筛选和交付连成日常流程,目标是五分钟读完,留下与读者有关的变化。
筛选流程
先把来源整理成事件,再决定哪些事件值得放进早报。相同发布的官网、媒体报道和转帖可以互相核验,但只算一件事。
| 环节 | 怎么做 | 解决什么问题 |
|---|---|---|
| 定时间窗 | 工作日取过去 24 小时,周一覆盖周末约 72 小时 | 不把旧闻当成当天变化 |
| 多渠道采集 | 读取 GitHub Trending、公开媒体及可用的 X 来源 | 不被单一信息源牵着走 |
| 核验与合并 | 核对来源、时间与数字,同一事件合成一条 | 减少误传和重复摄入 |
| 按读者筛选 | 说明变化的相关度、接入方式和实际增量 | 把新闻热度与行动价值分开 |
| 固定版式交付 | 候选整理成结构化输入,再渲染为卡片 | 让每天的阅读成本稳定 |
重要事实要交叉确认,多家转同一通稿不能自动算独立证据。只有单源或传闻时须明确标识;拿不准就不收。通常八到十四条只是密度参考,没有可靠材料的组可以写“今日无值得报的”。
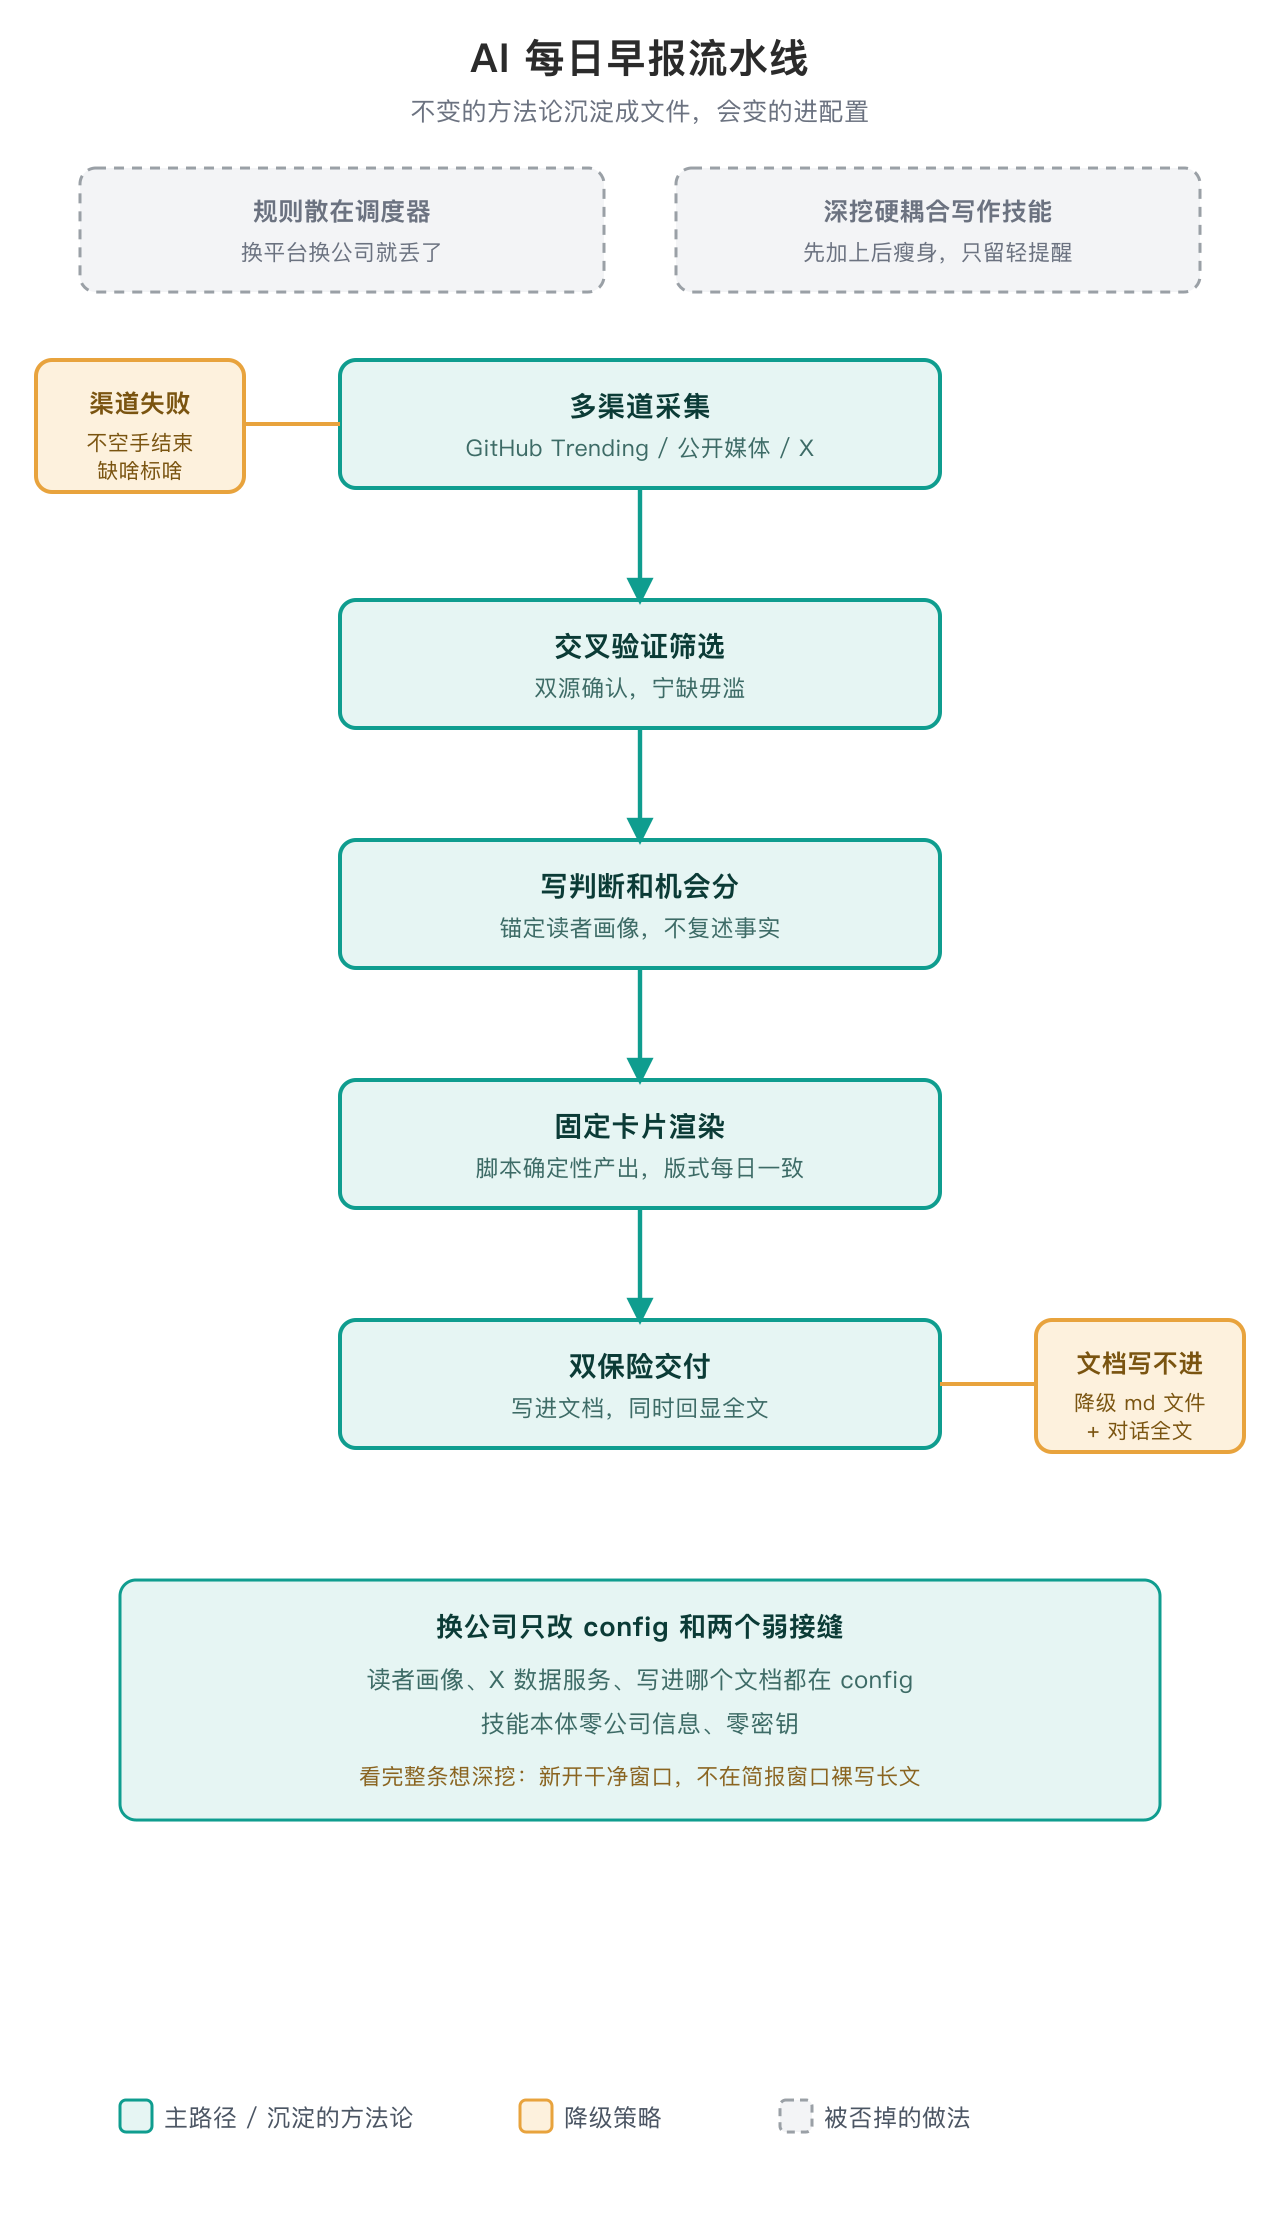
下图把采集、核验、判断、渲染和交付串起来,侧边是渠道失败与文档写入失败时的降级方式。
新闻卡片
卡片分成三层。事实必须可核对,判断和机会分则与具体读者有关。
| 层 | 放什么 | 回答什么 |
|---|---|---|
| 事实 | 发布内容、来源数字、链接与时间 | 发生了什么 |
| 判断 | 变化对读者工作或决策的影响 | 为什么与我有关 |
| 机会分 | 结合相关度和实际条件给行动建议 | 本周要不要试,先验什么 |
以原稿的虚构模型发布卡片为例:上下文和价格属于发布信息;“任务综合成本可能变化”是判断;“纳入模型对照实验”才是行动建议。厂商自报价格不能证明自己的任务更便宜,还要看缓存命中和任务成功率。
换成没有模型路由需求的读者,同一事件可以降低机会分,甚至不收。分数服务读者,不给新闻热度排名。
配置与交付
稳定的筛选方法放在技能里,读者画像、关注账号、X 取数方式和文档位置放在 config.json。迁移时调整配置和适配方式,不把公司信息、个人信息与密钥写进技能本体。
- 渠道失败:按可用能力降级,改用可核对的公开来源,并标明缺了哪些渠道。
- 文档写不进去:仍交付完整正文,降级为 Markdown 文件与本次输出。
- 周复盘:由配置指定日期,默认周五,补整周 GitHub Trending。
渲染脚本负责固定版式,不替代核验和判断。当前方法只做同一期事件合并,不读历史早报做跨日去重。
使用与边界
直接说“出今天的 AI 早报”即可;没有配置时,使用匿名技术读者、公开渠道和 Markdown 交付。需要定时出报,再由宿主的计划任务唤起,技能本身不负责调度。
五分钟是阅读成本目标,解析和渲染测试不能证明读者效果。某条消息需要深入调研时,另开研究任务,不能把简报卡片直接拉长成结论未经补证的长文。
已有早报文档可查看具体内容。日常带走的是这套顺序:事实先核对,价值按读者判断,最后再决定是否行动。